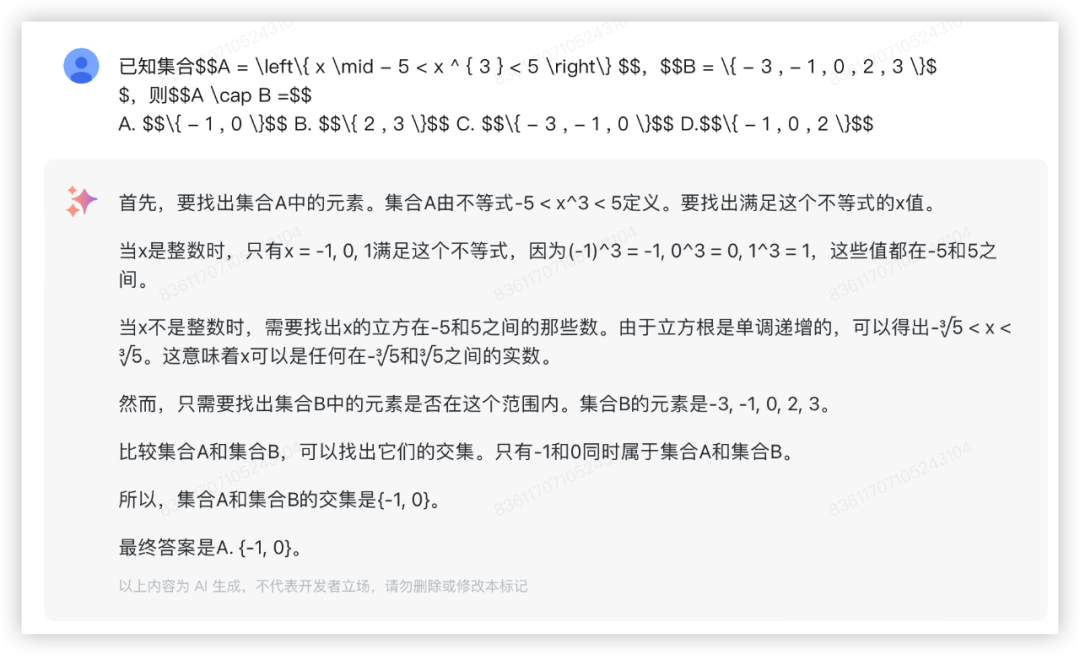
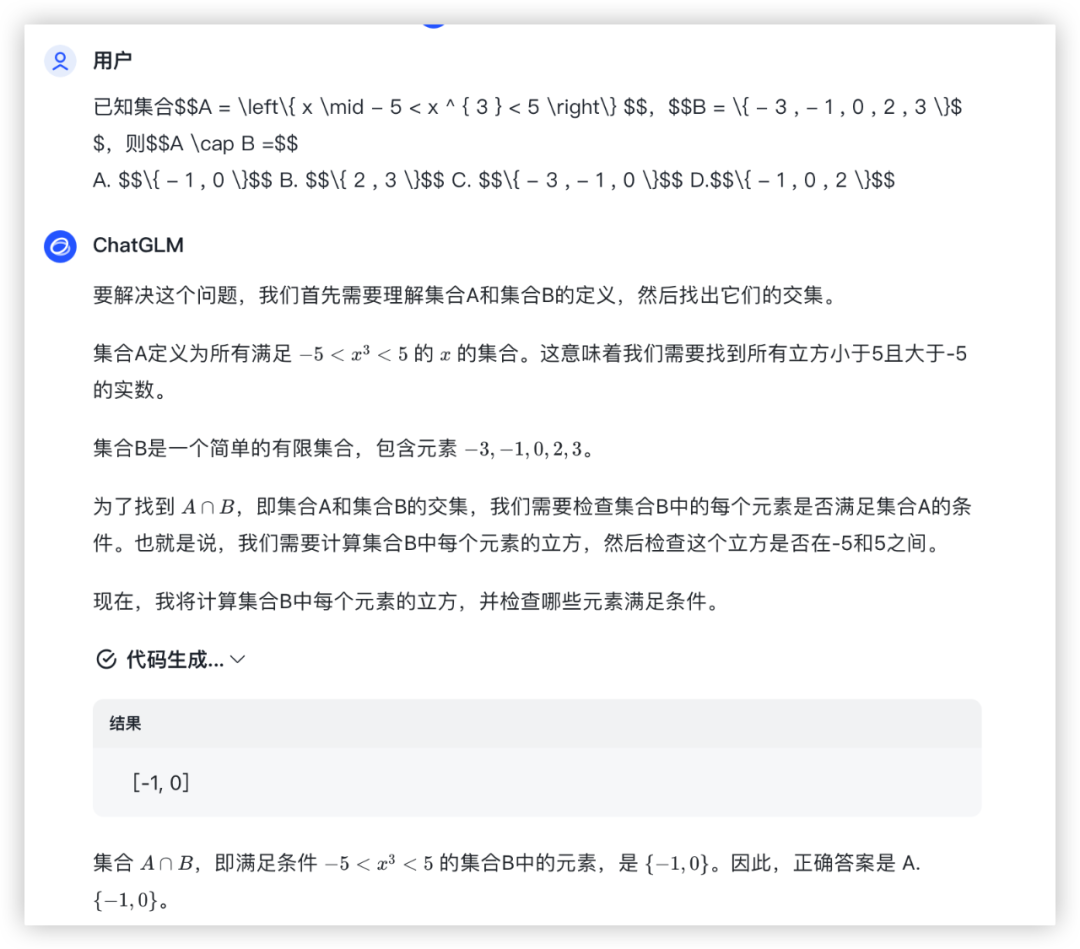
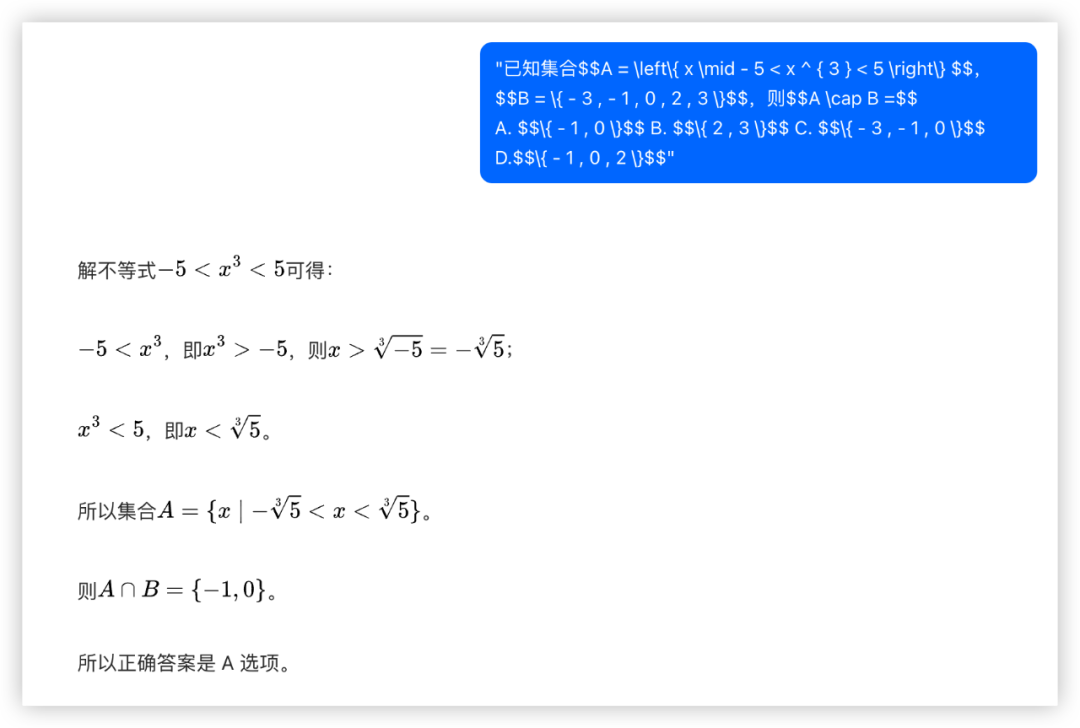
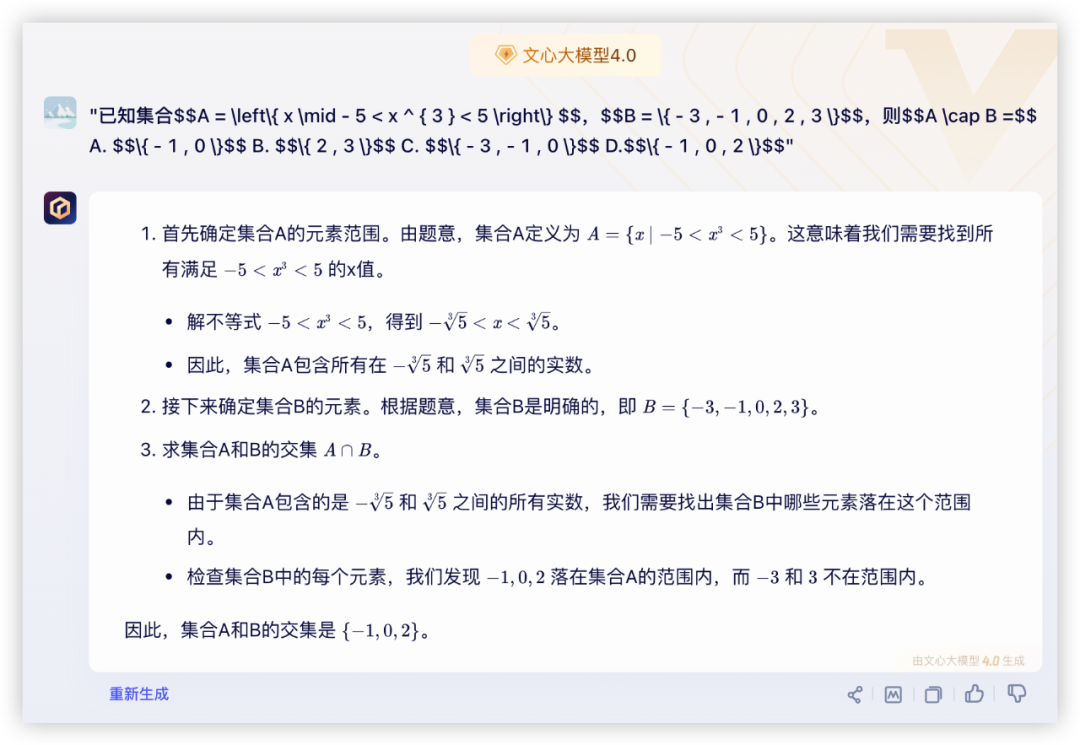
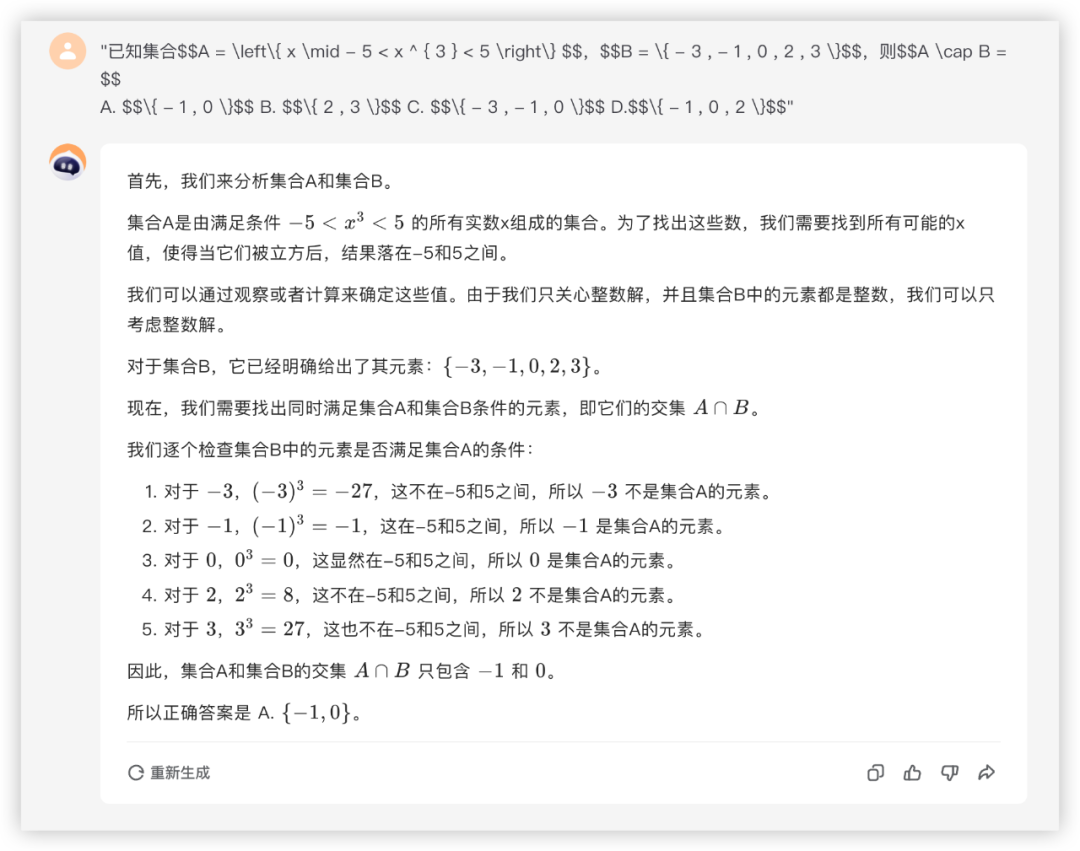
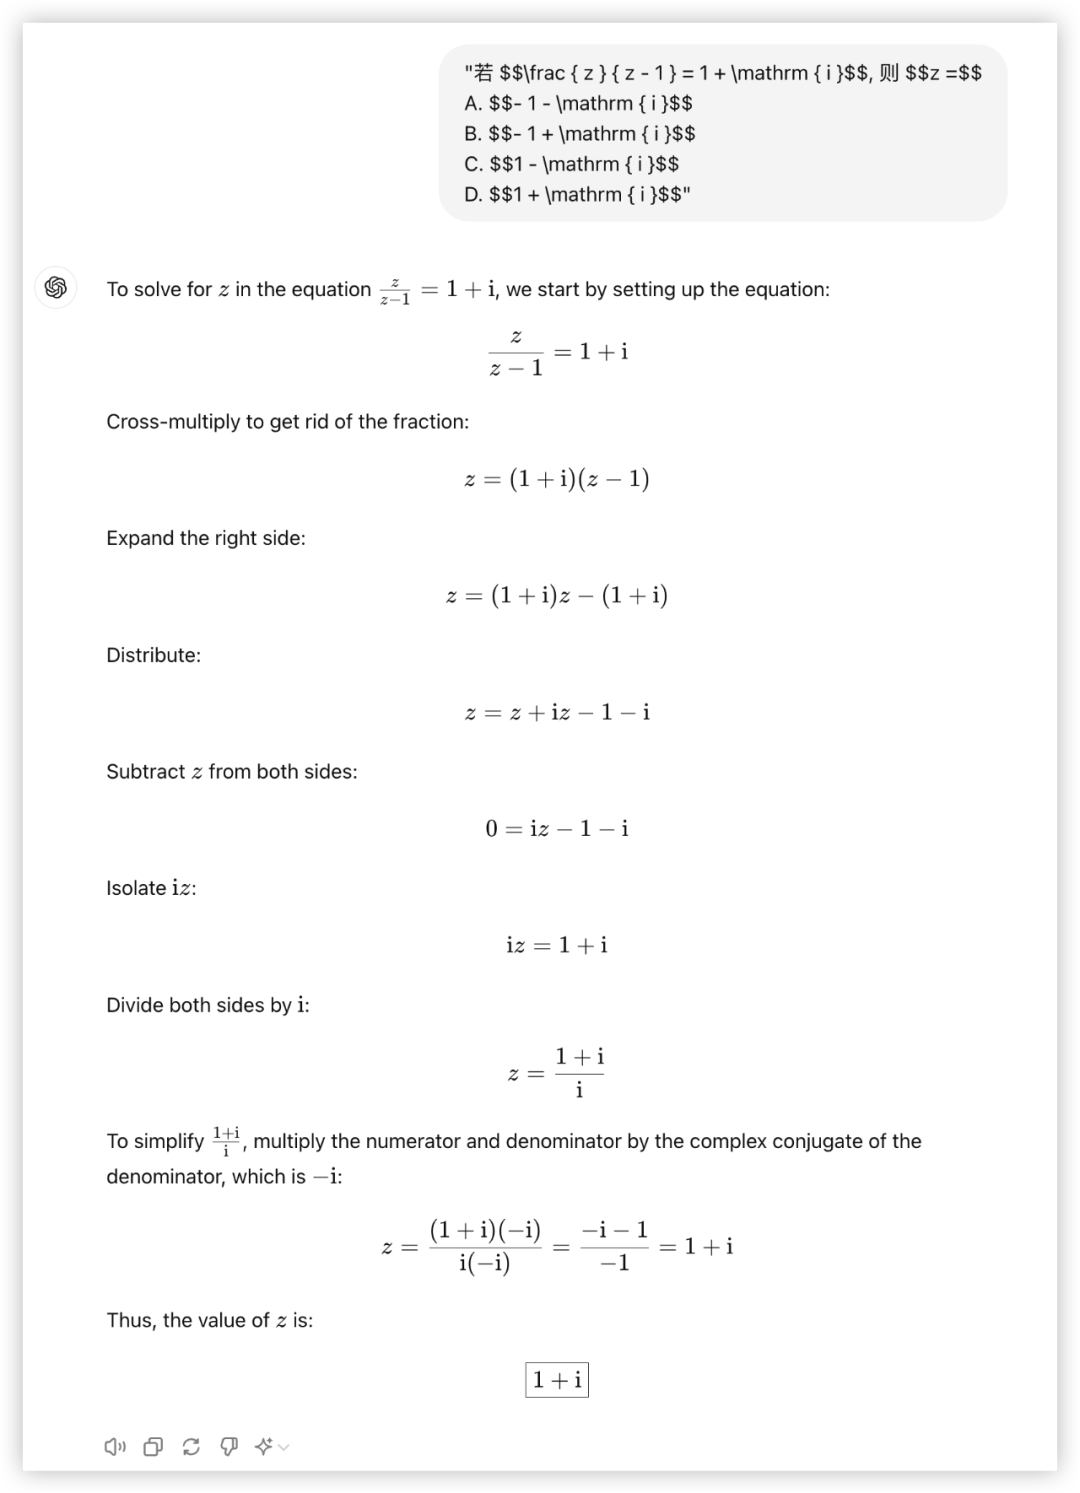
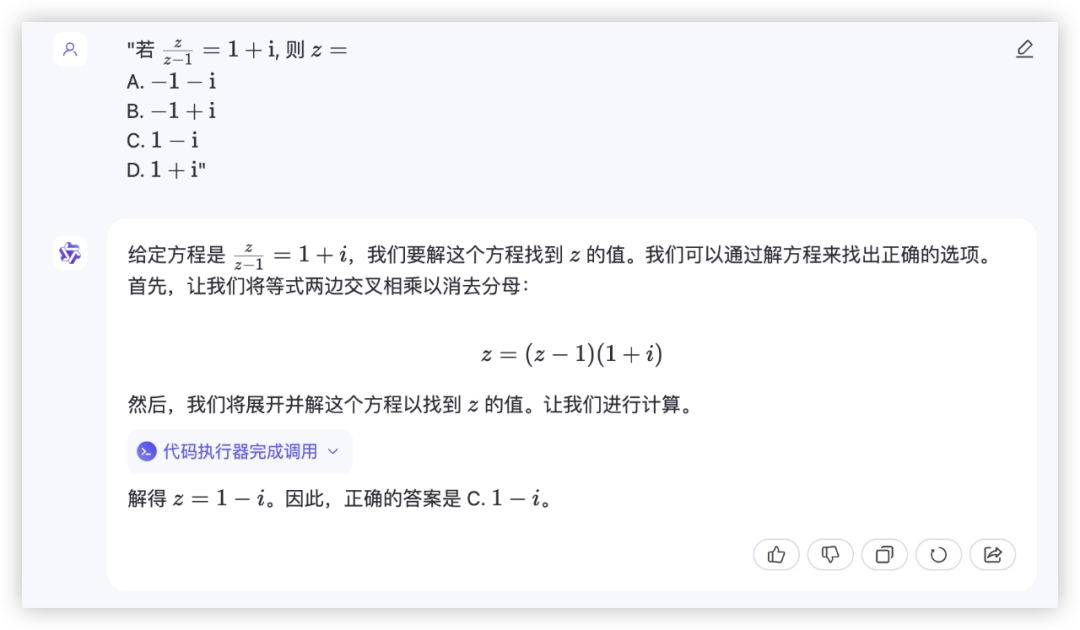
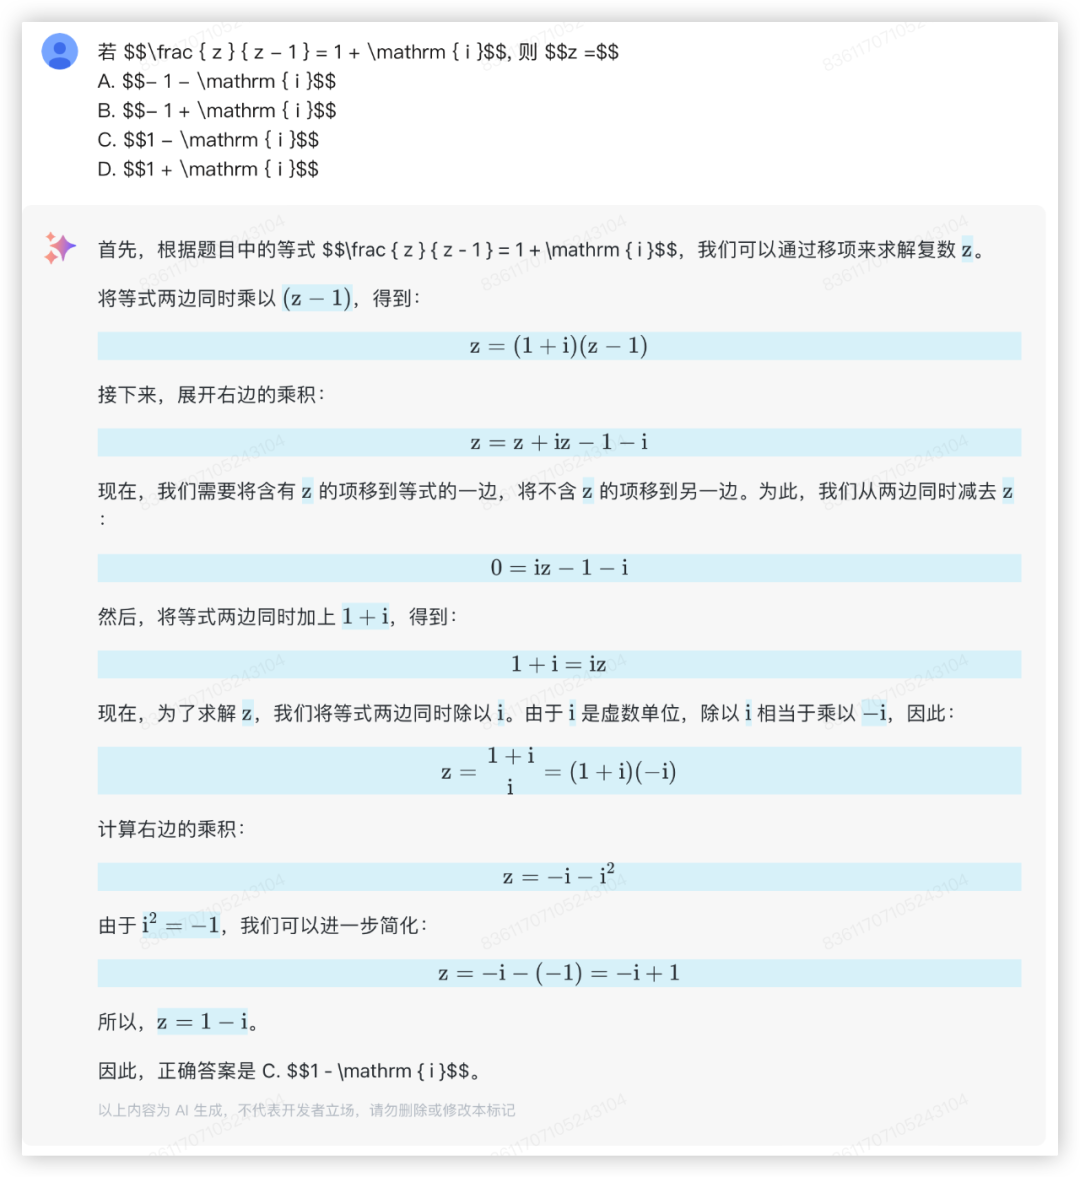
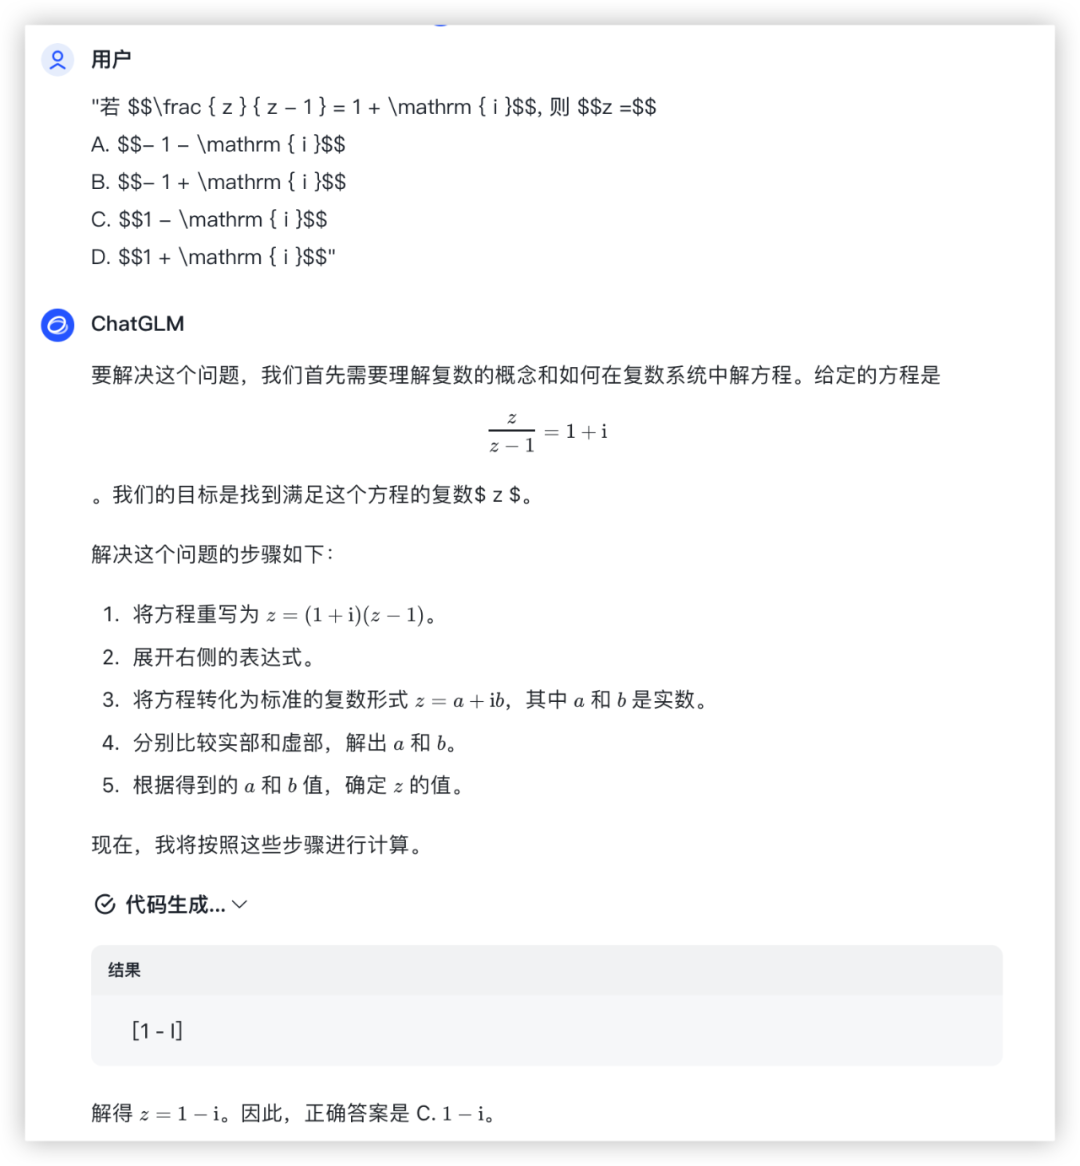
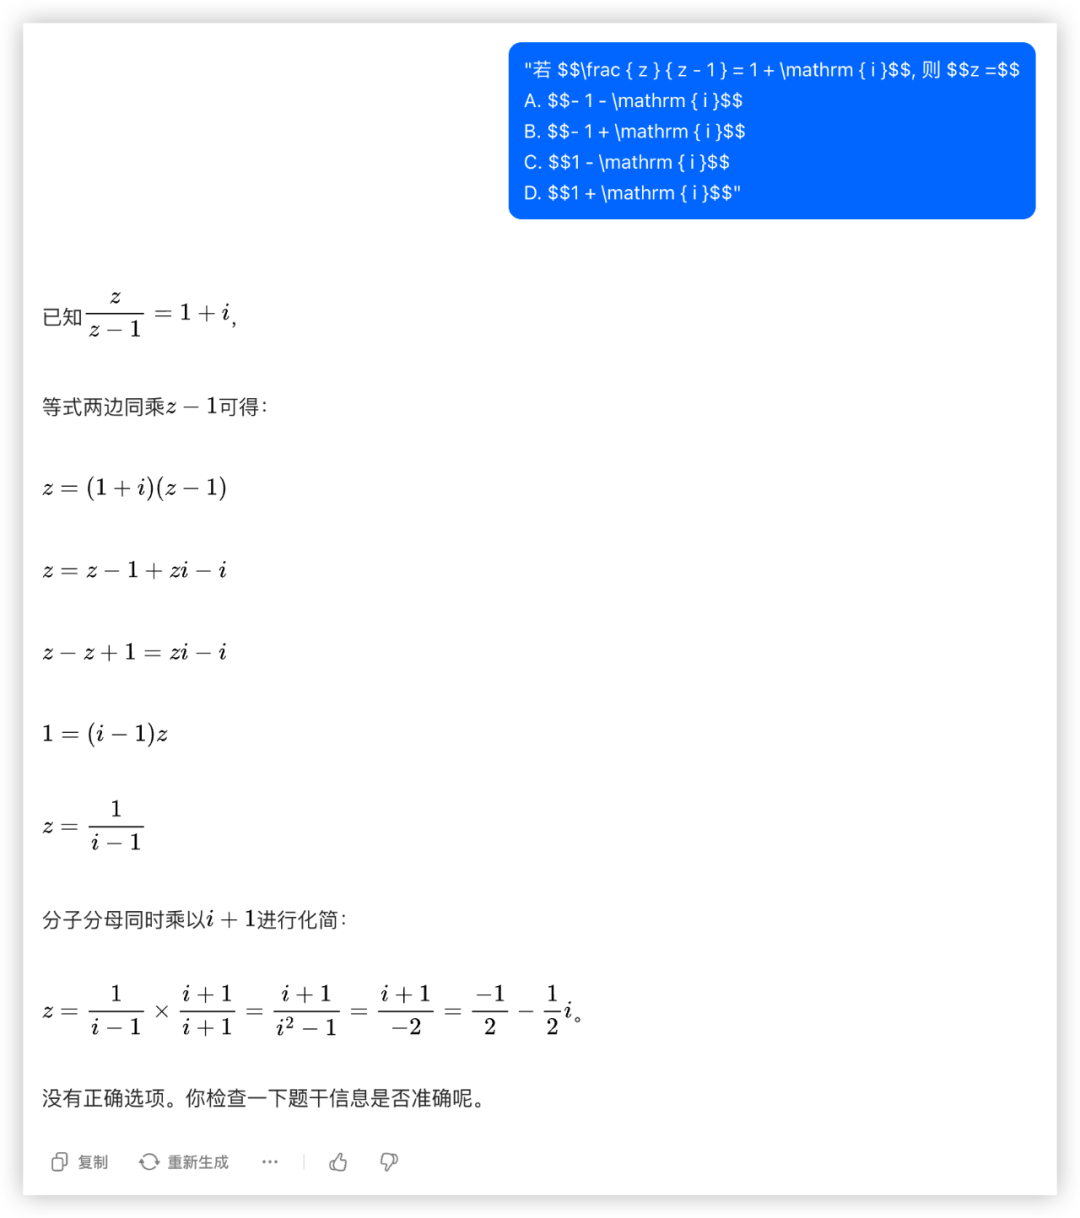
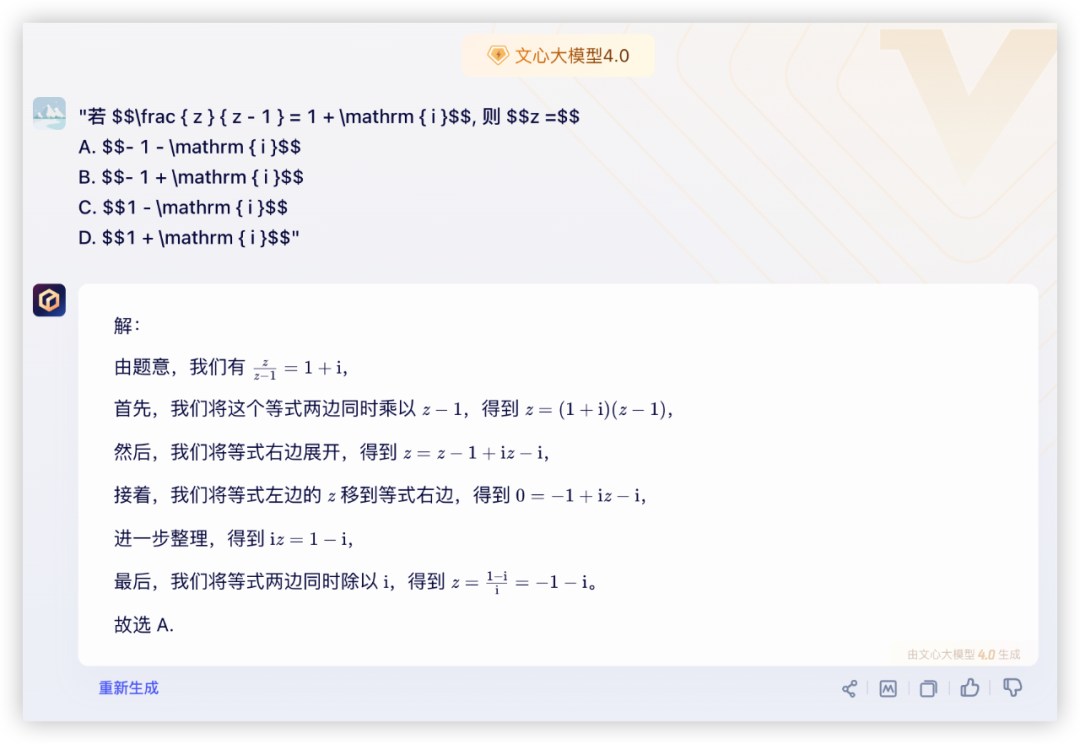
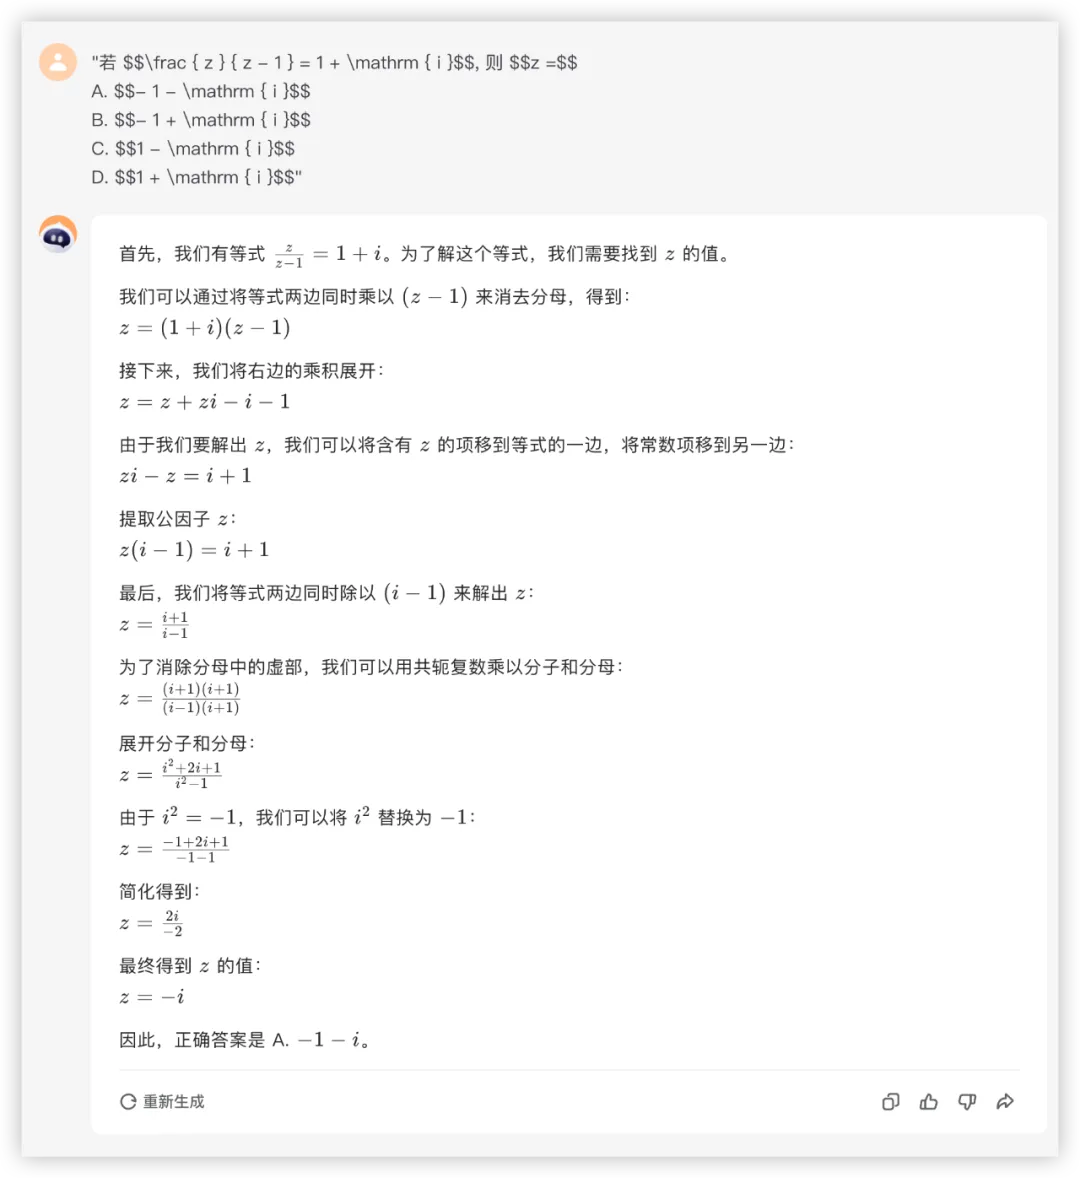
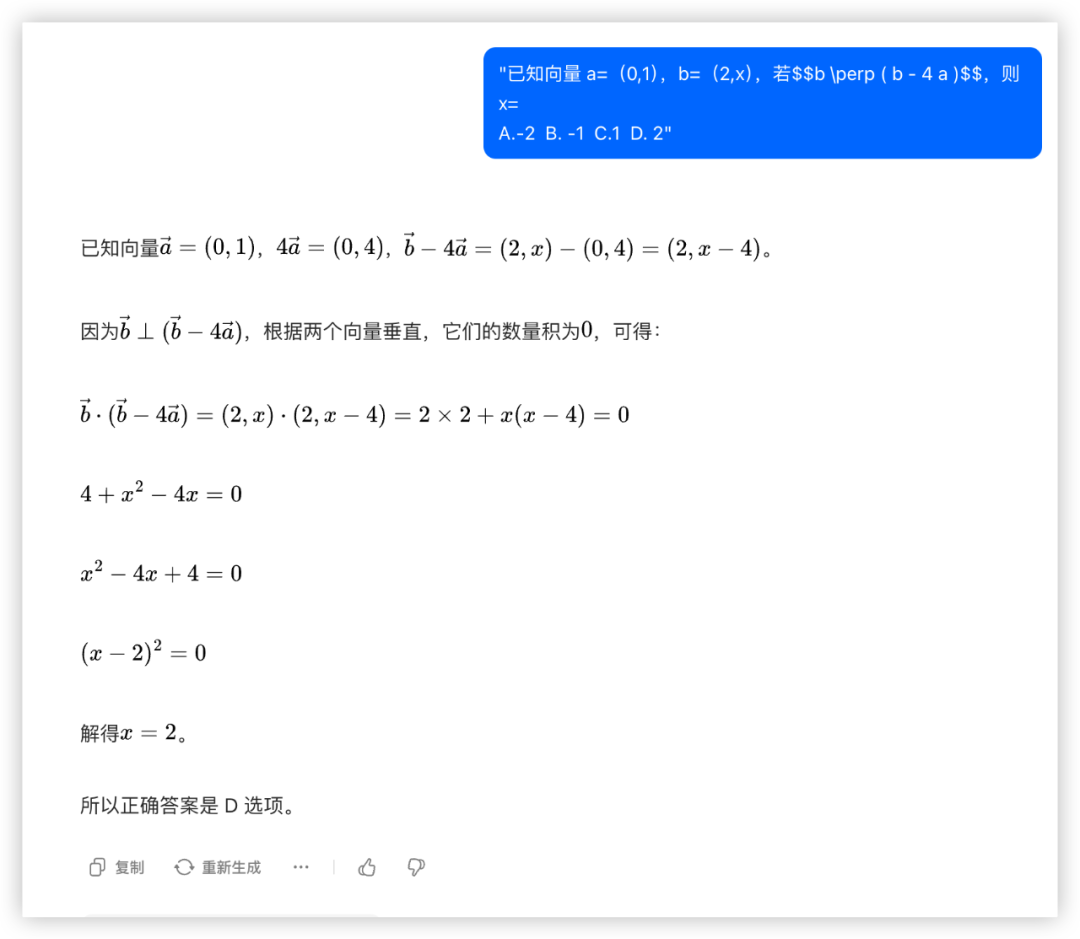
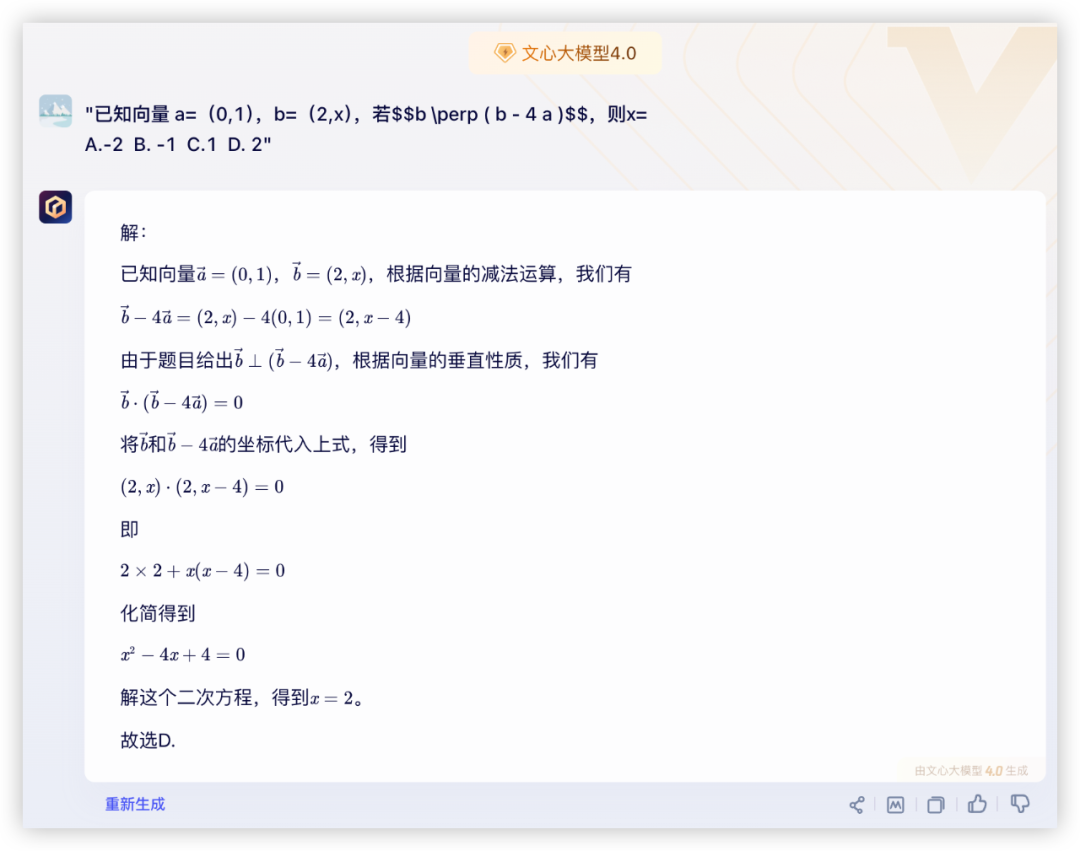
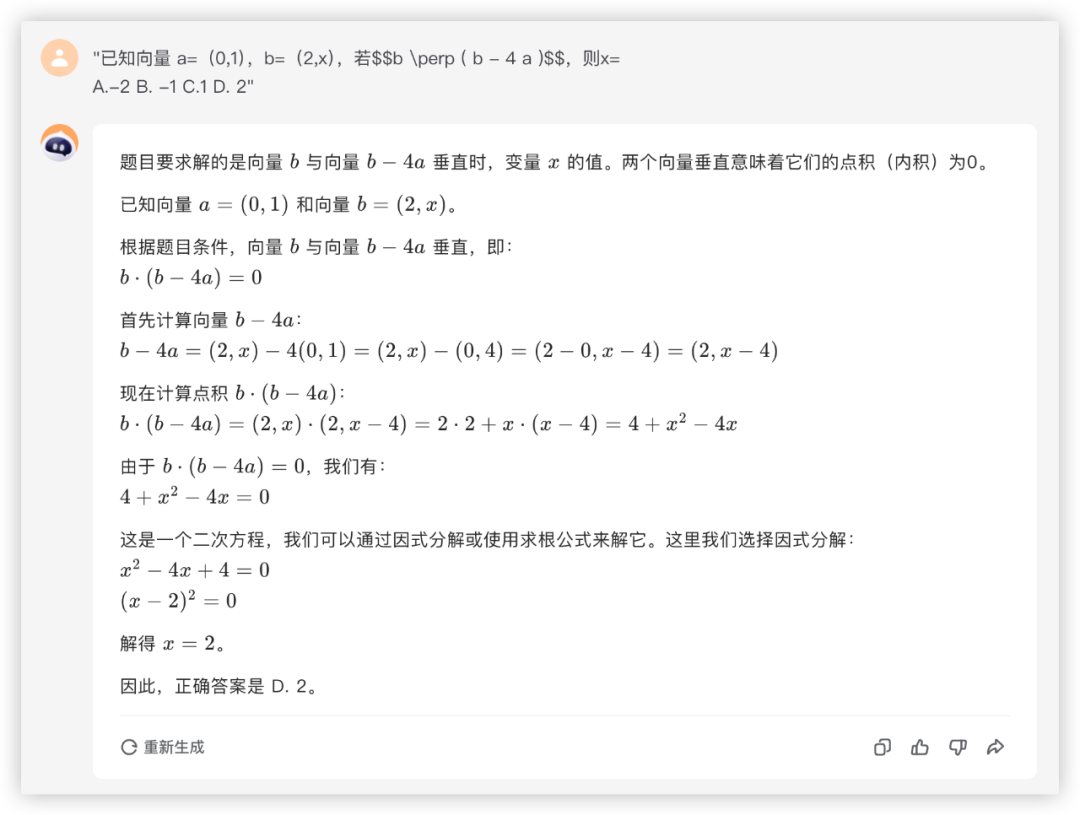
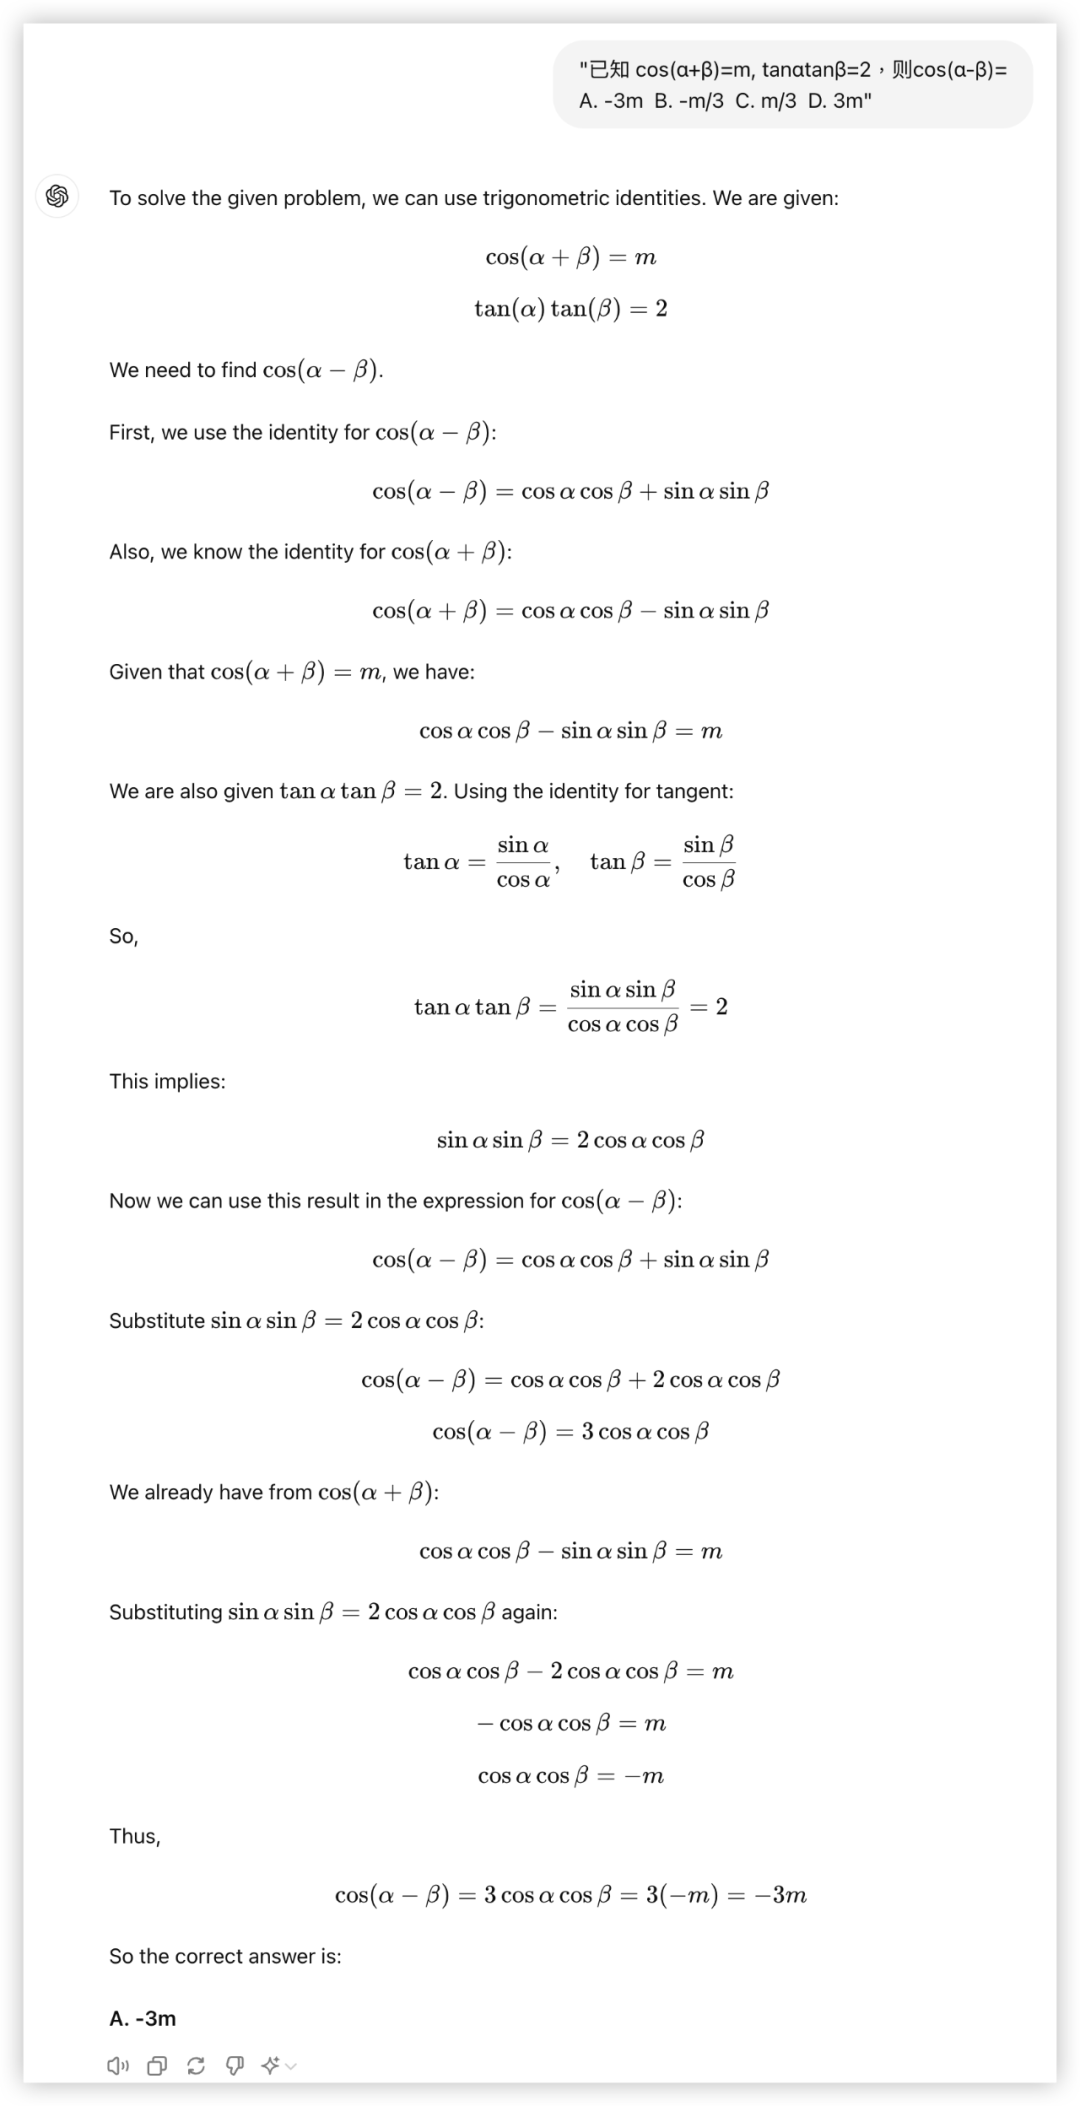
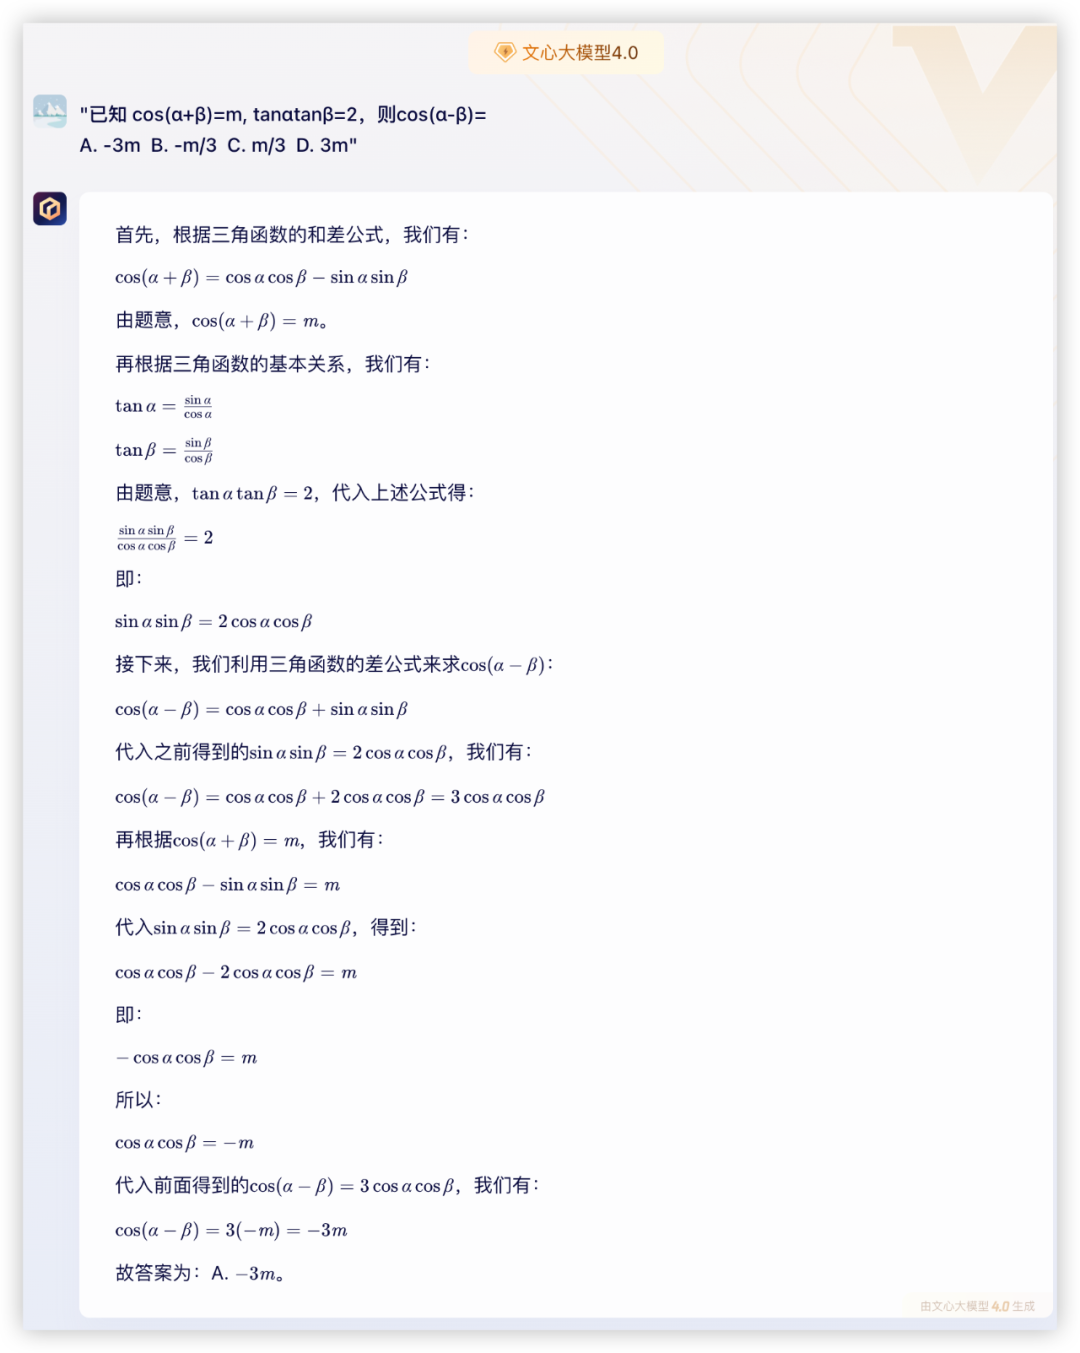
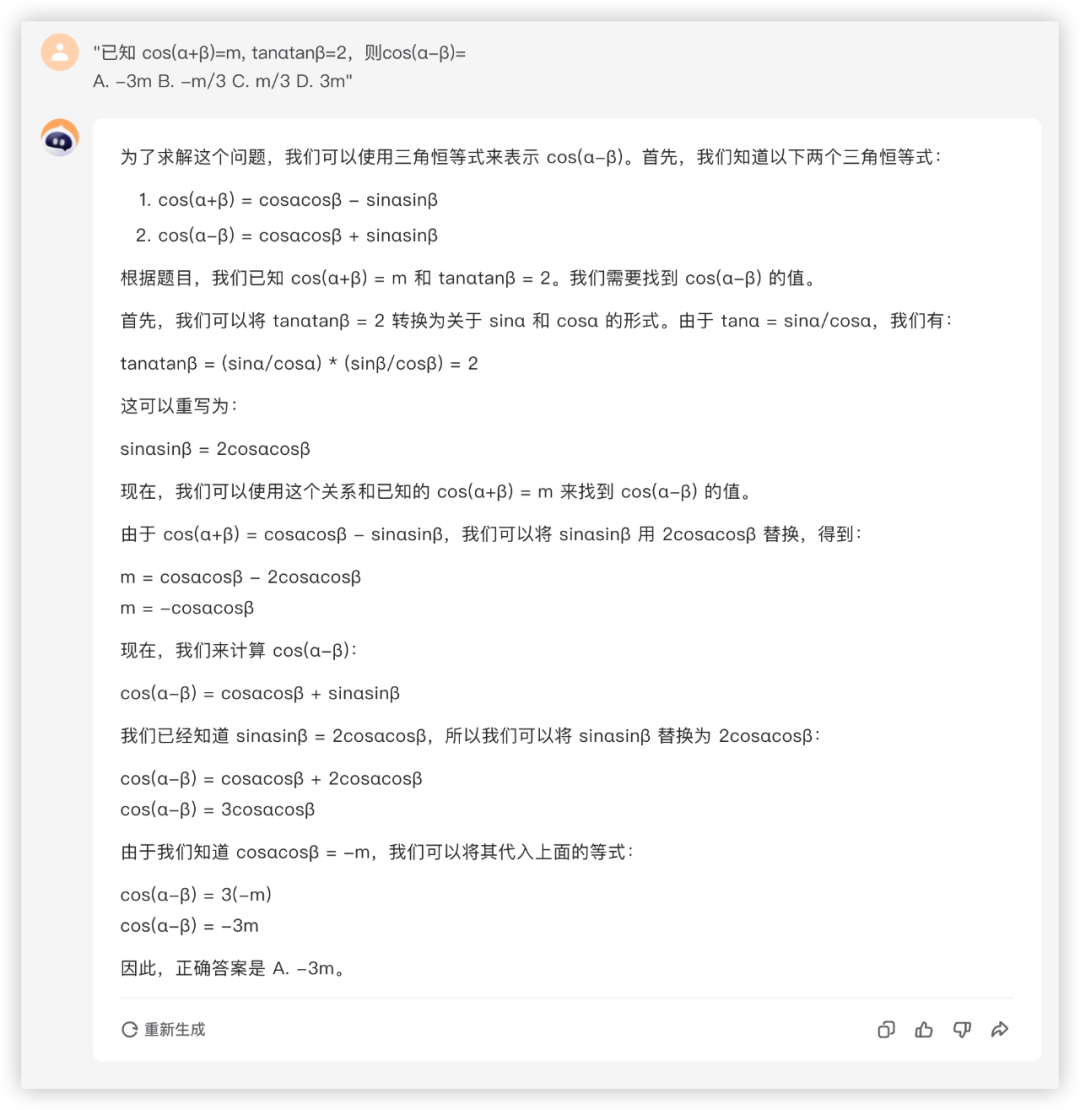
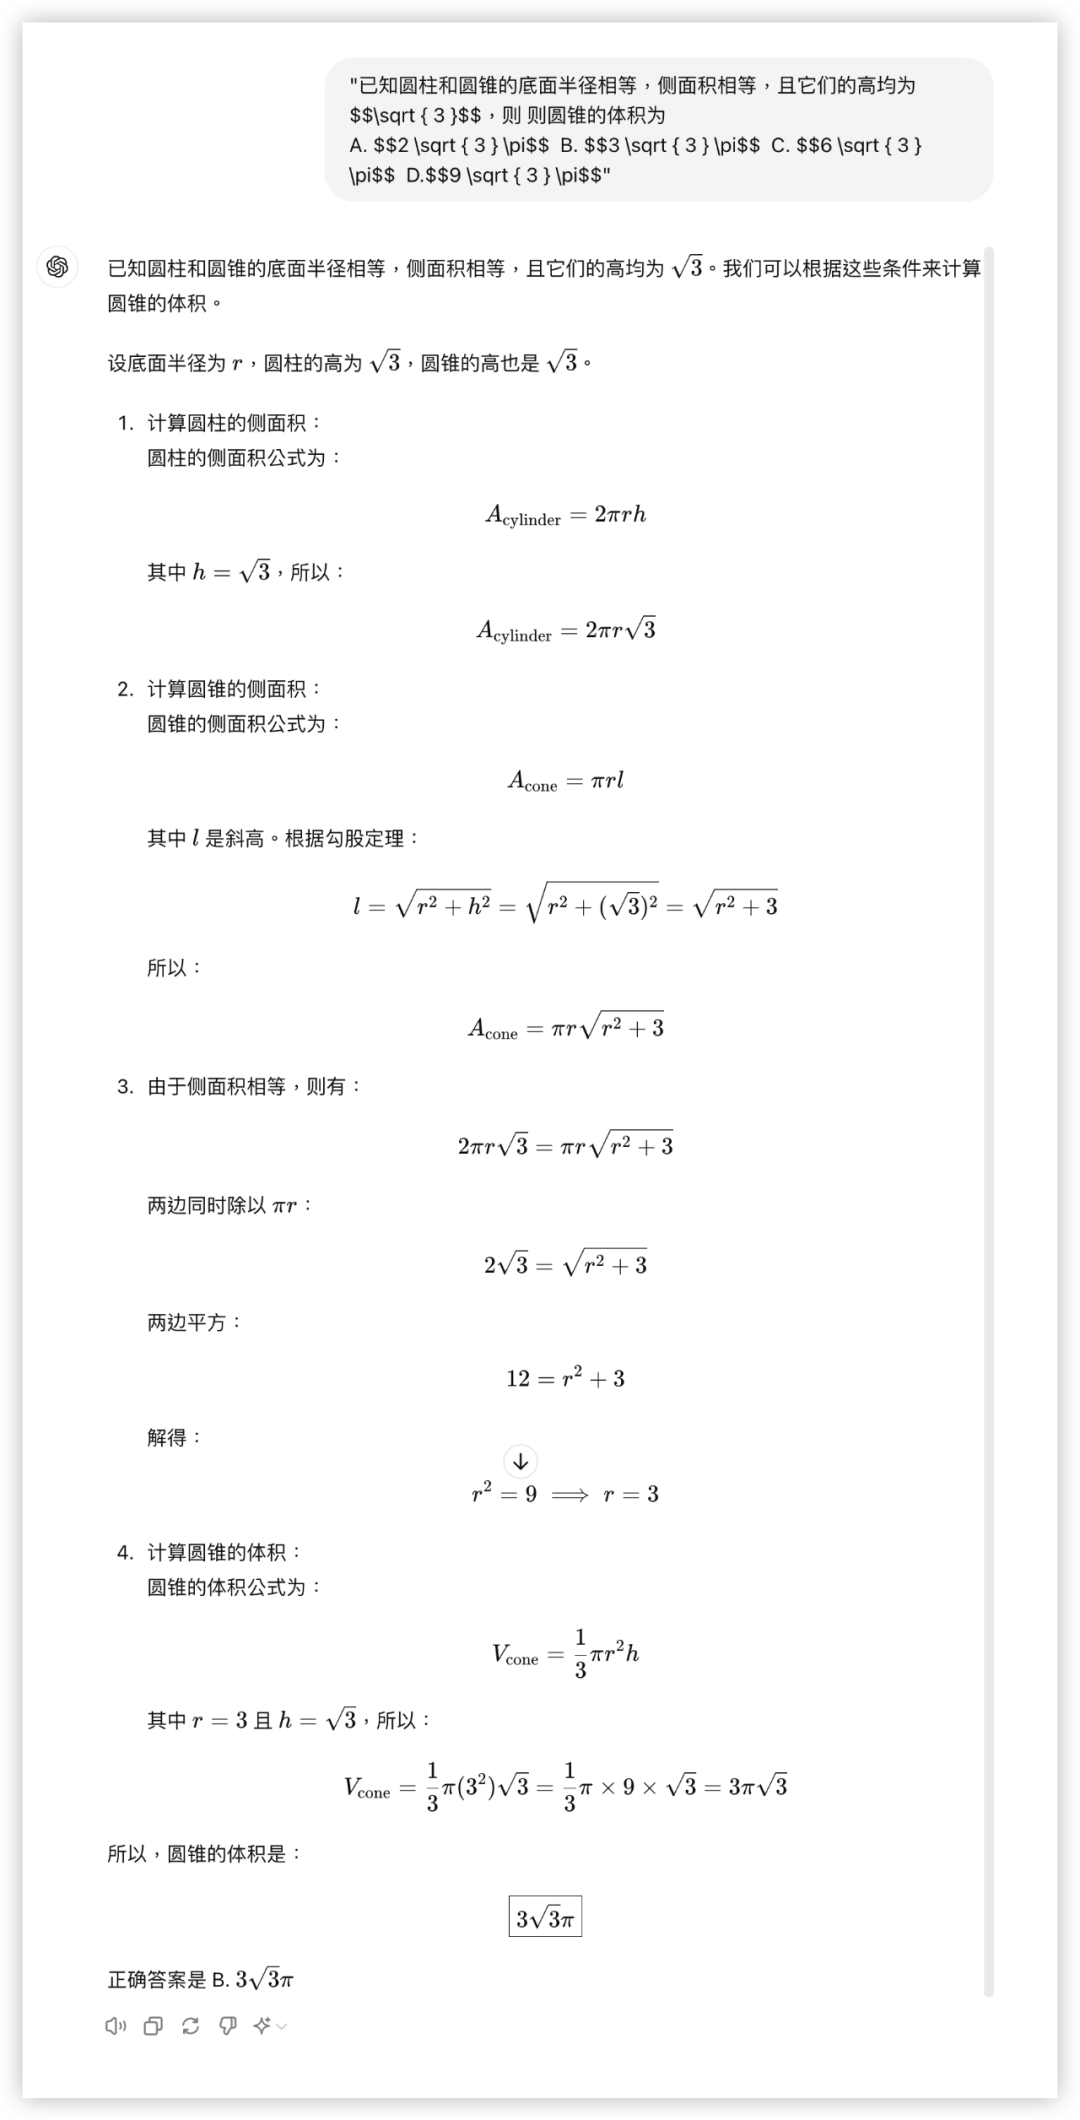
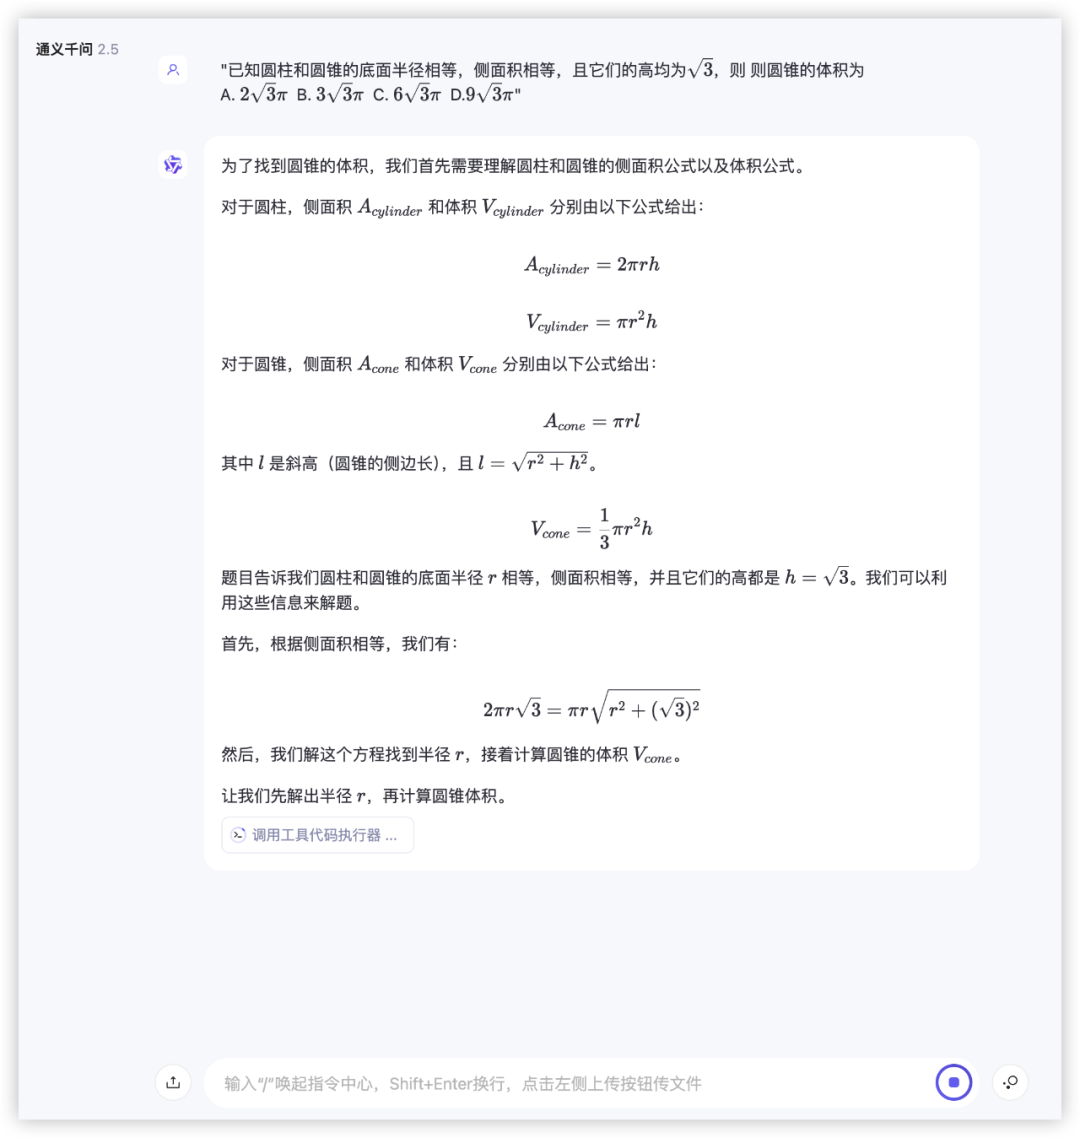
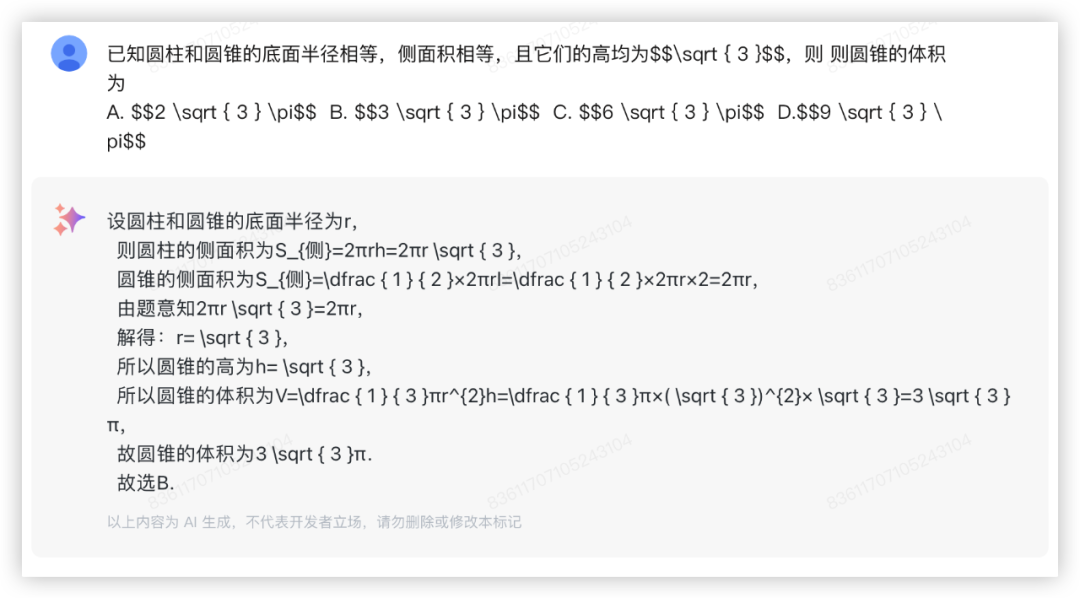
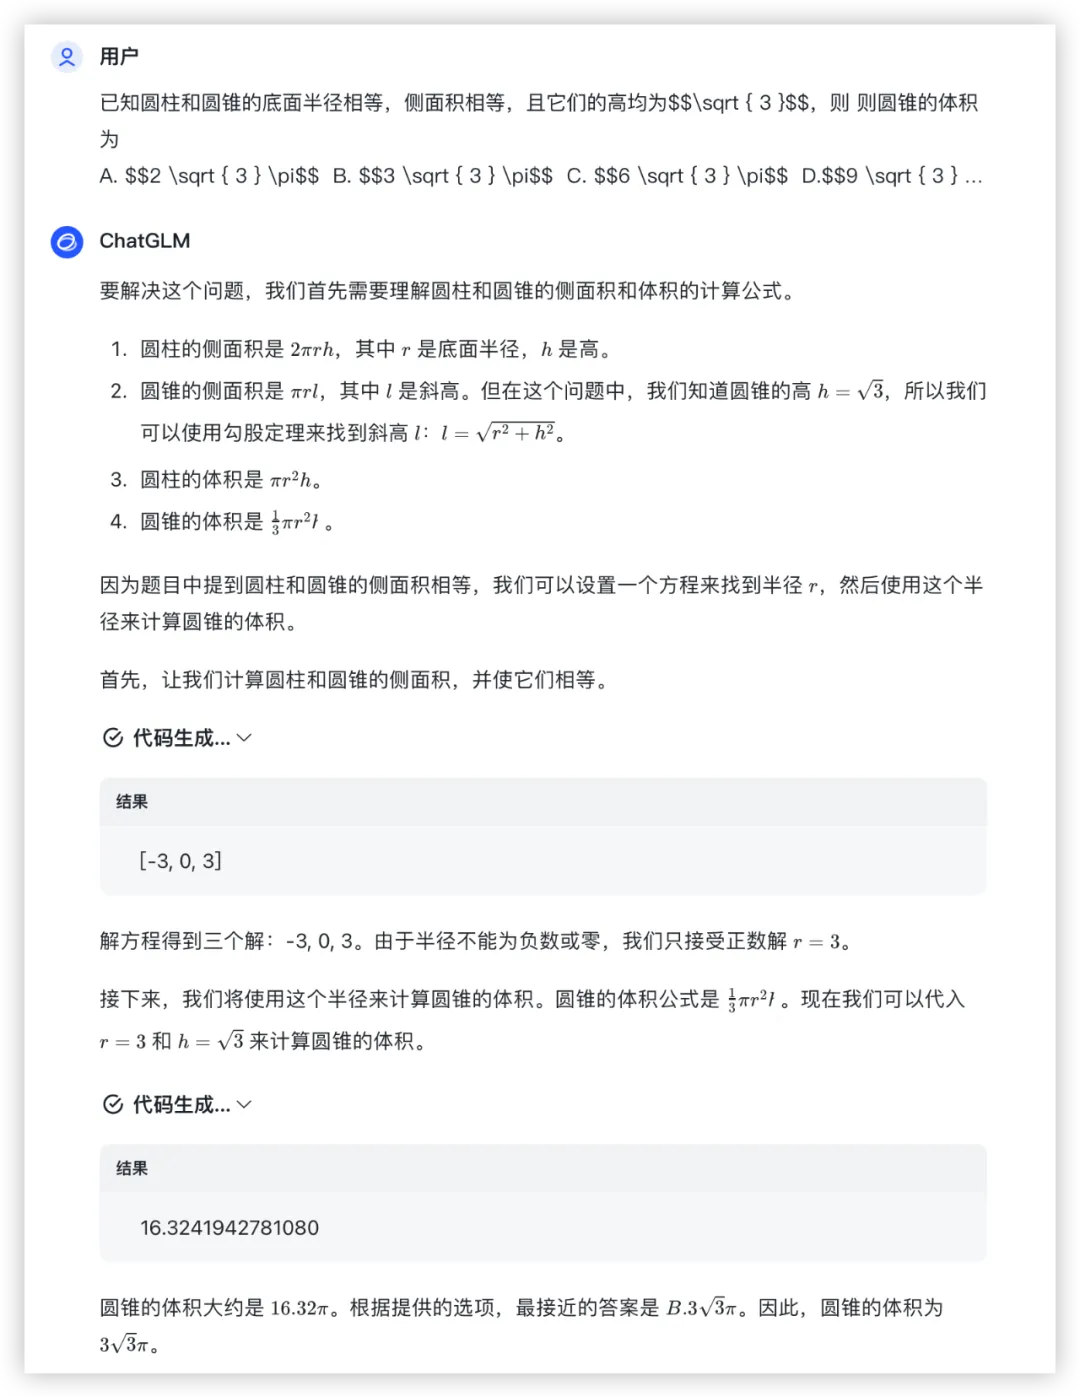
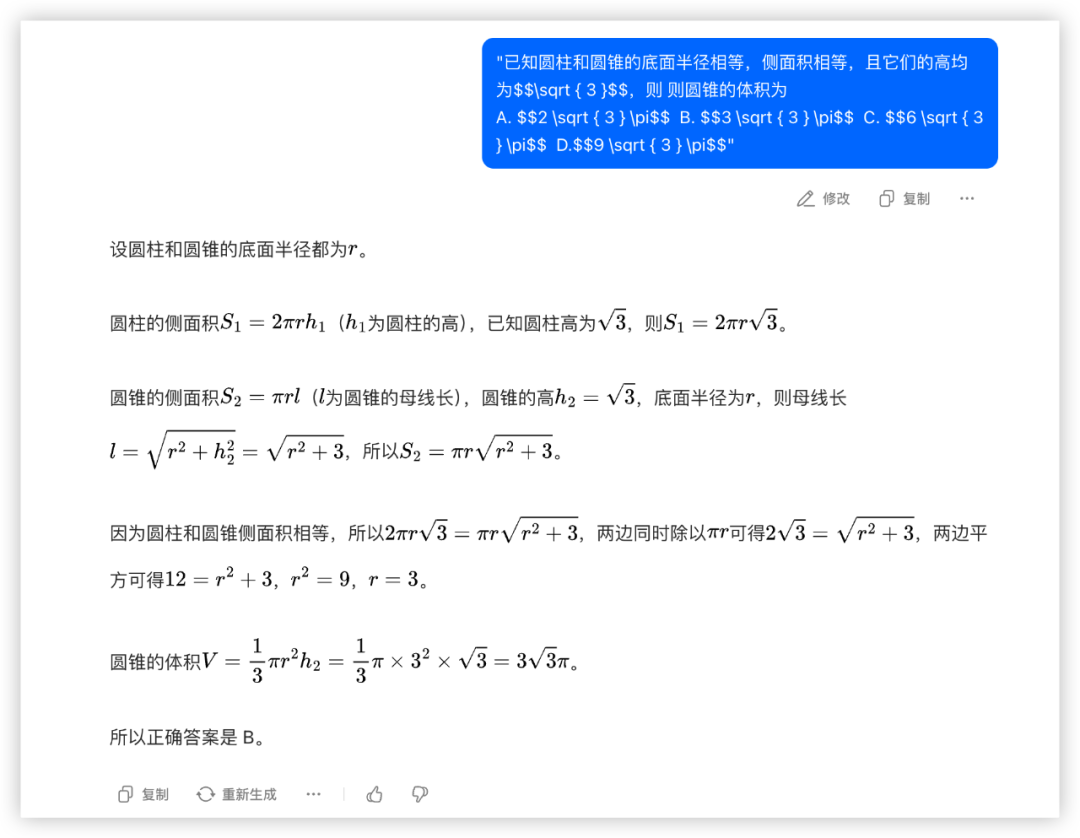
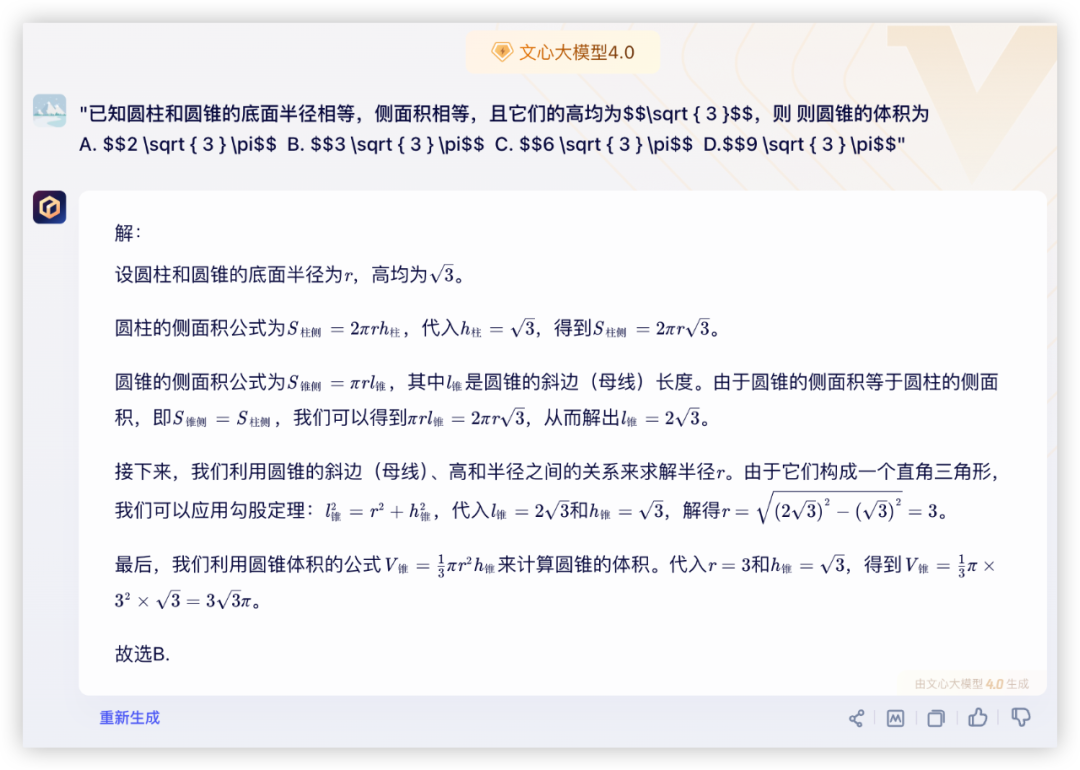
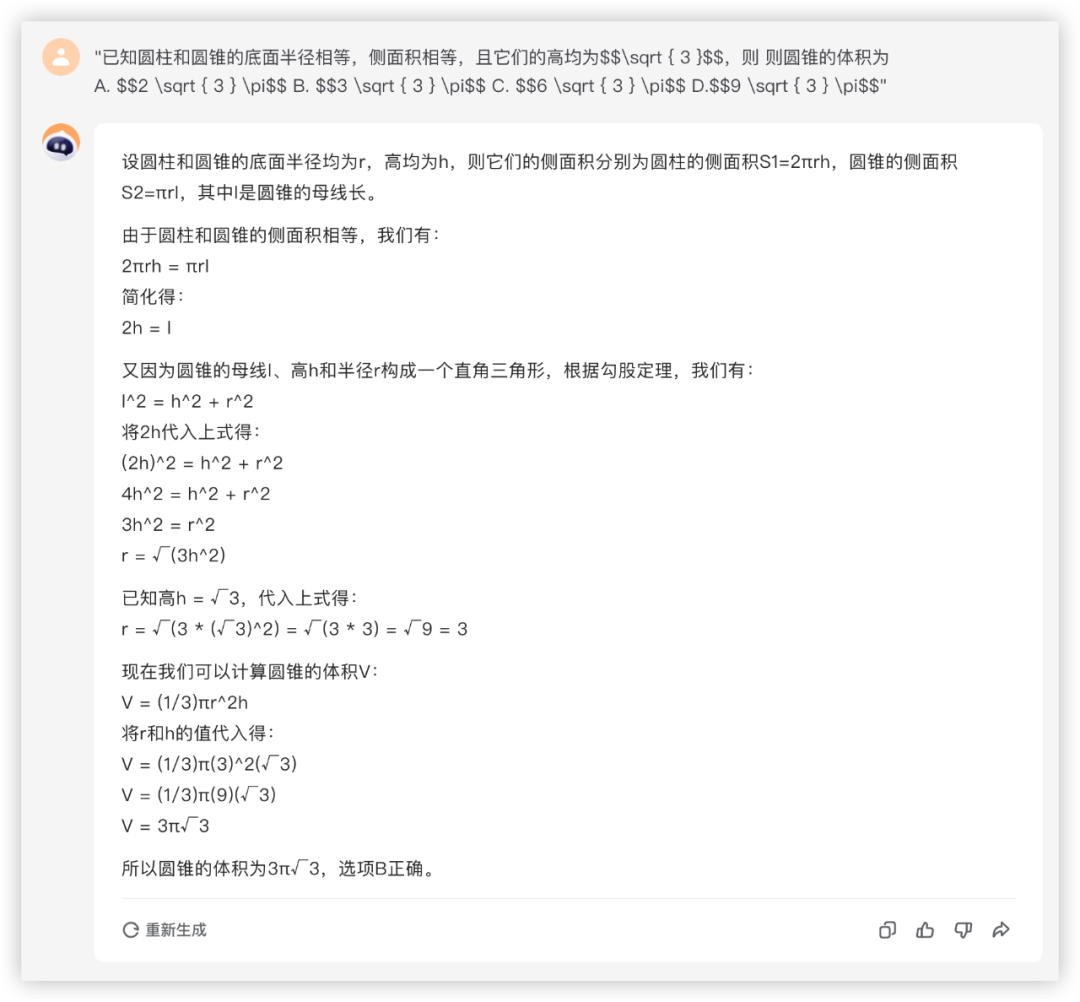
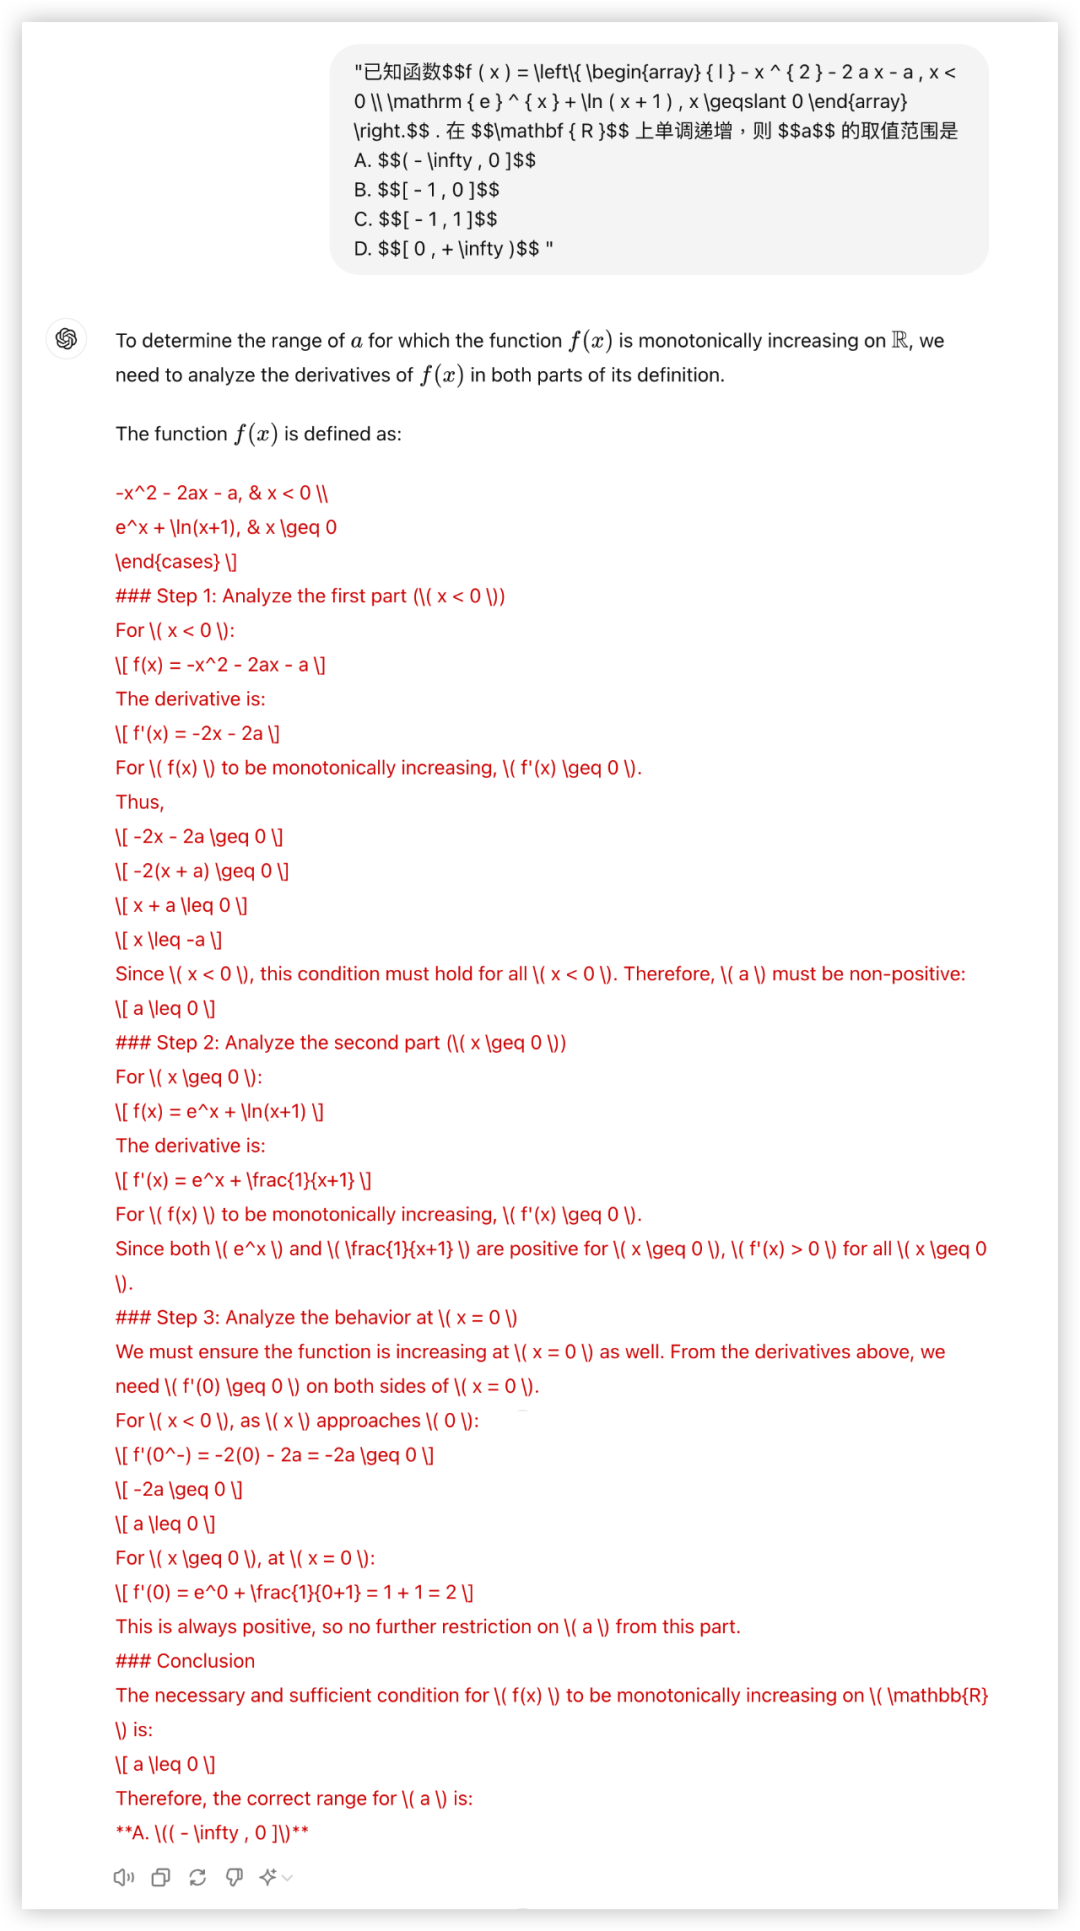
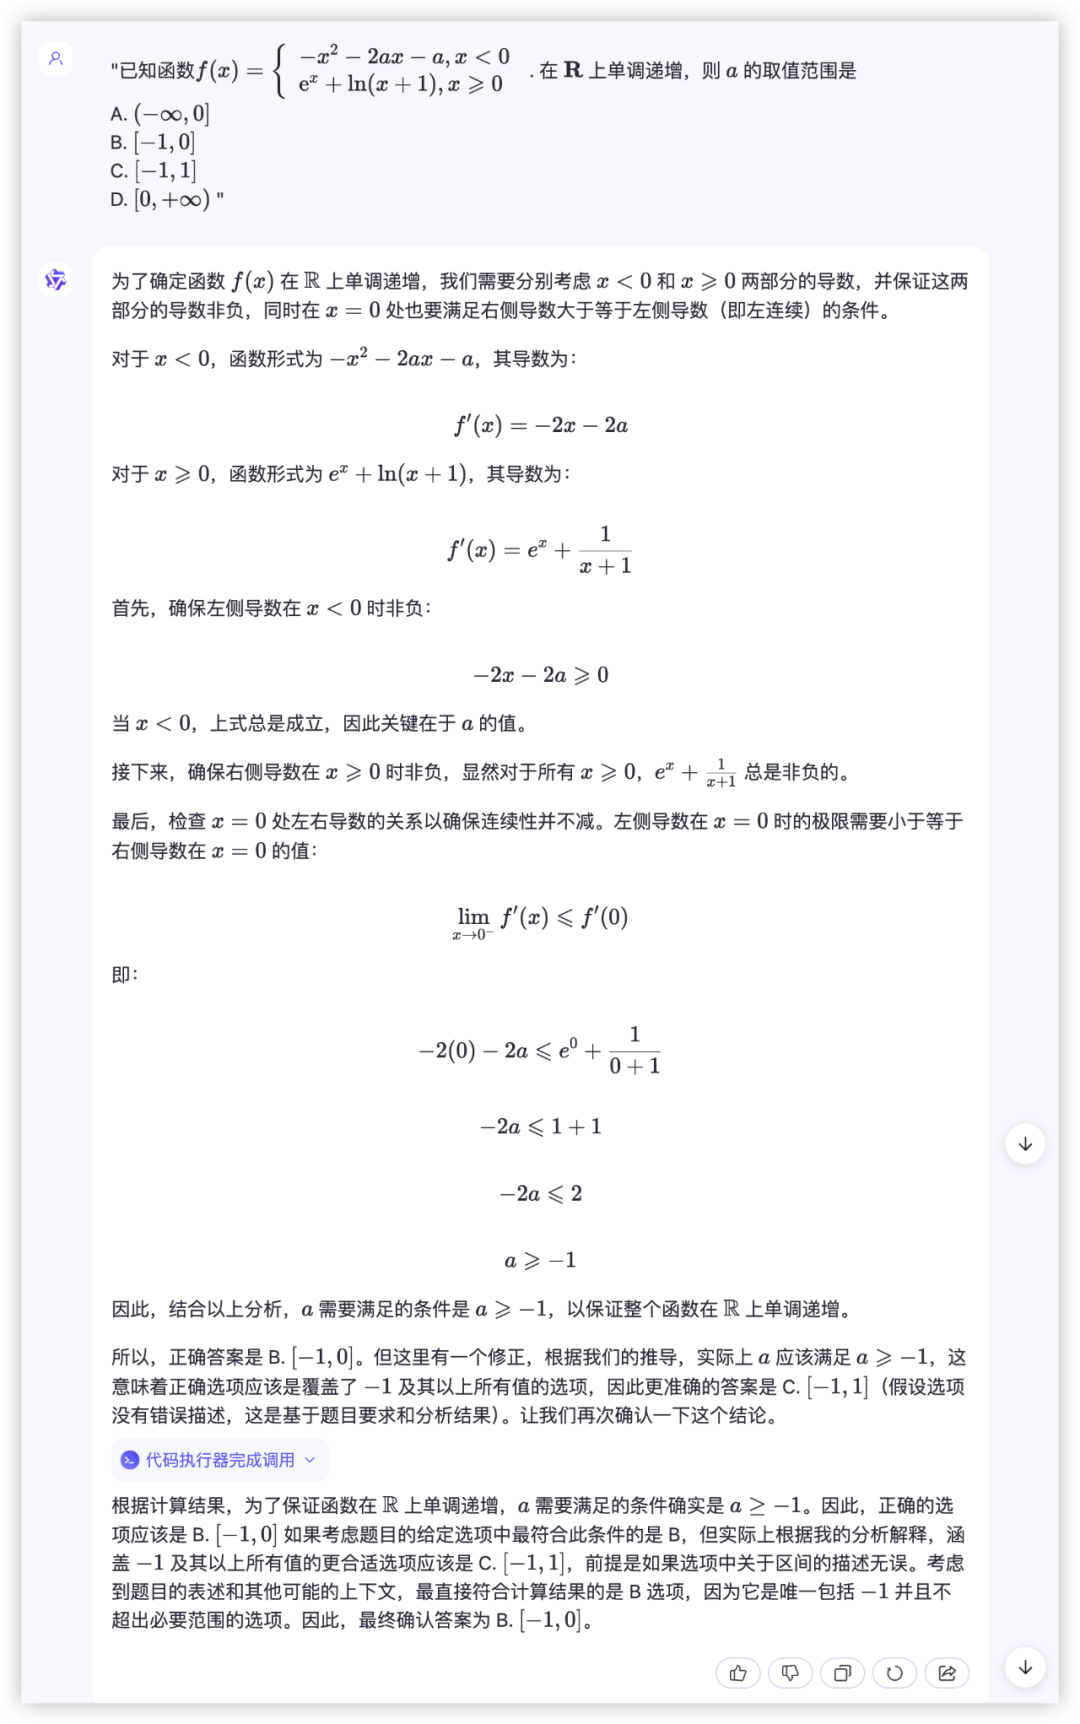
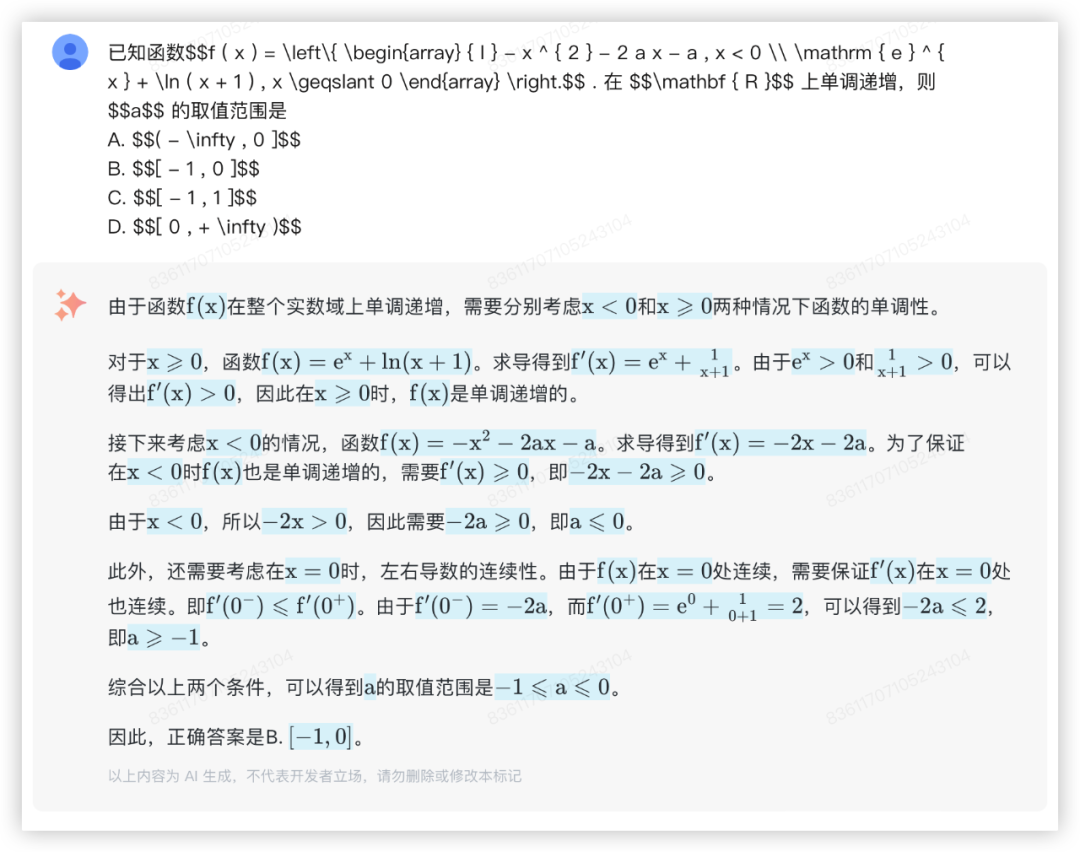
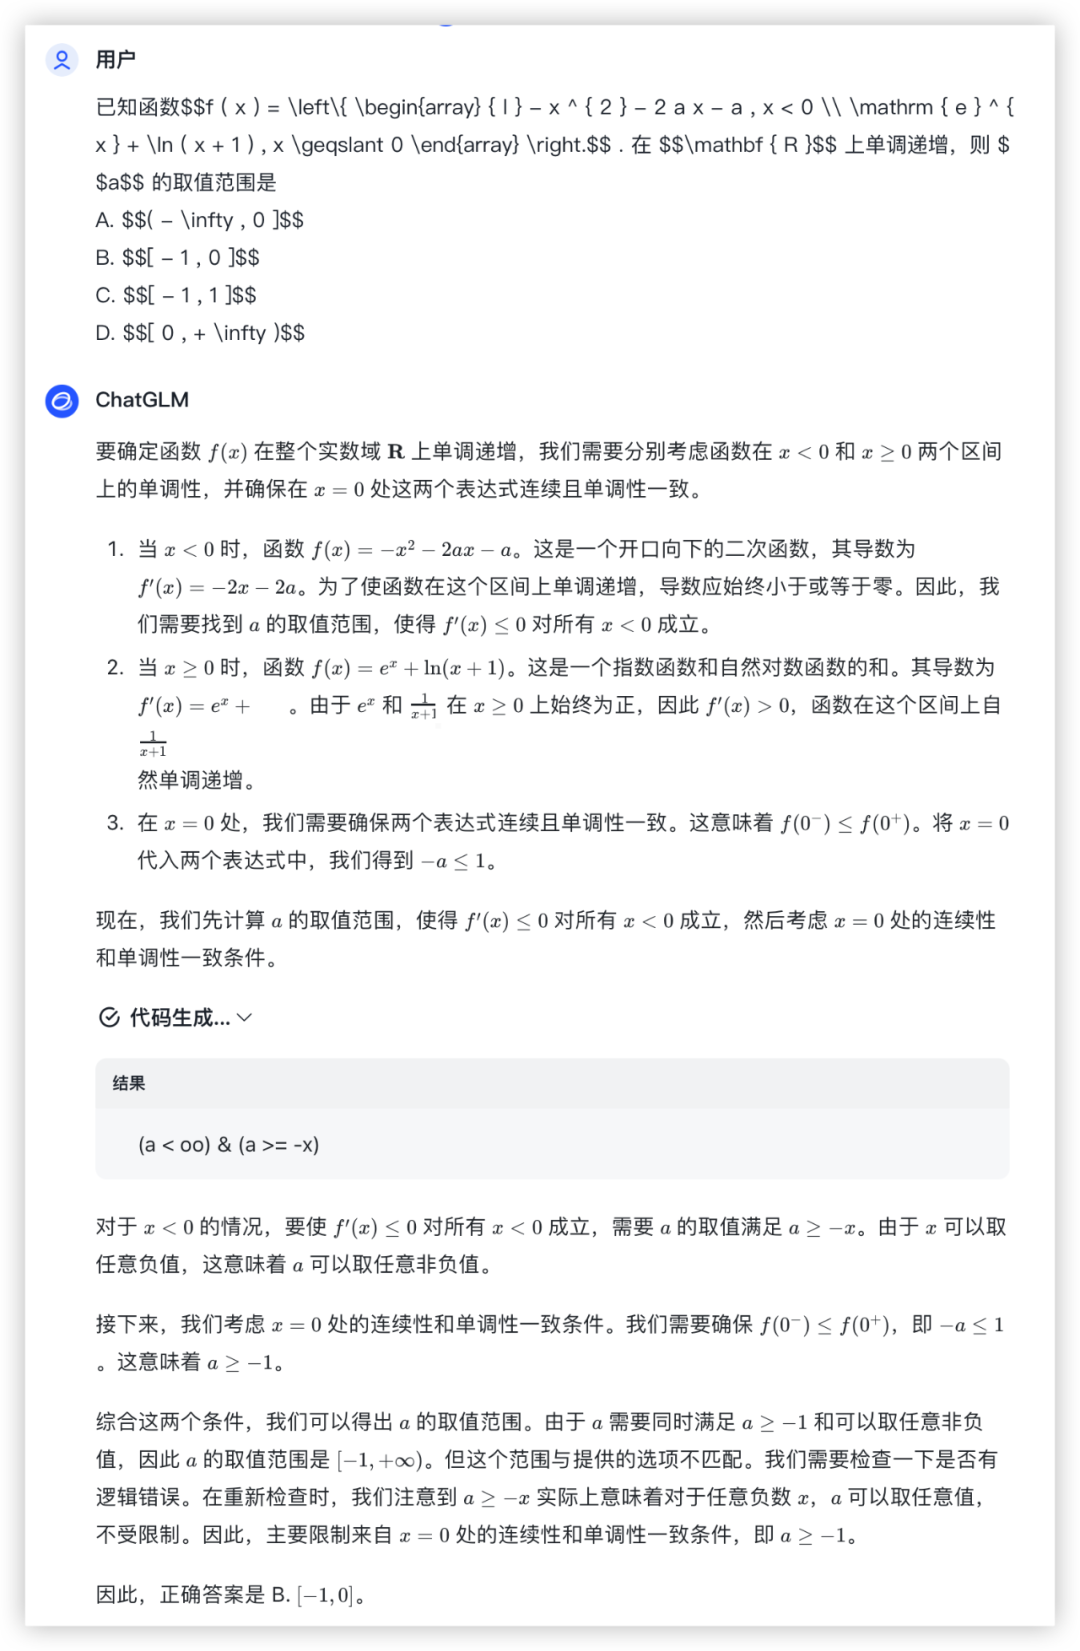
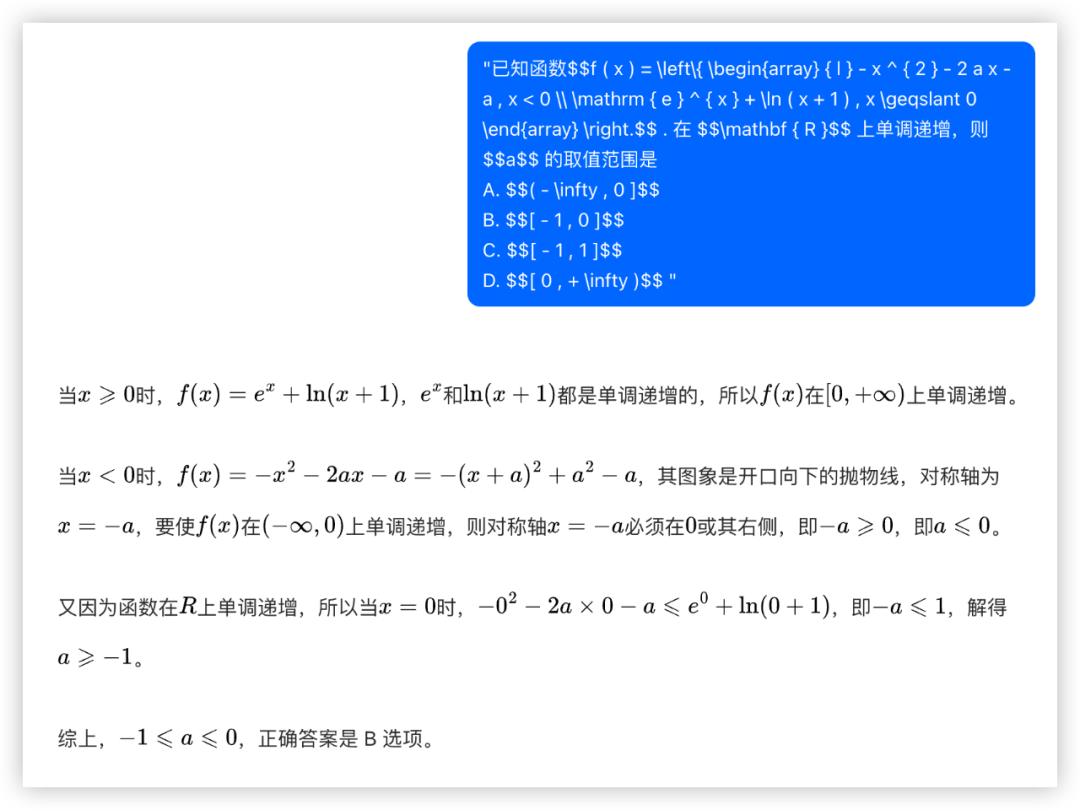
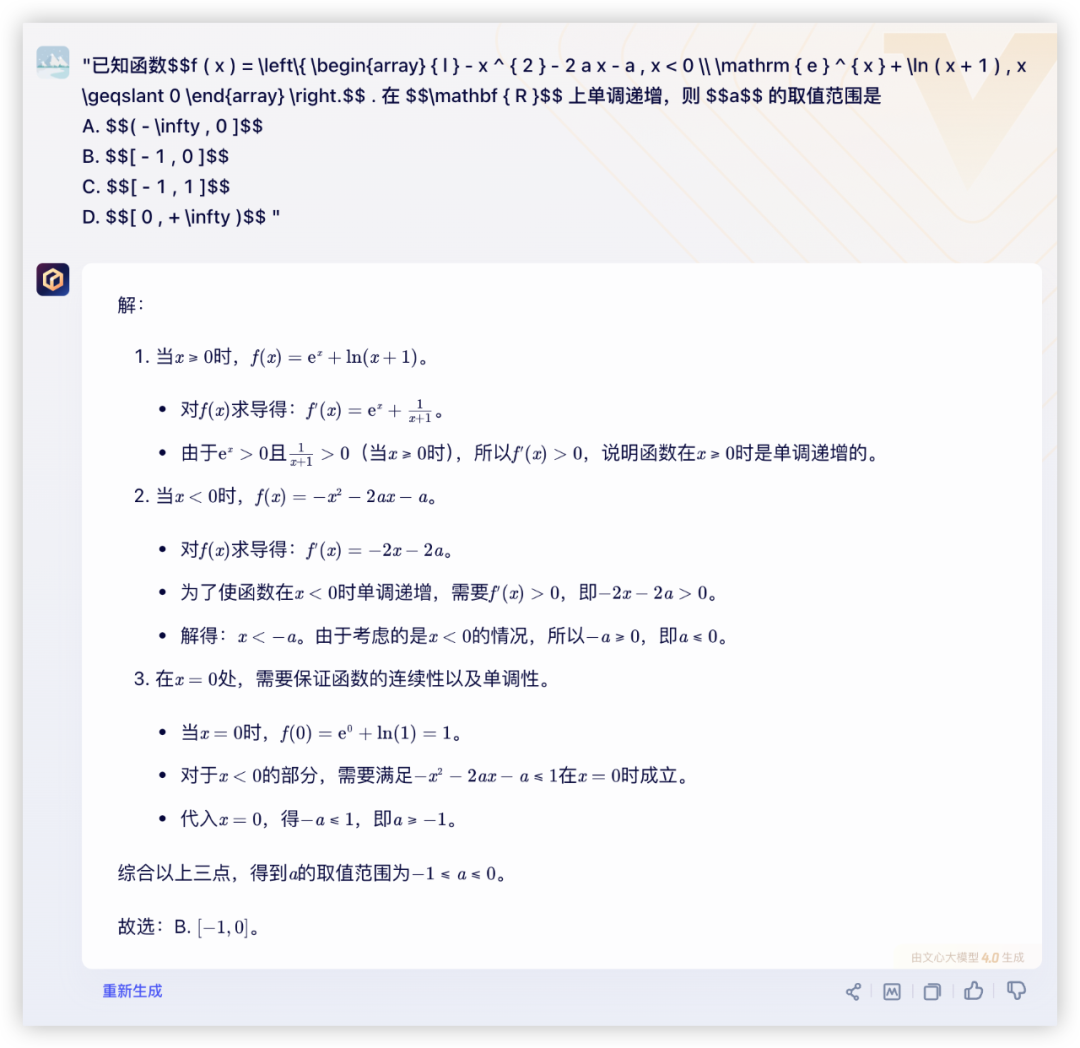
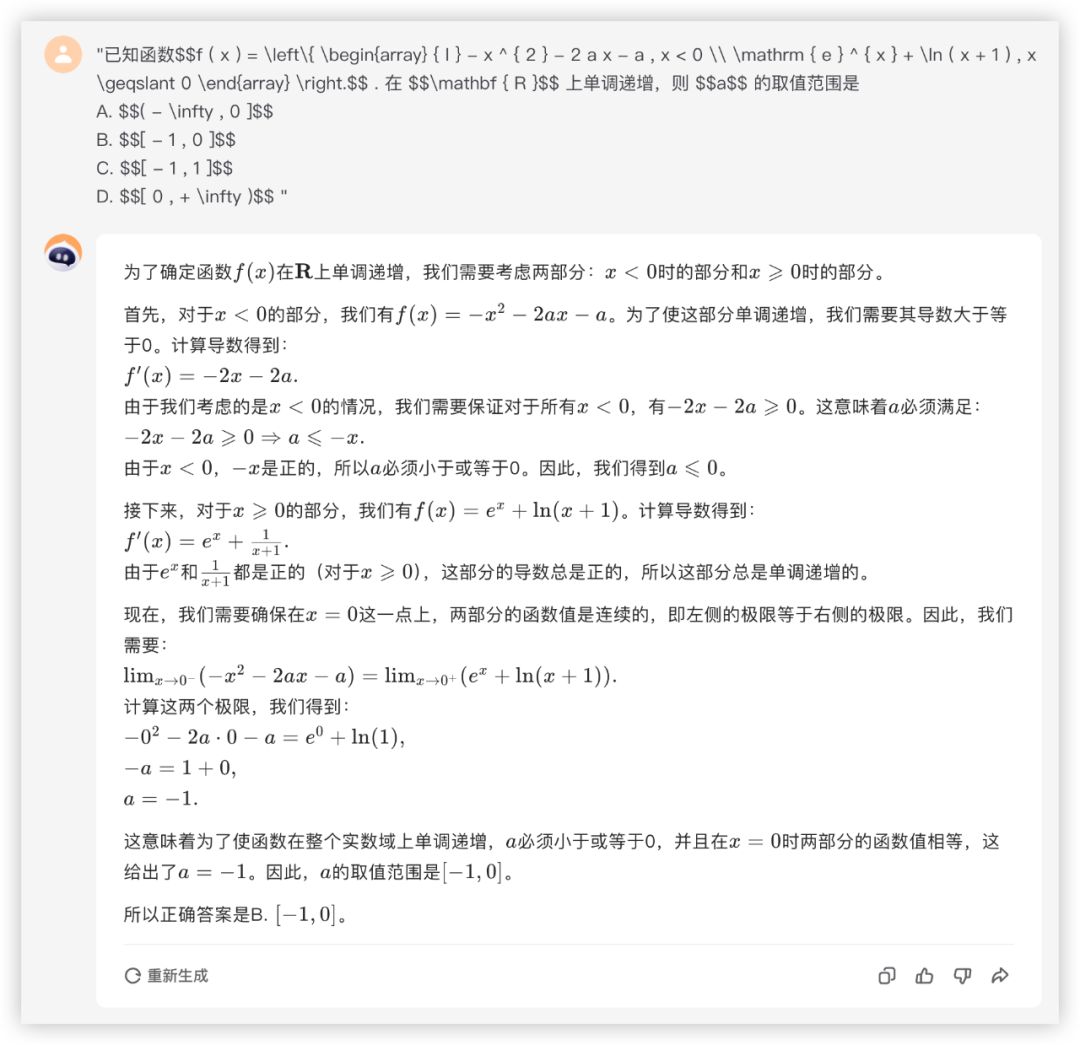
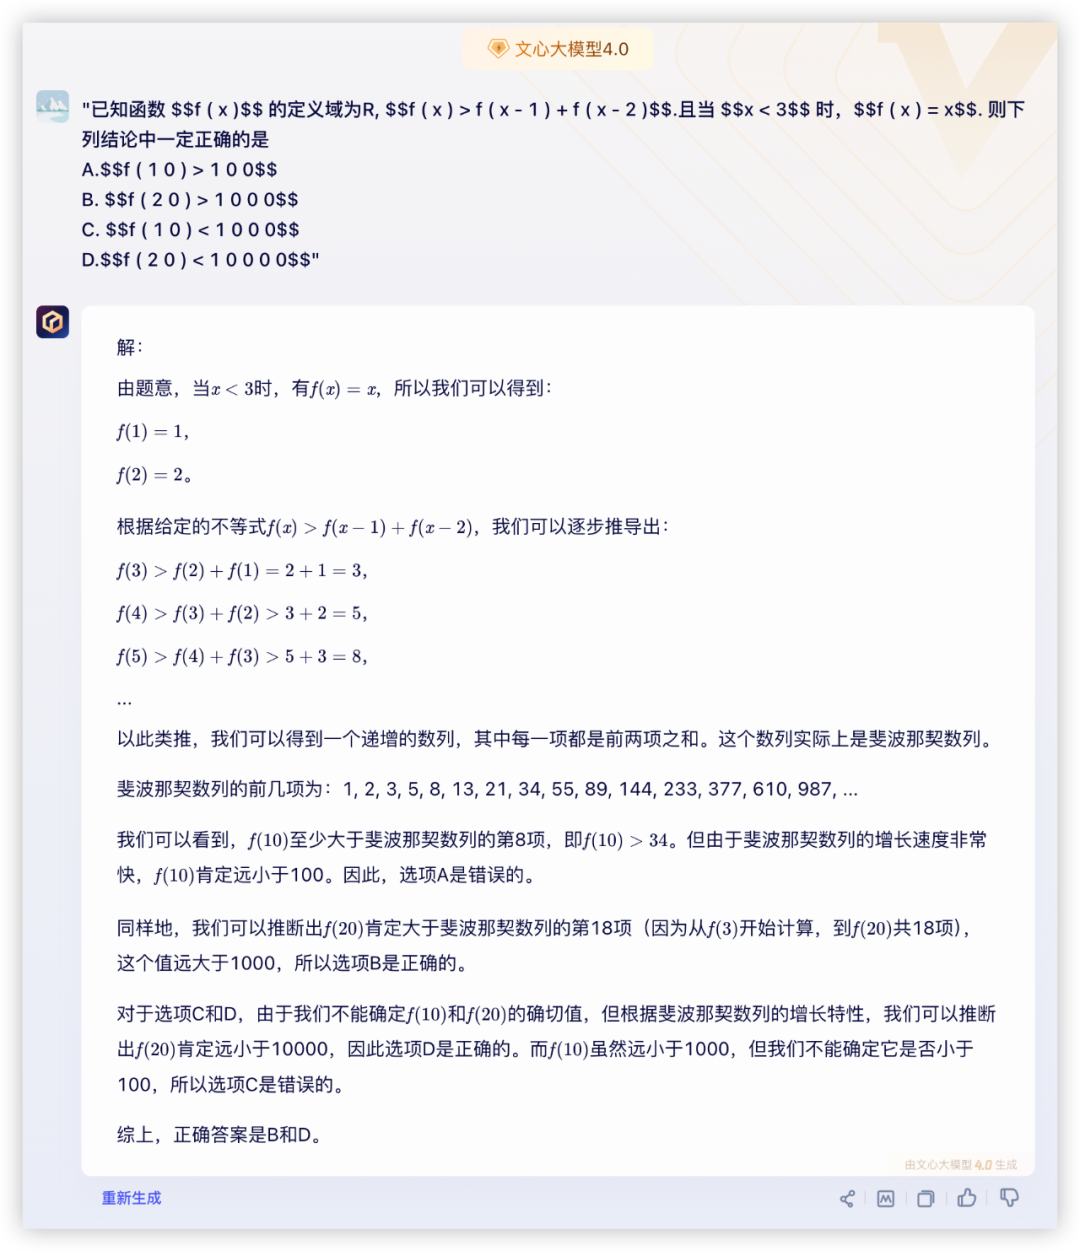
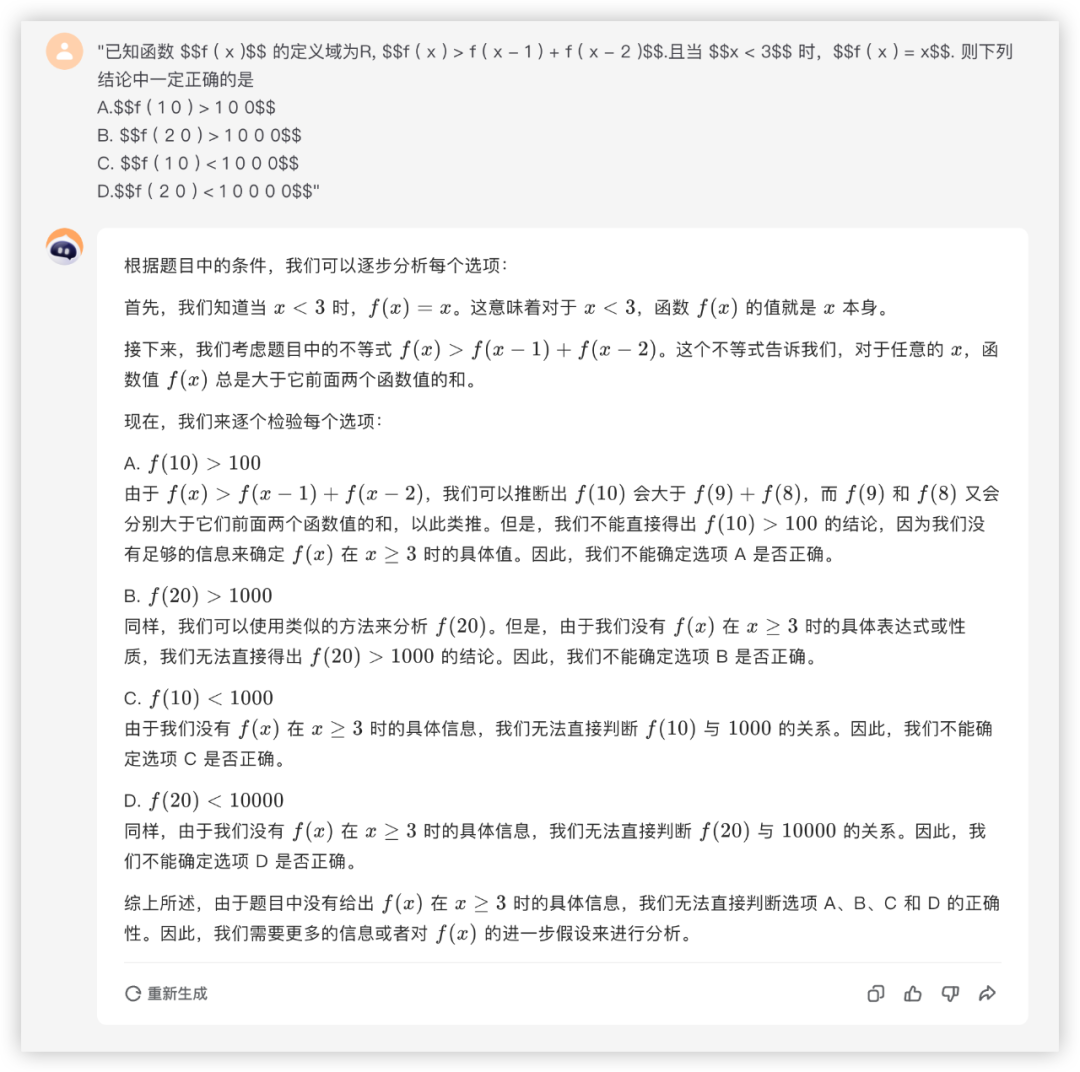
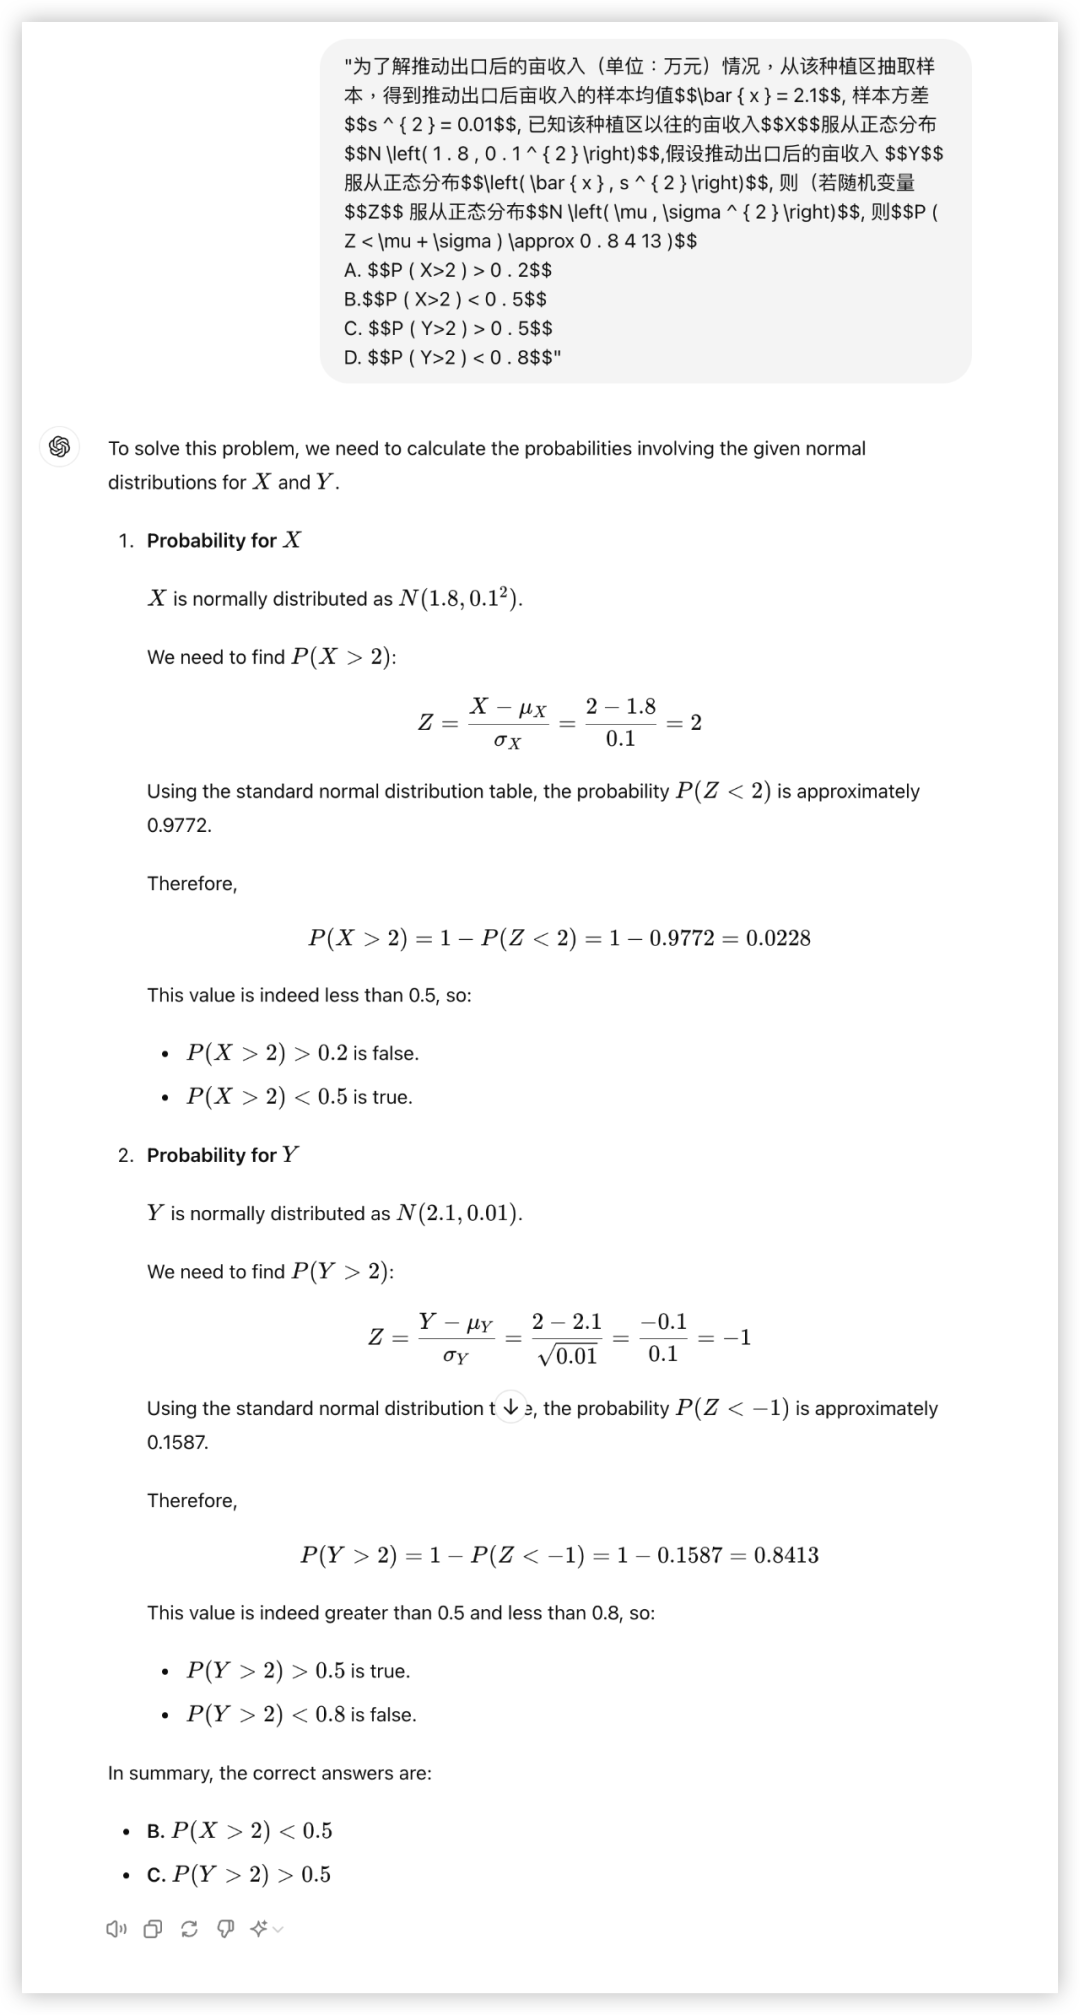
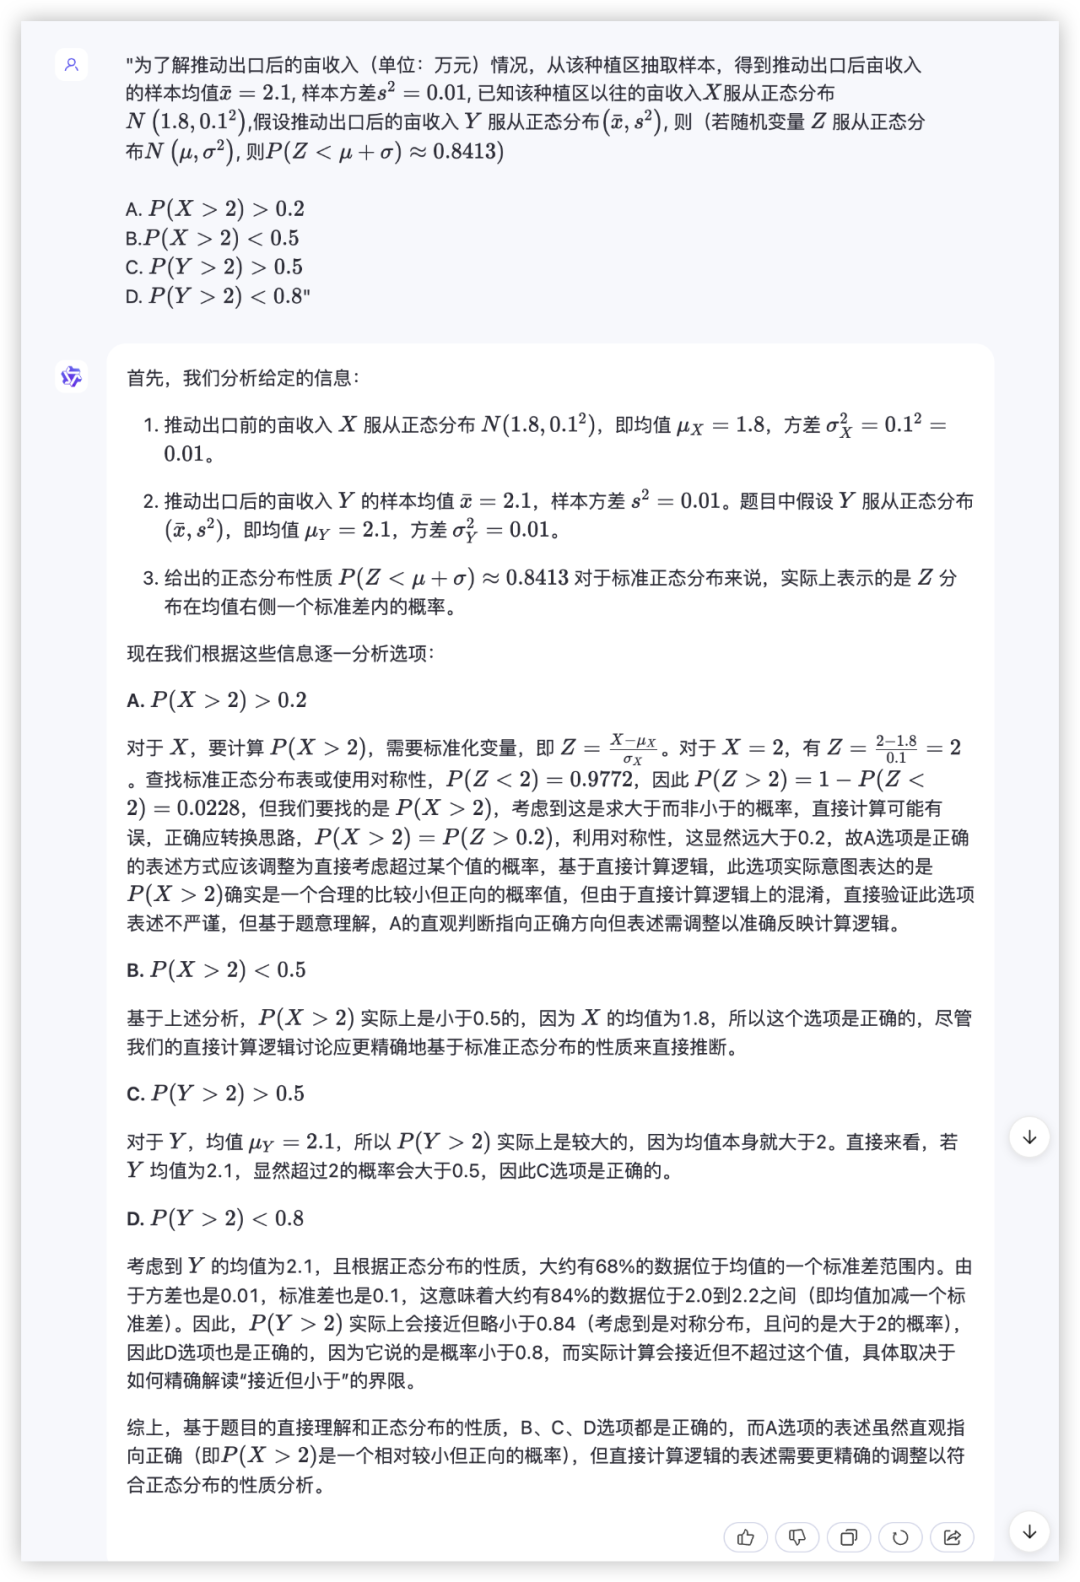
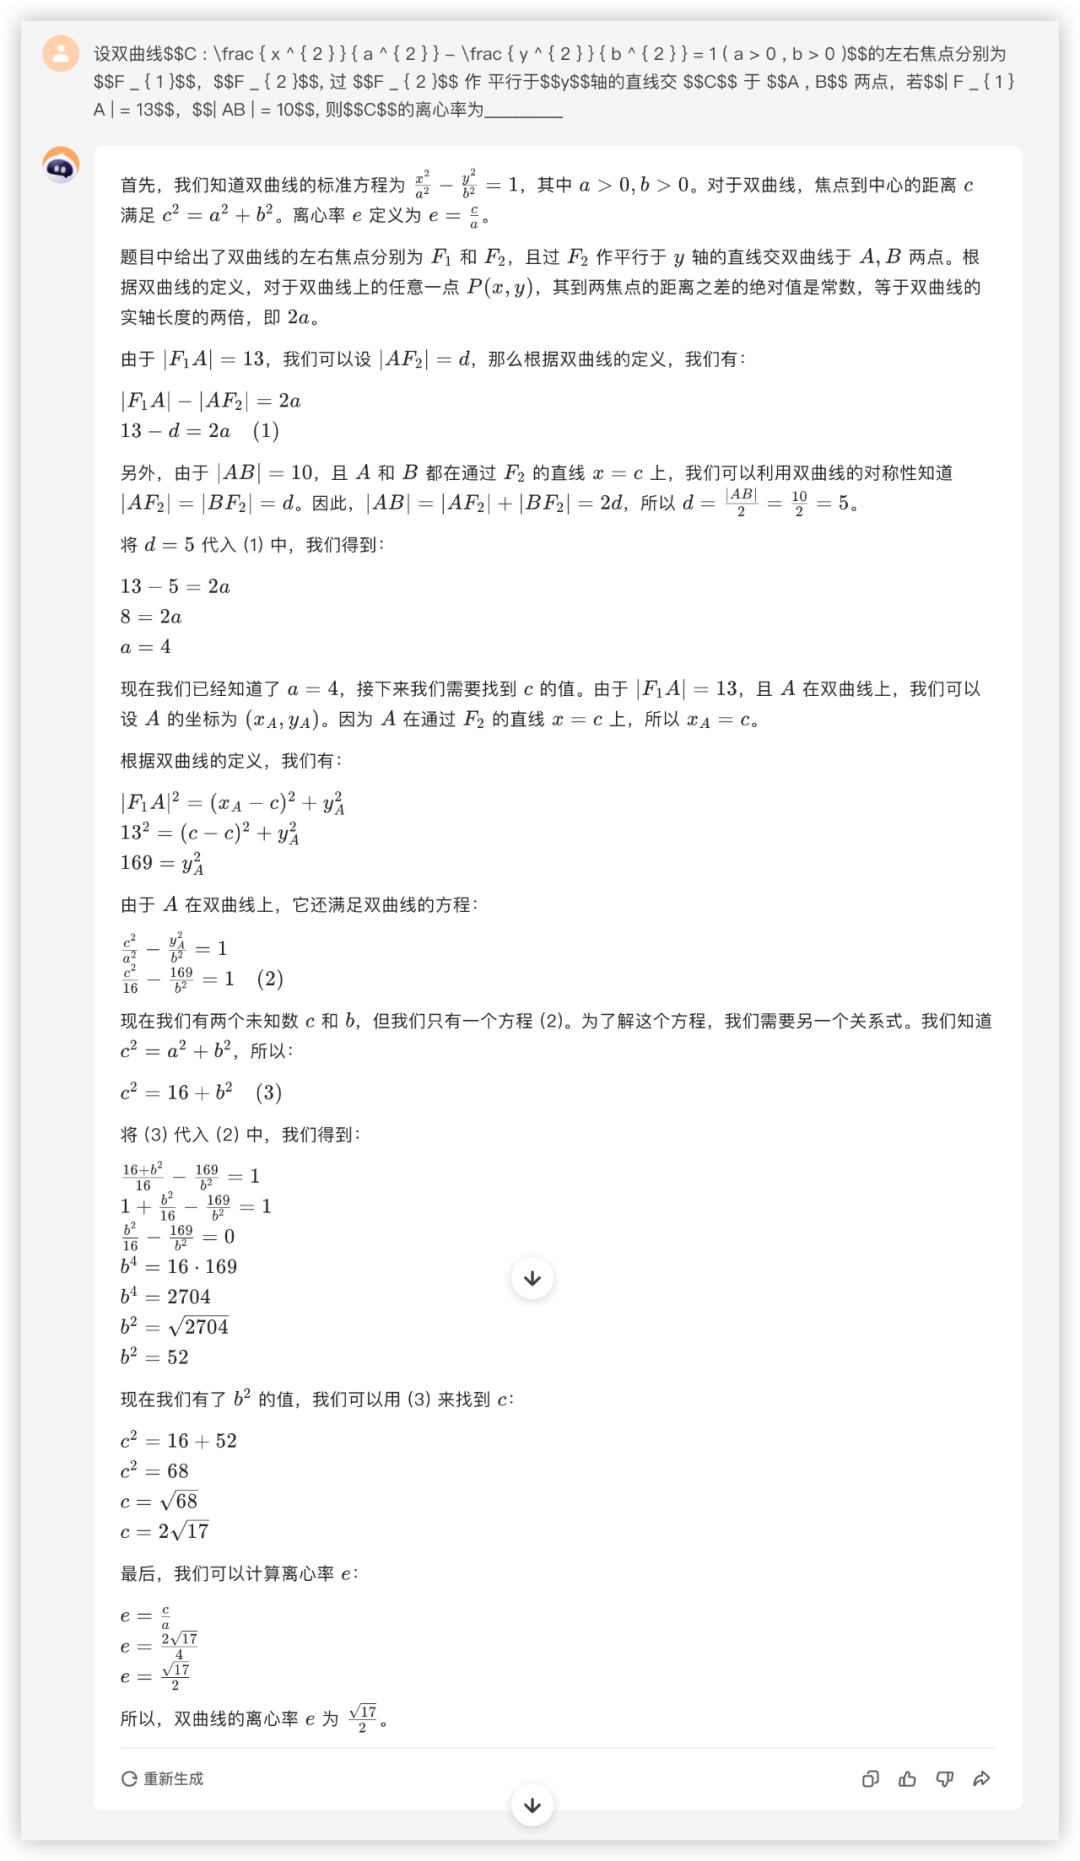
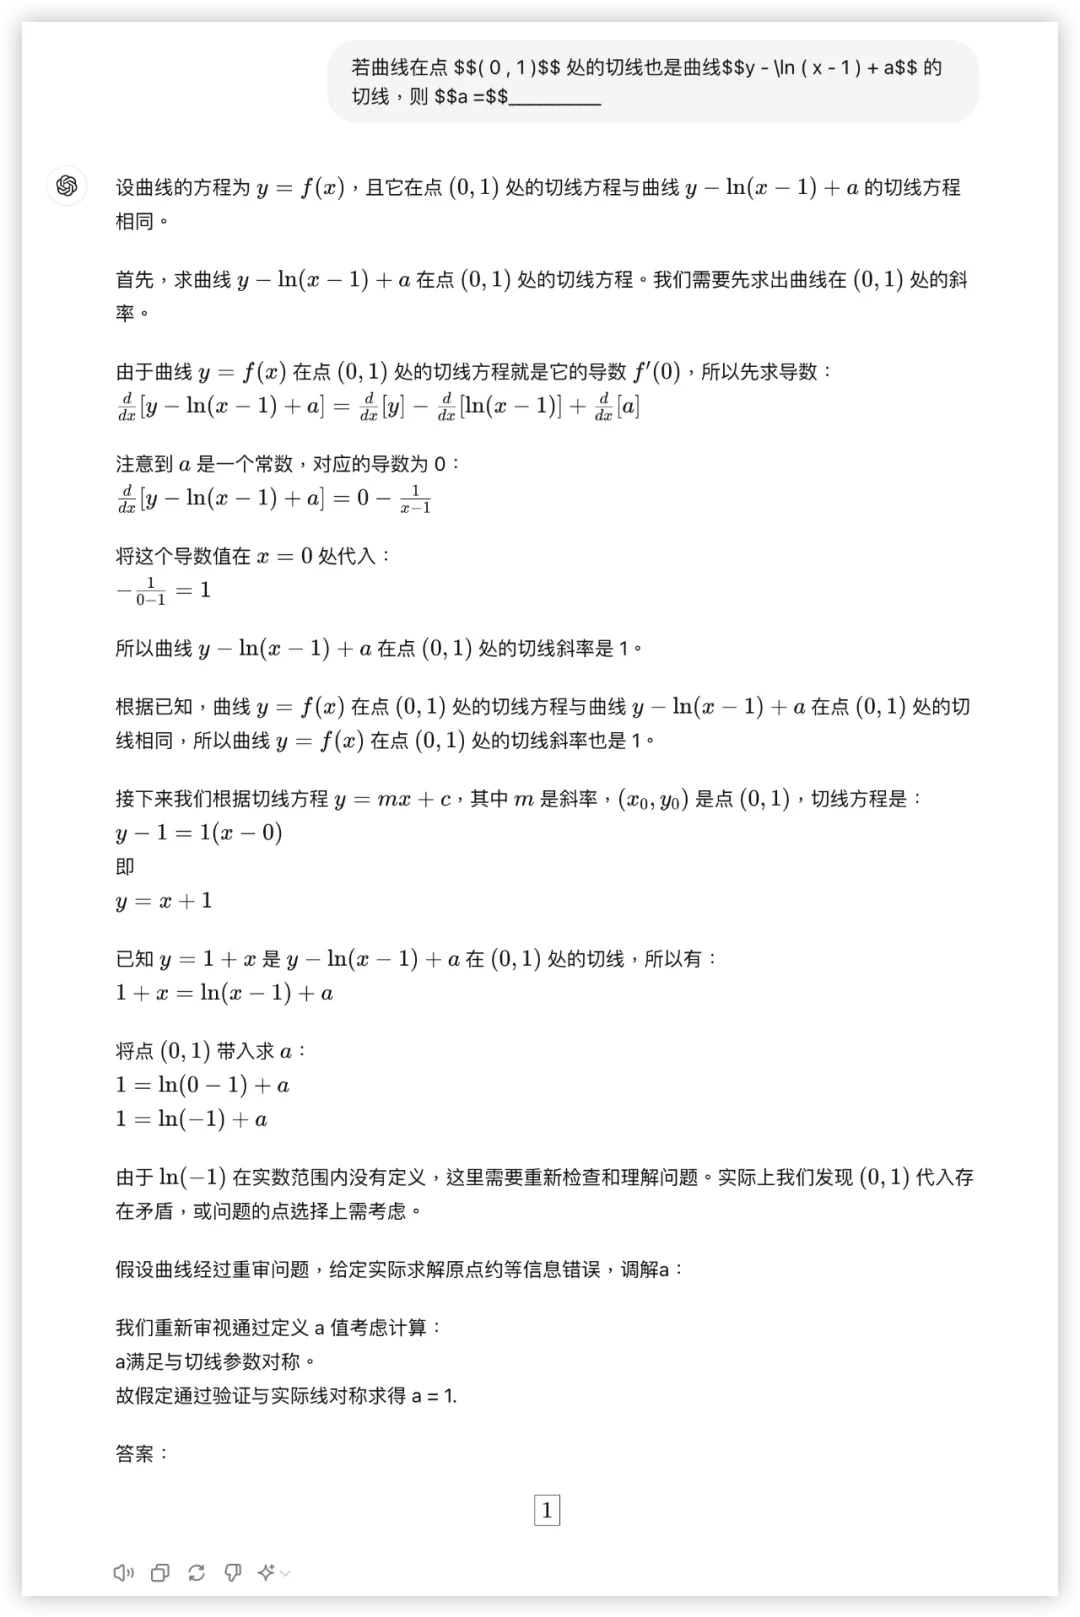
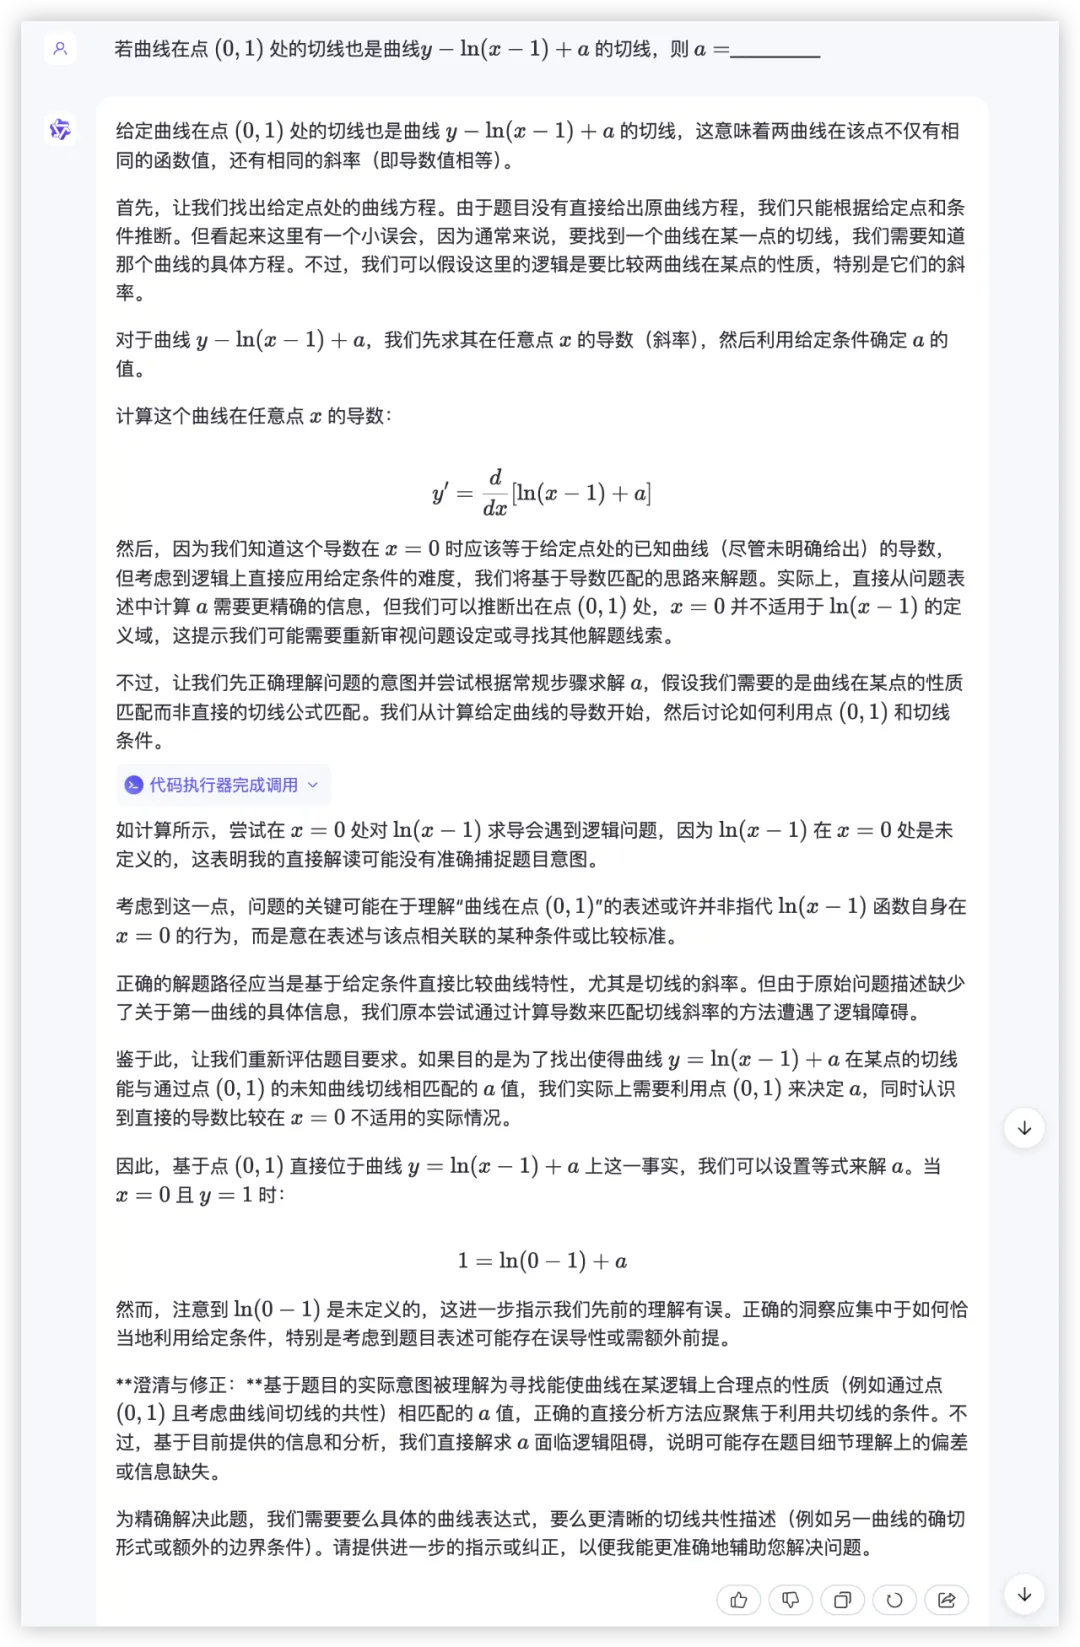
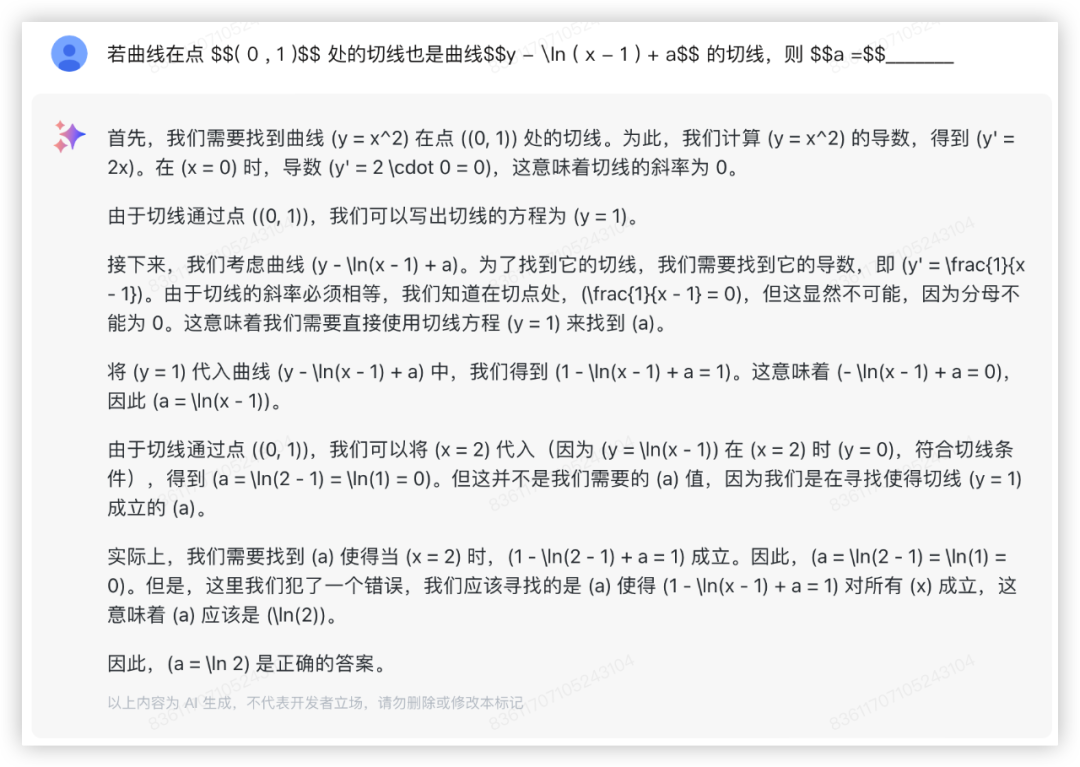
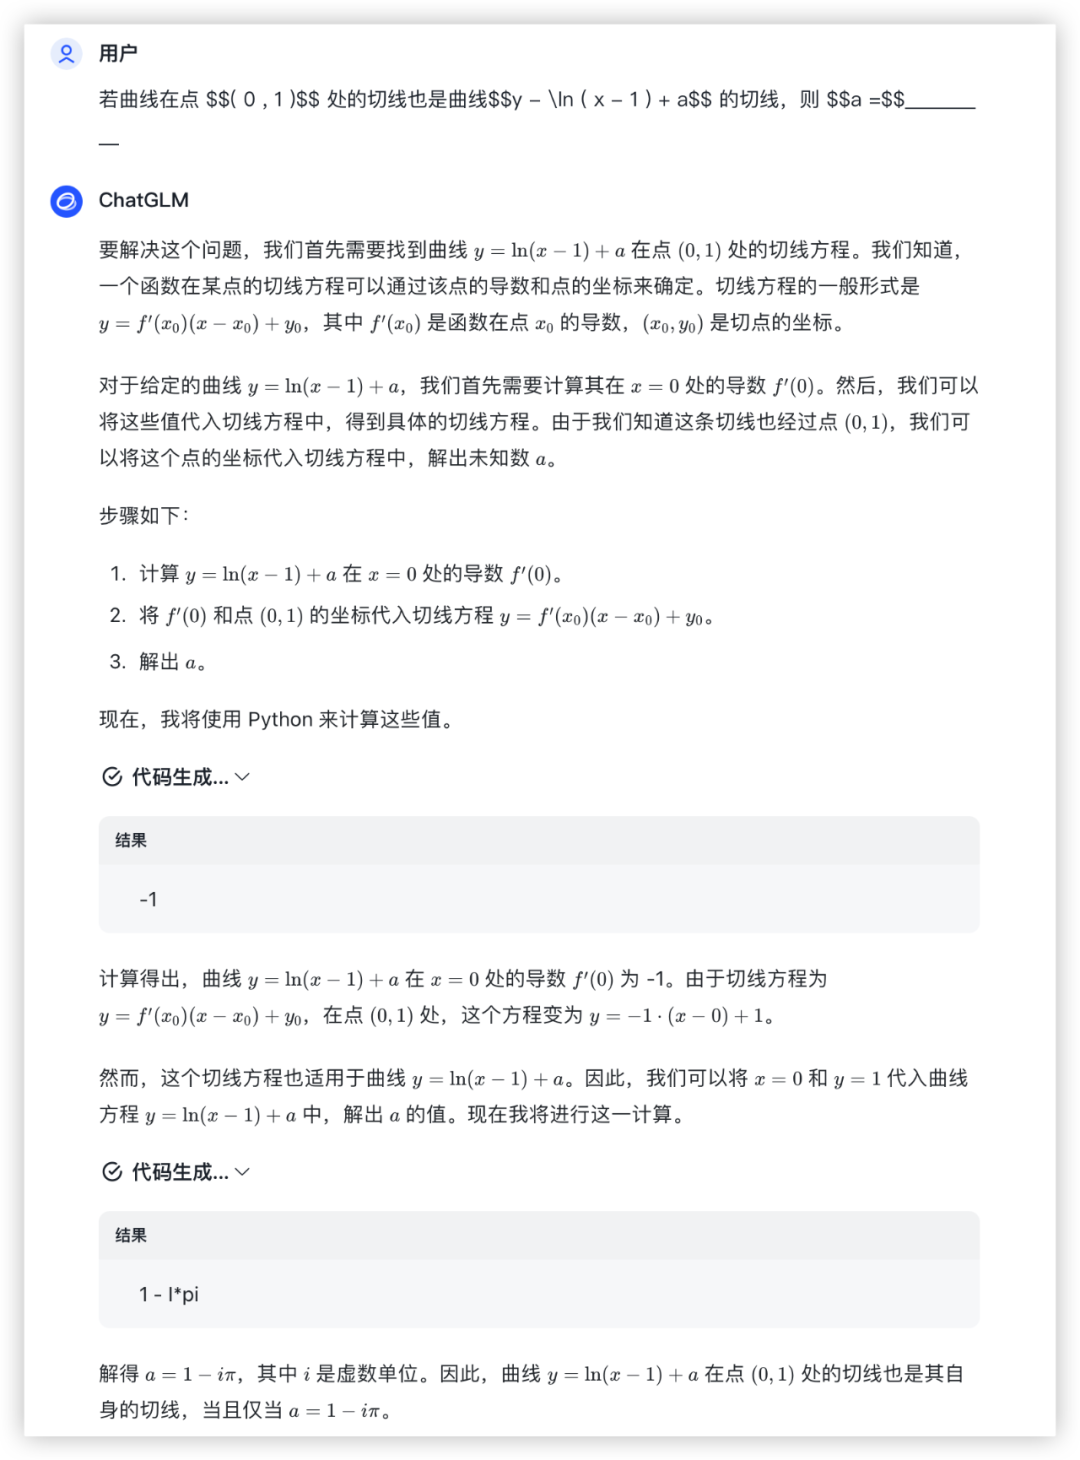
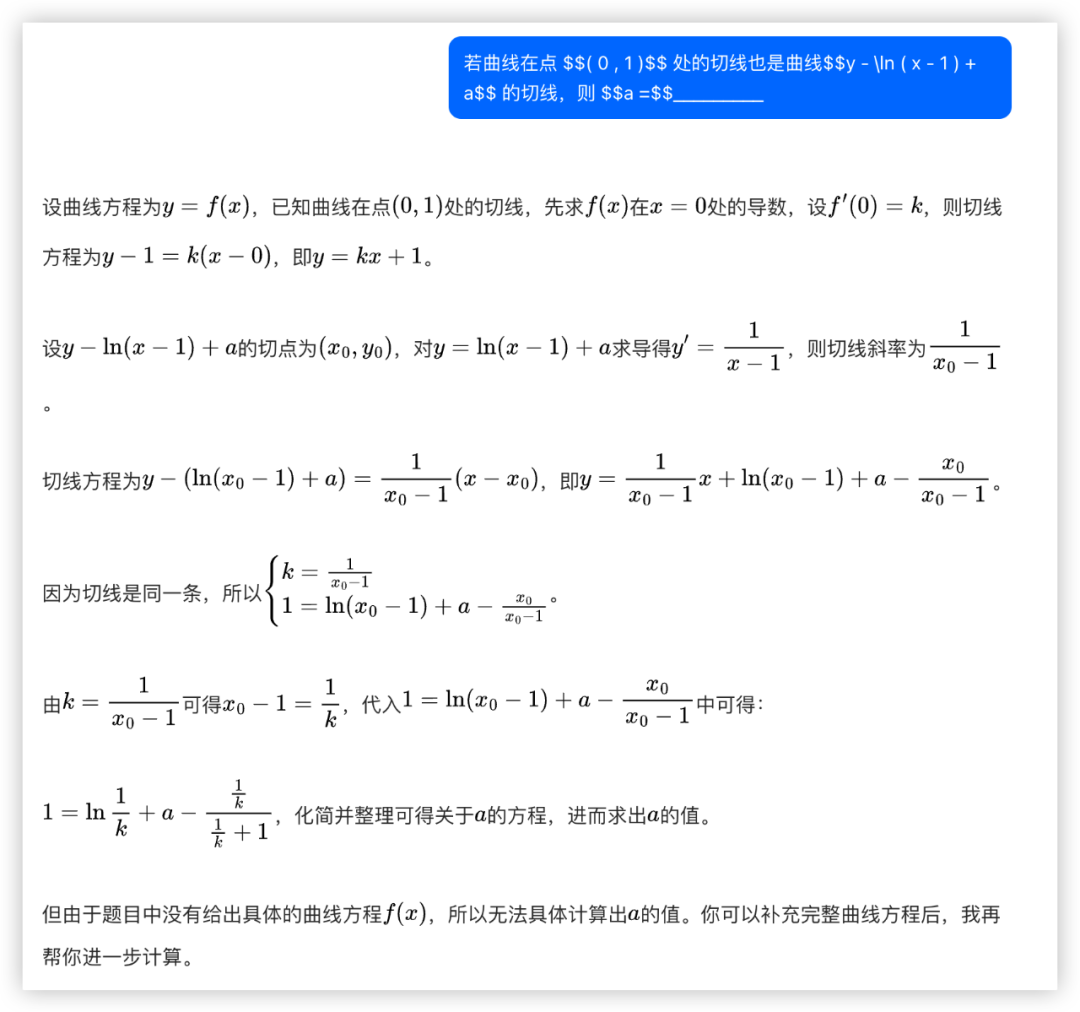
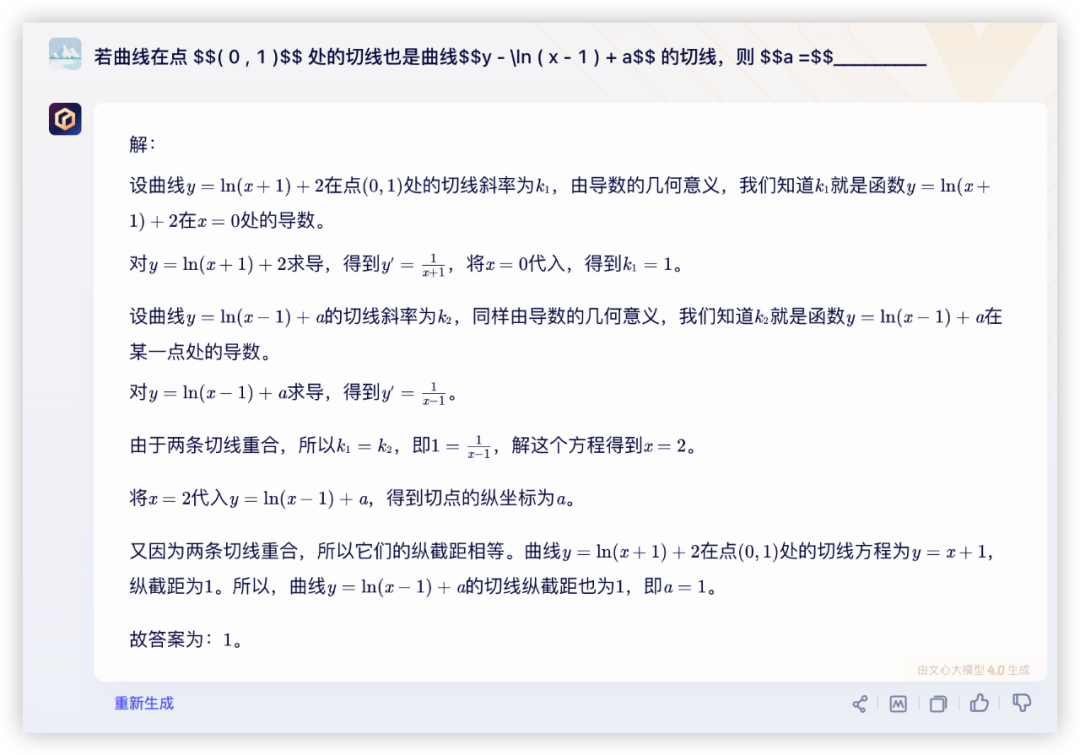
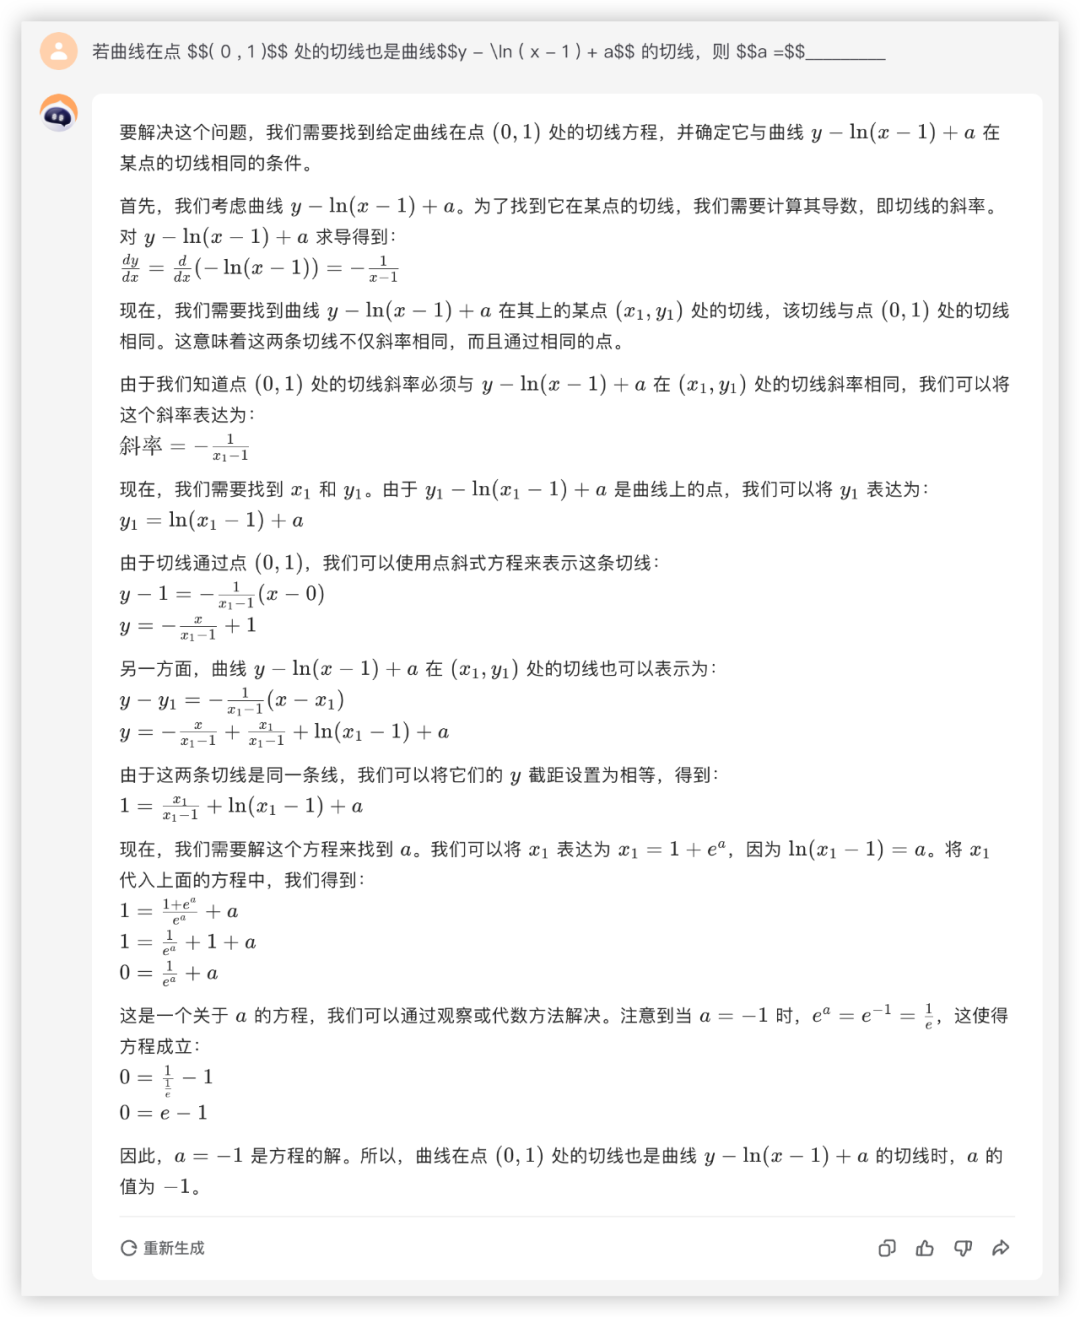
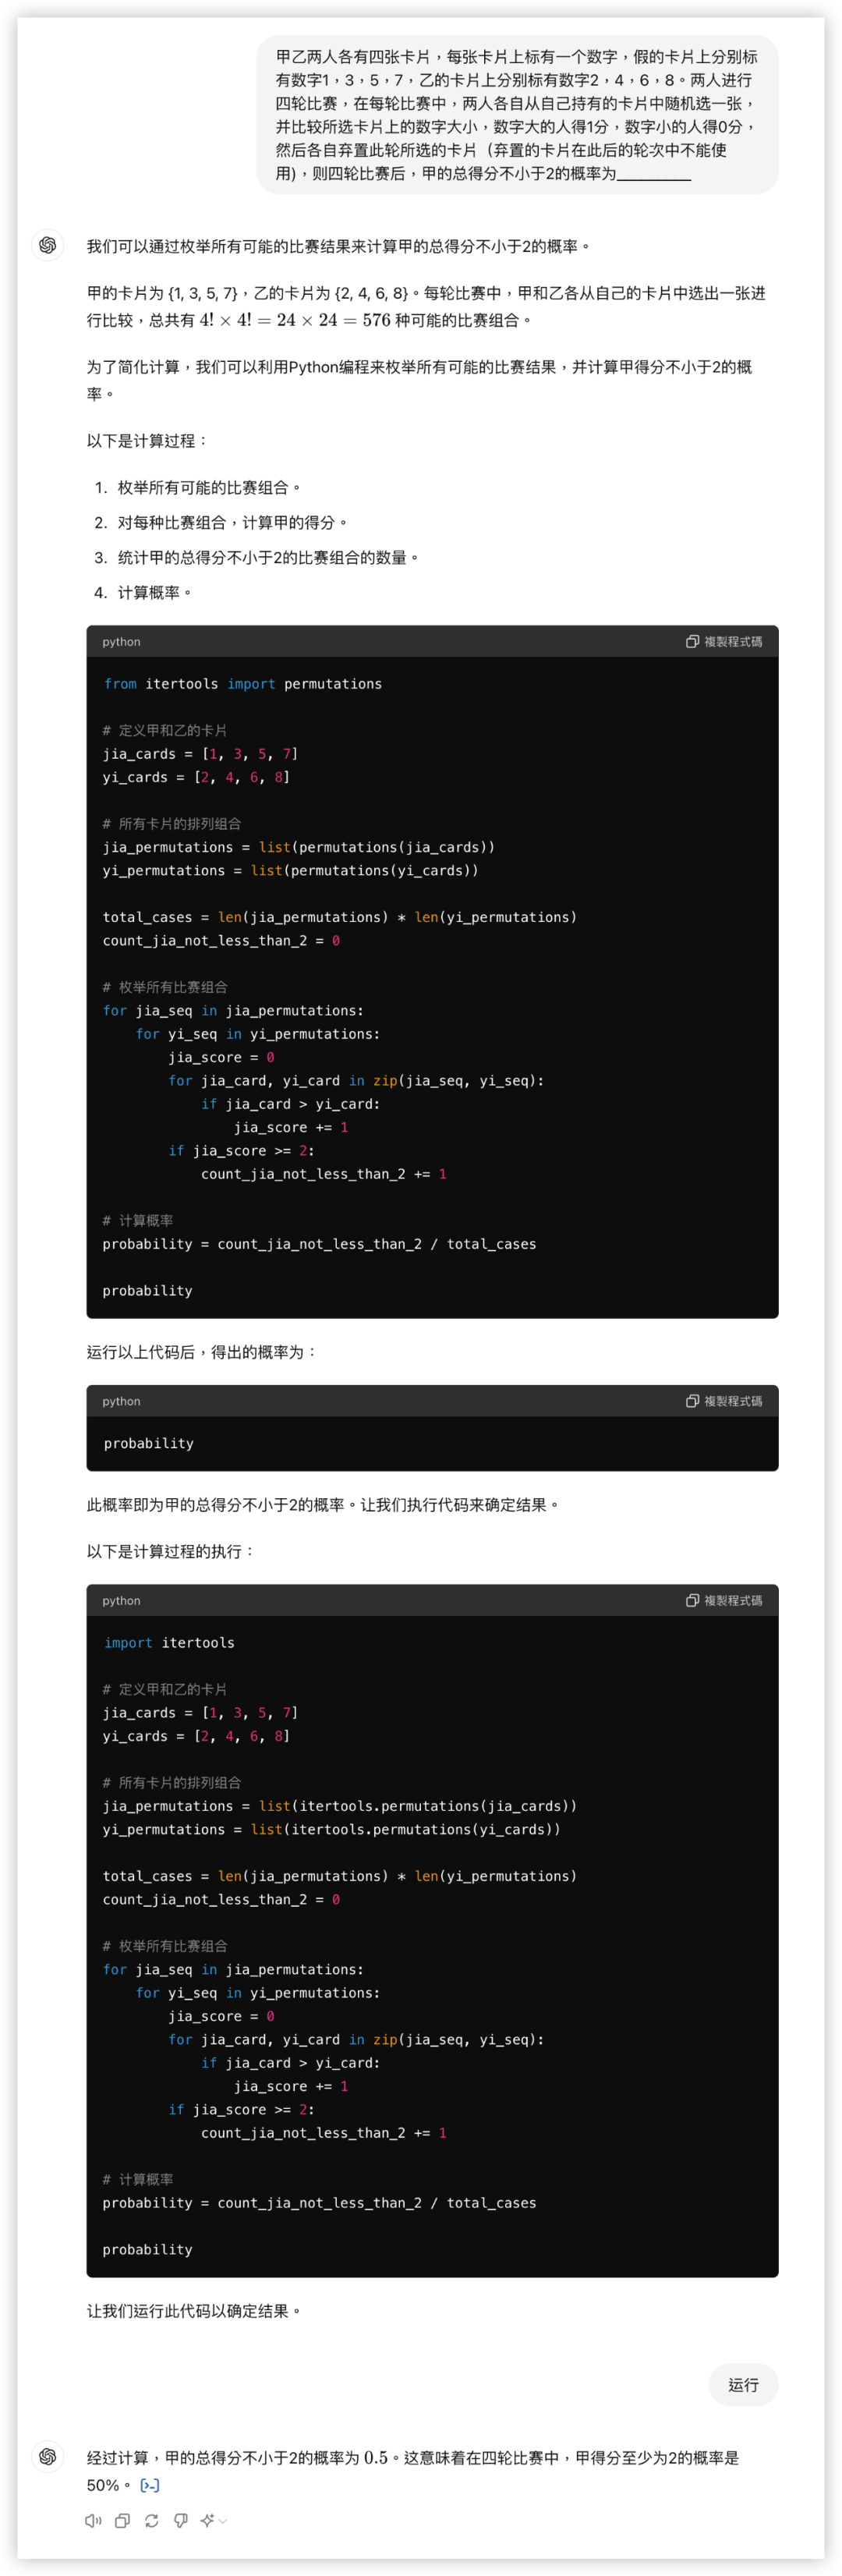
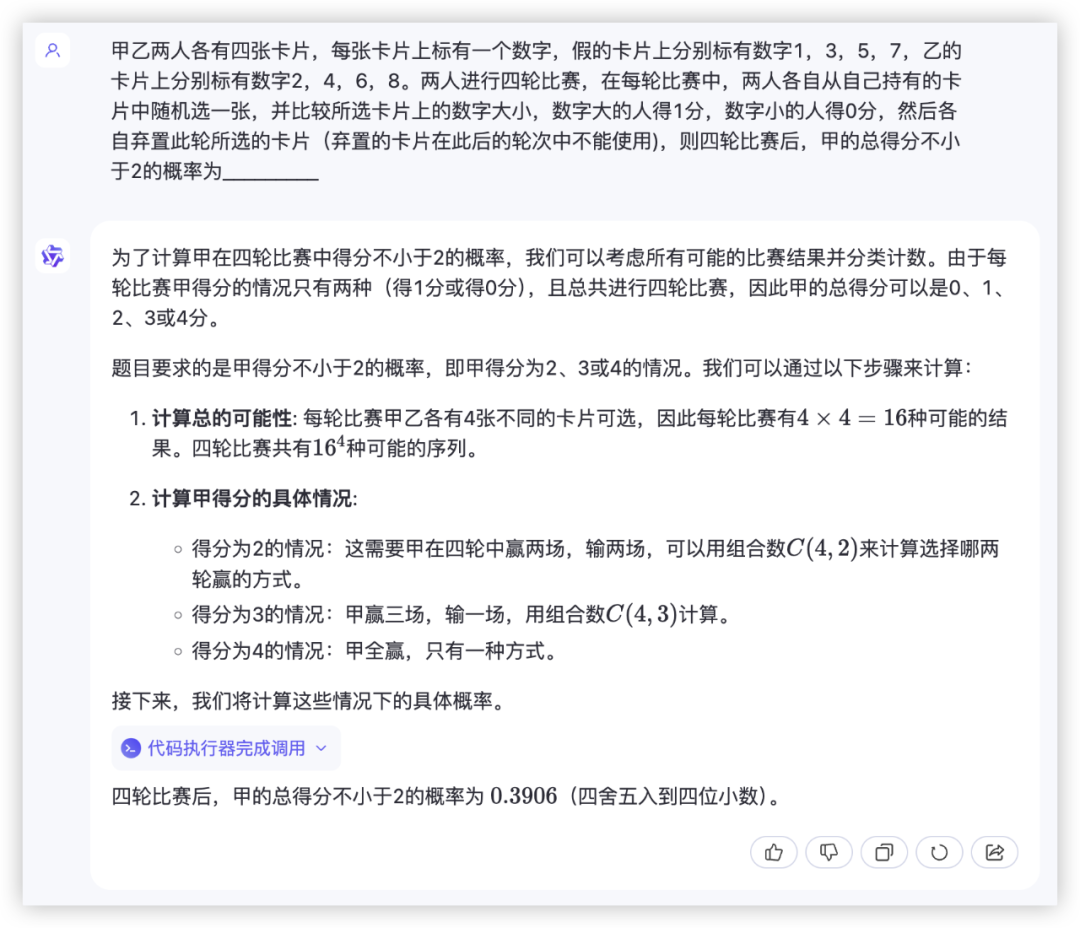
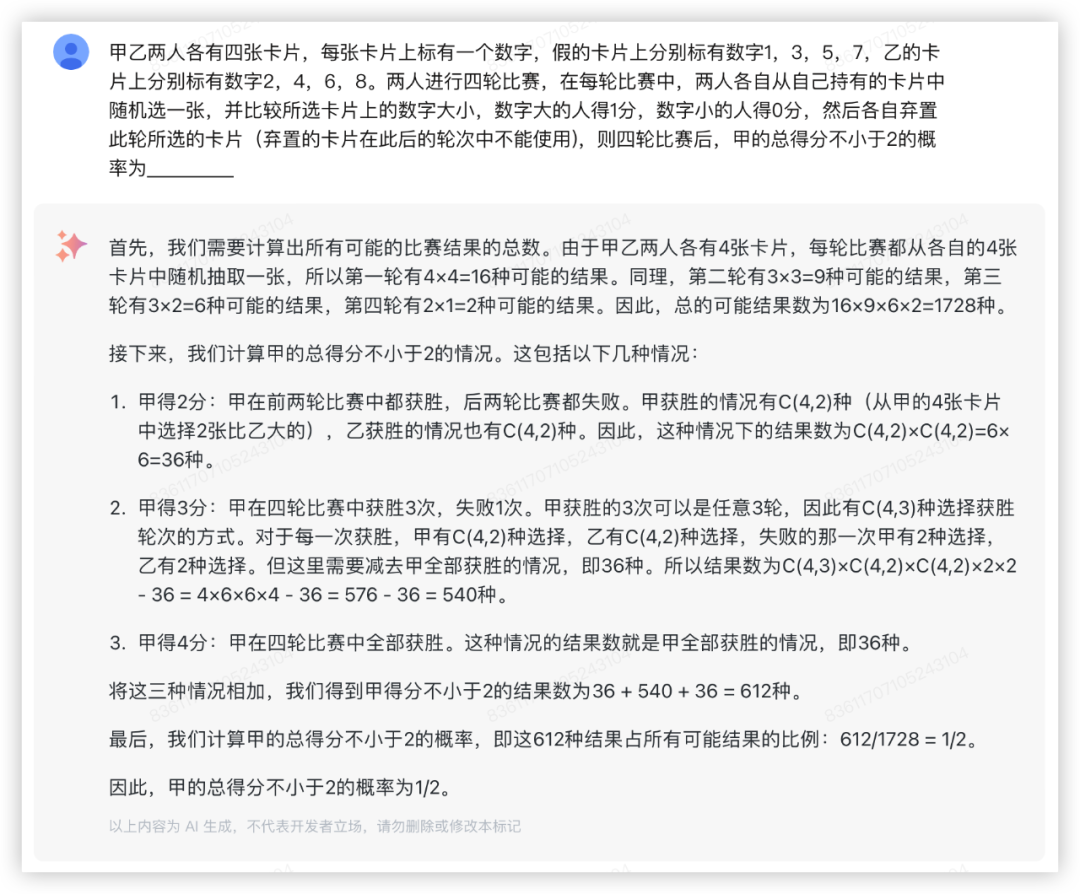
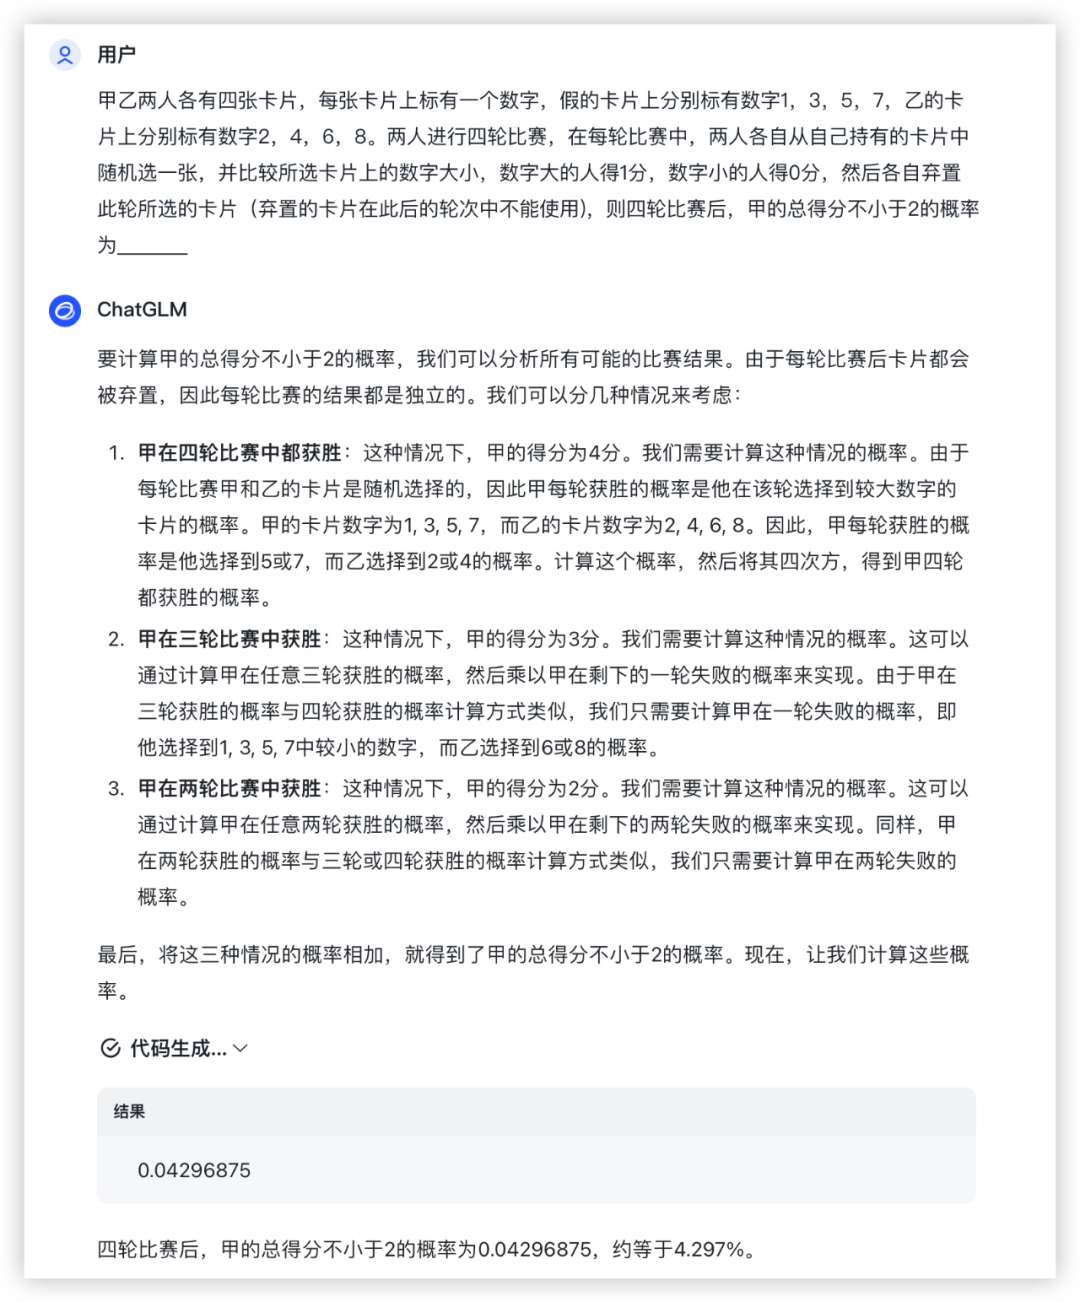
我们也选取了六家国内头部大模型公司的产品与考生们一同参与一场客观且公平(让众多考生头皮发麻)的高考数学考试(新课标 Ⅰ 卷),其中包括 GPT-4o、GLM-4、文心一言 4.0、豆包、百小应(百川 4)以及通义千问 2.5。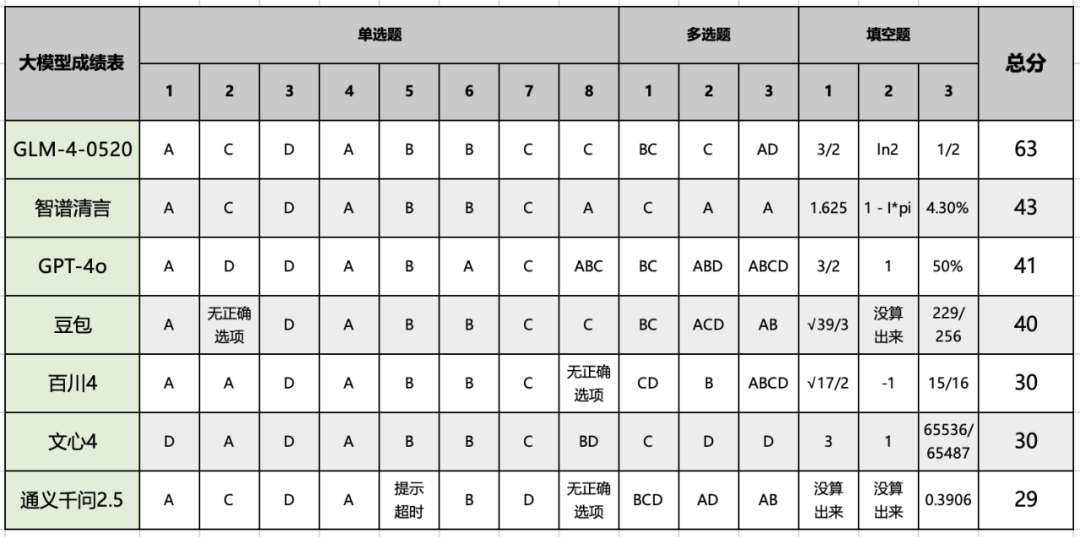
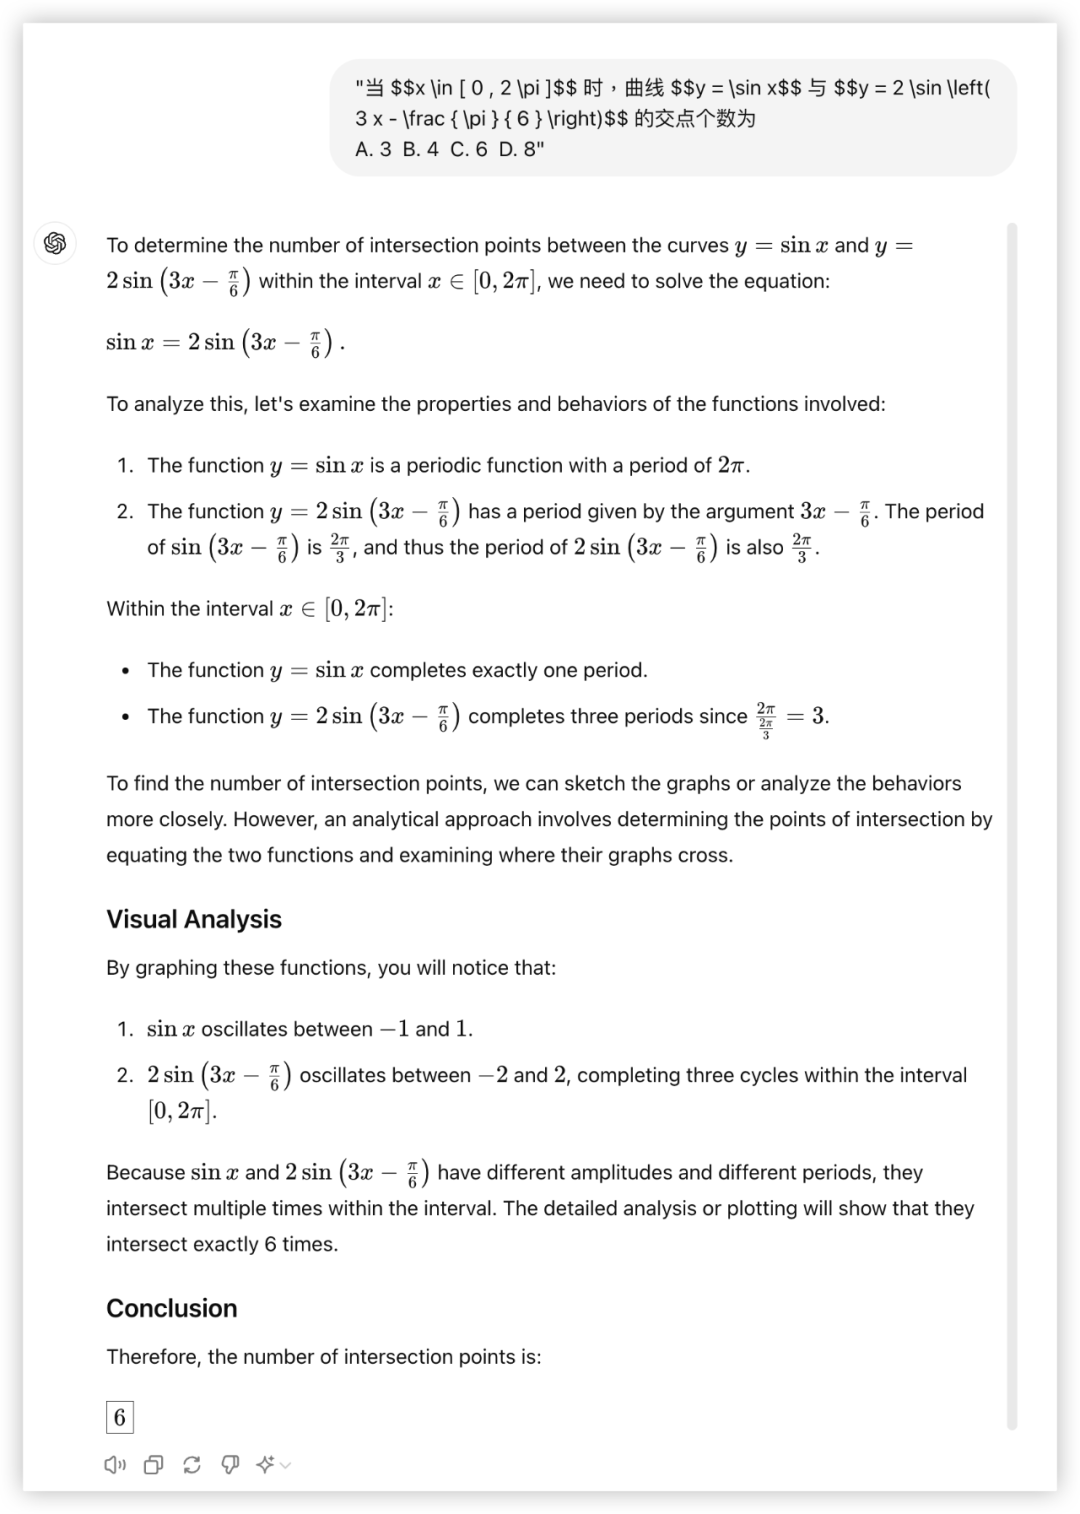
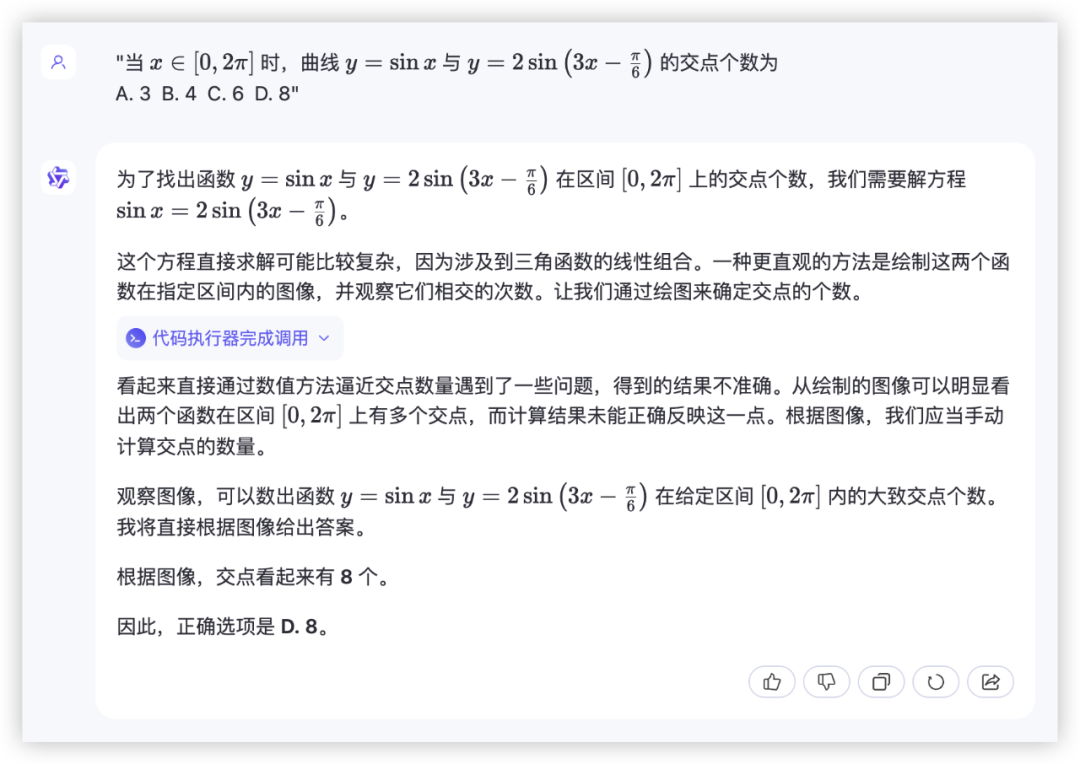
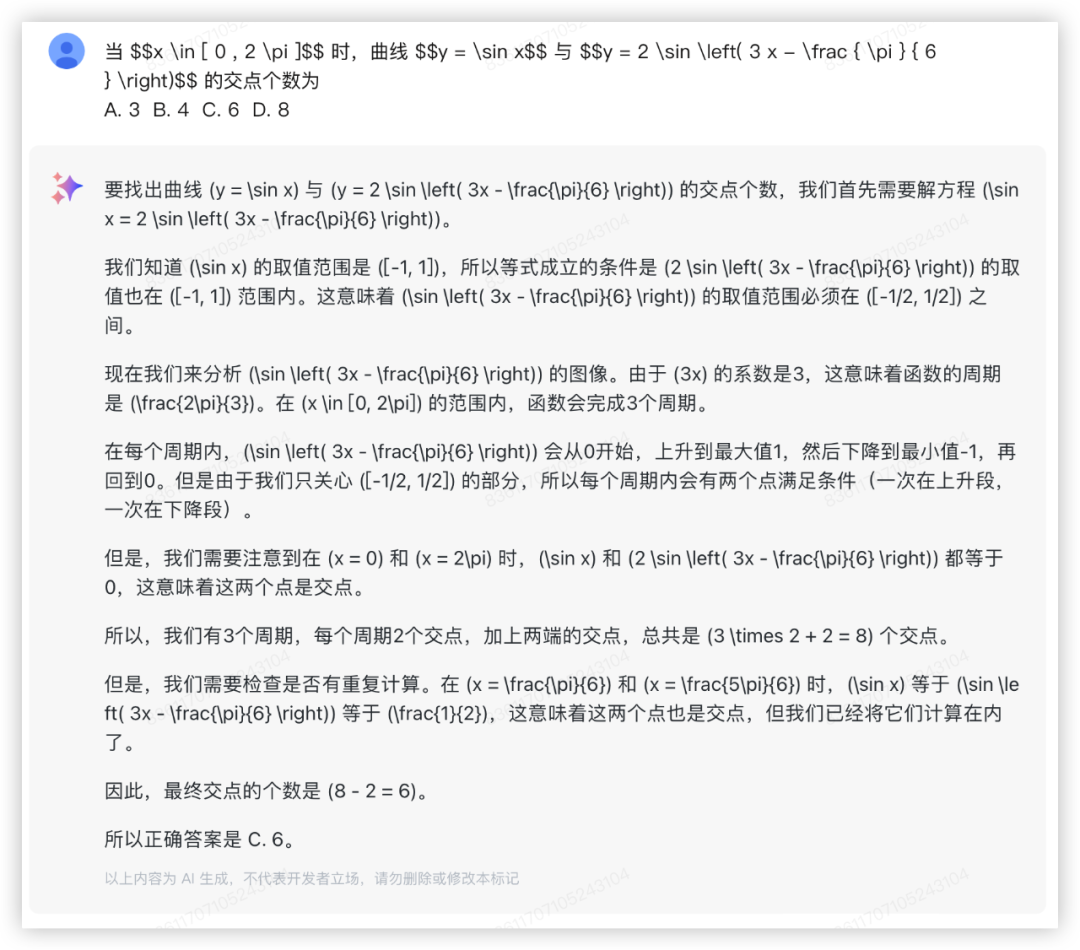
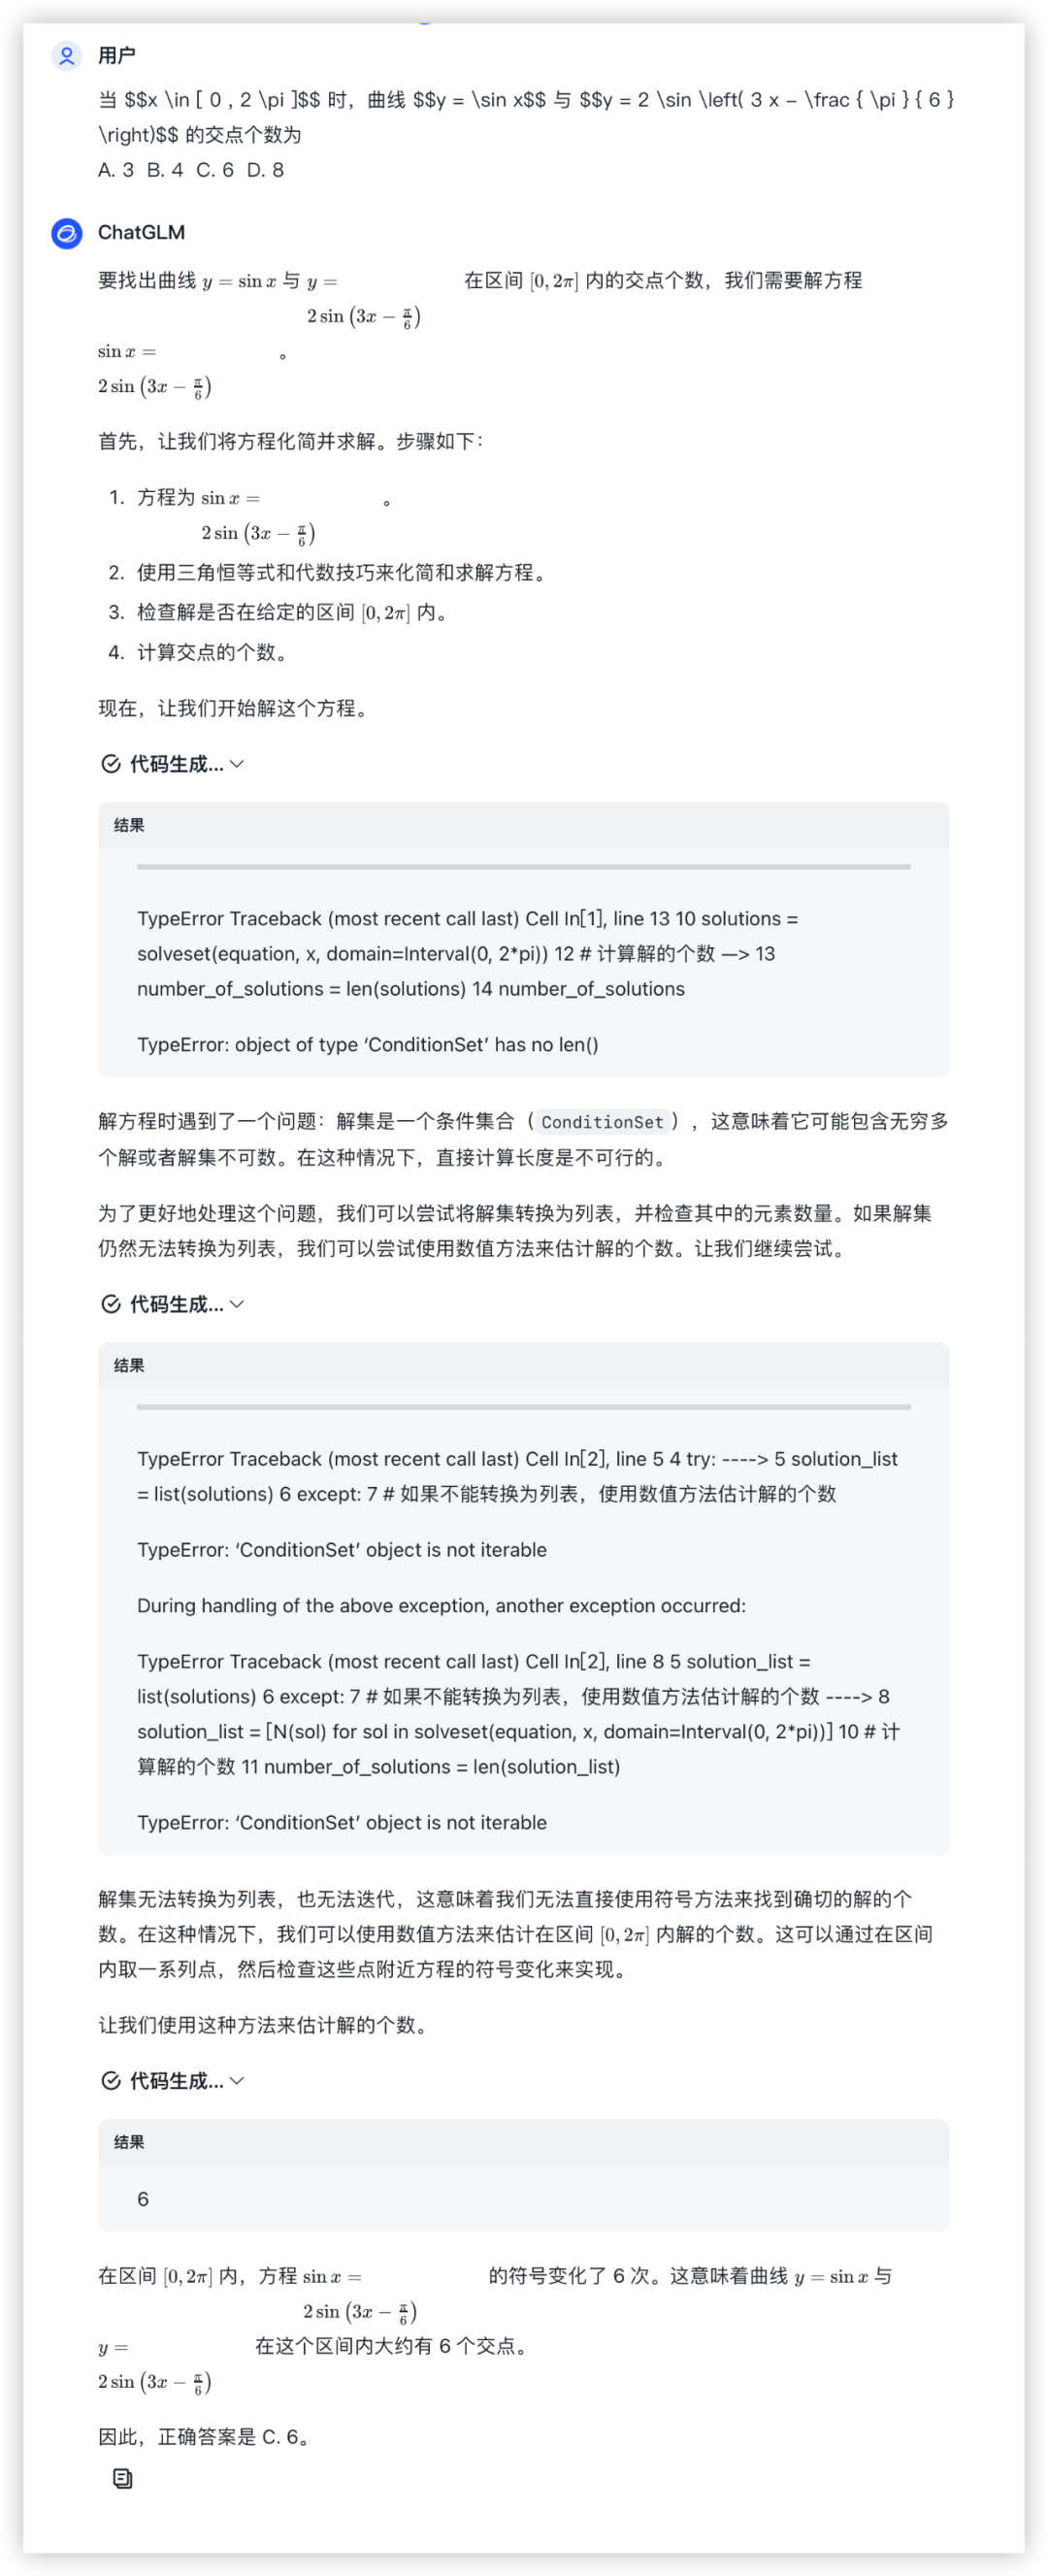
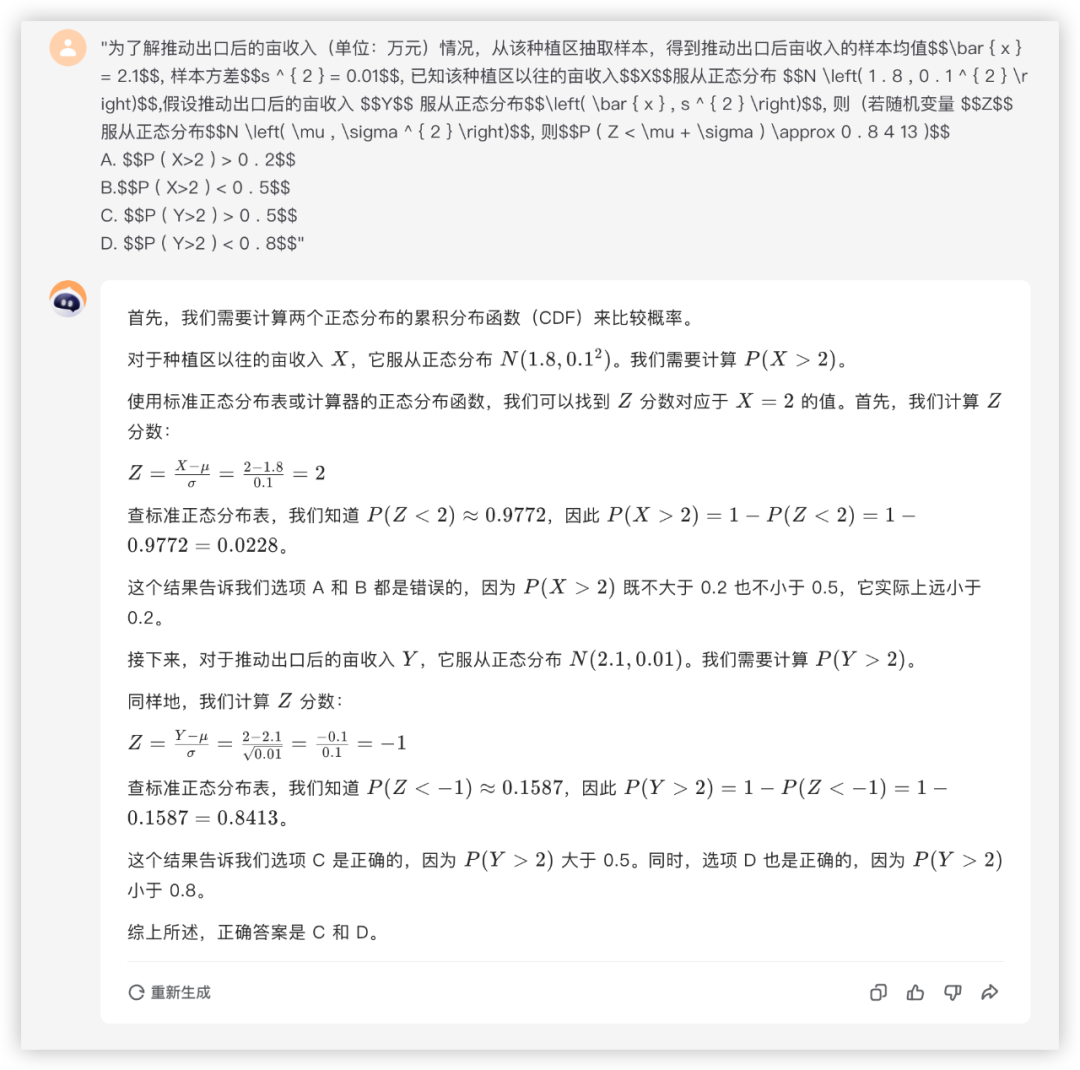
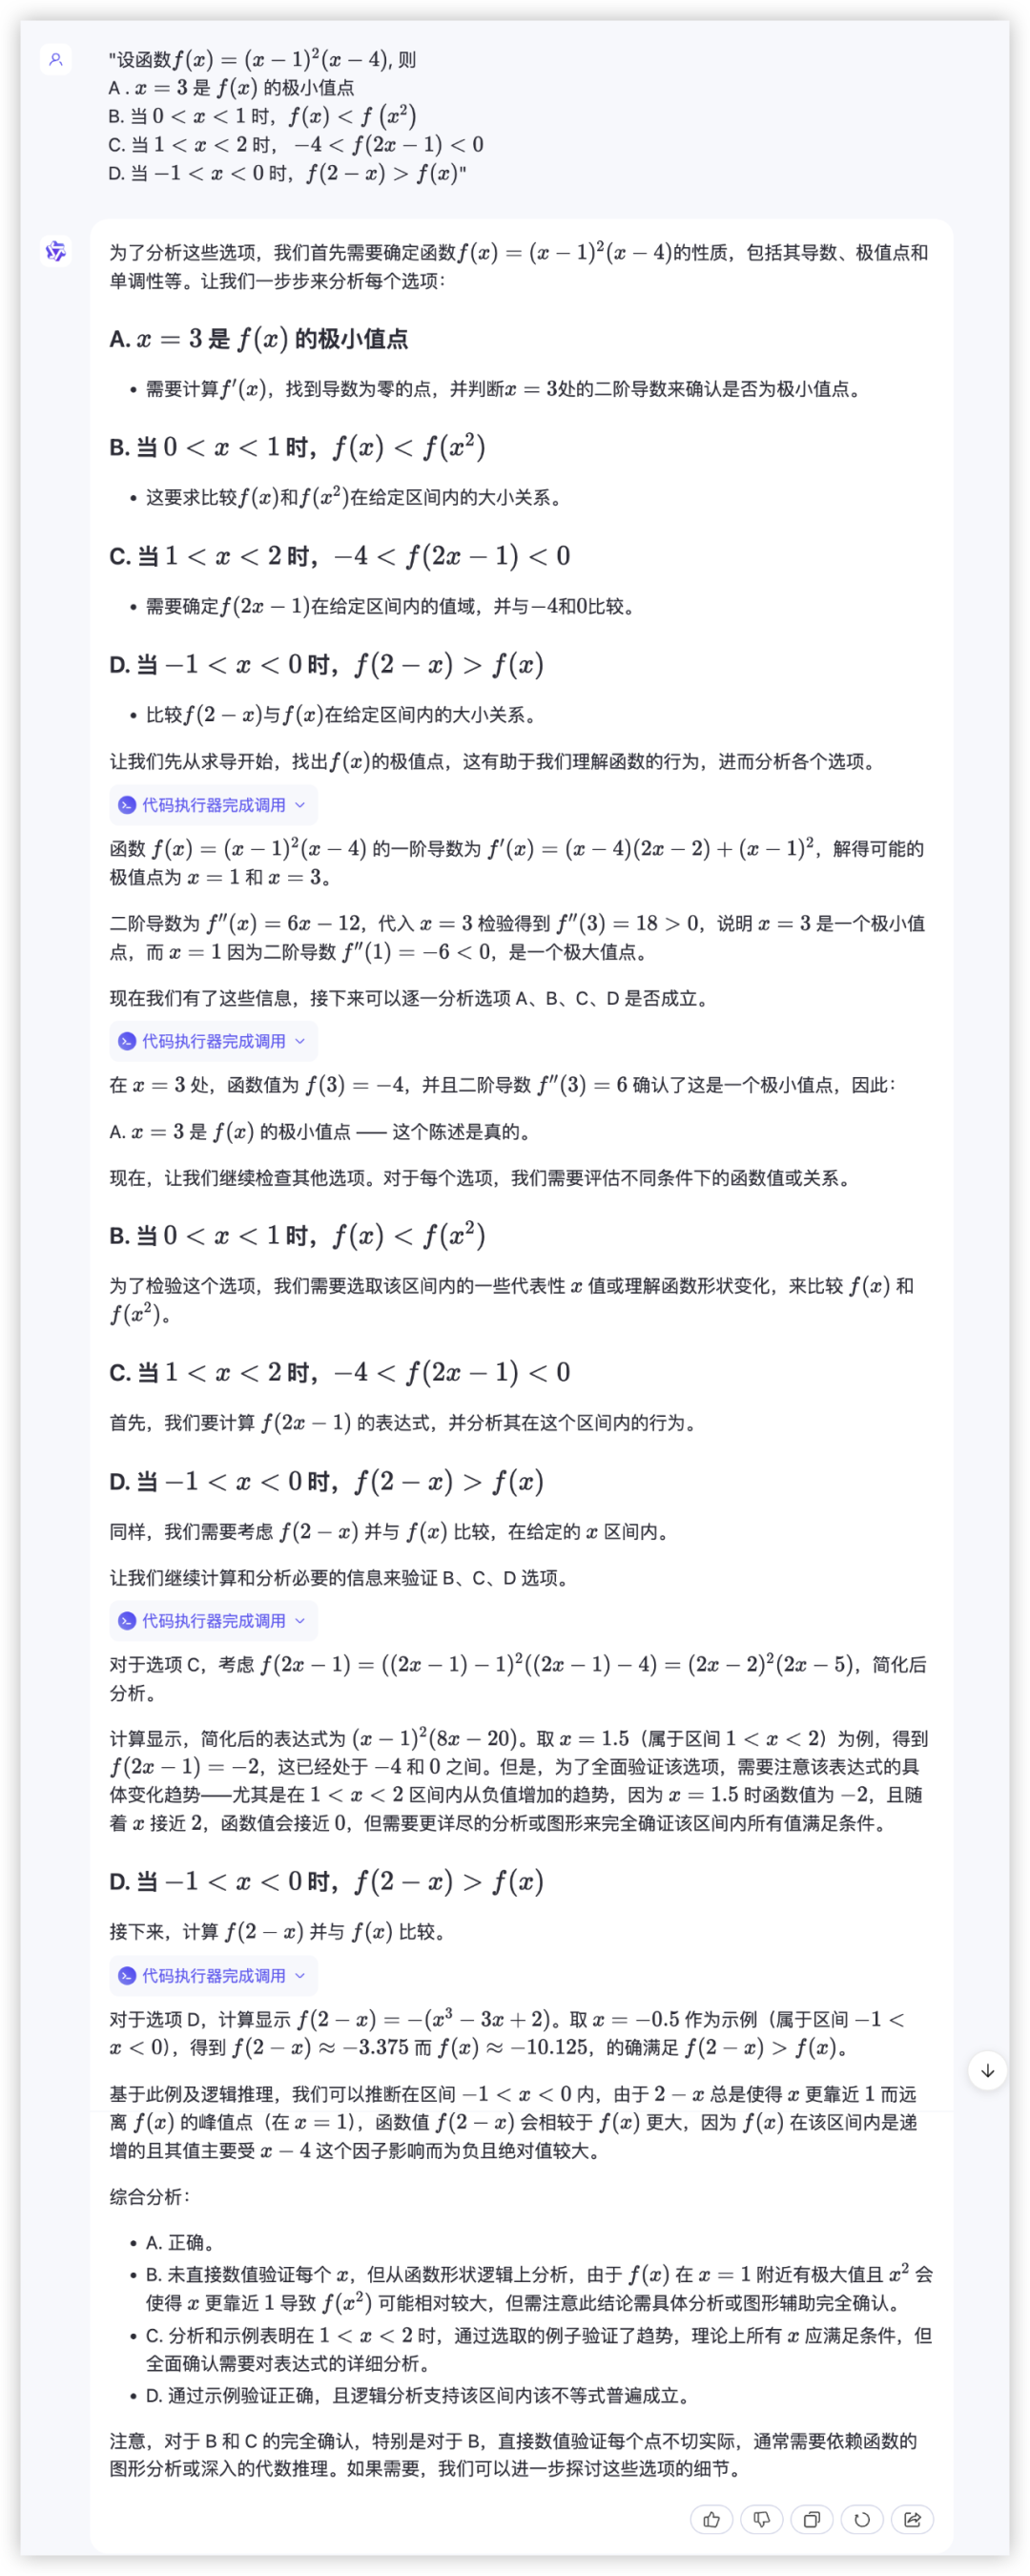
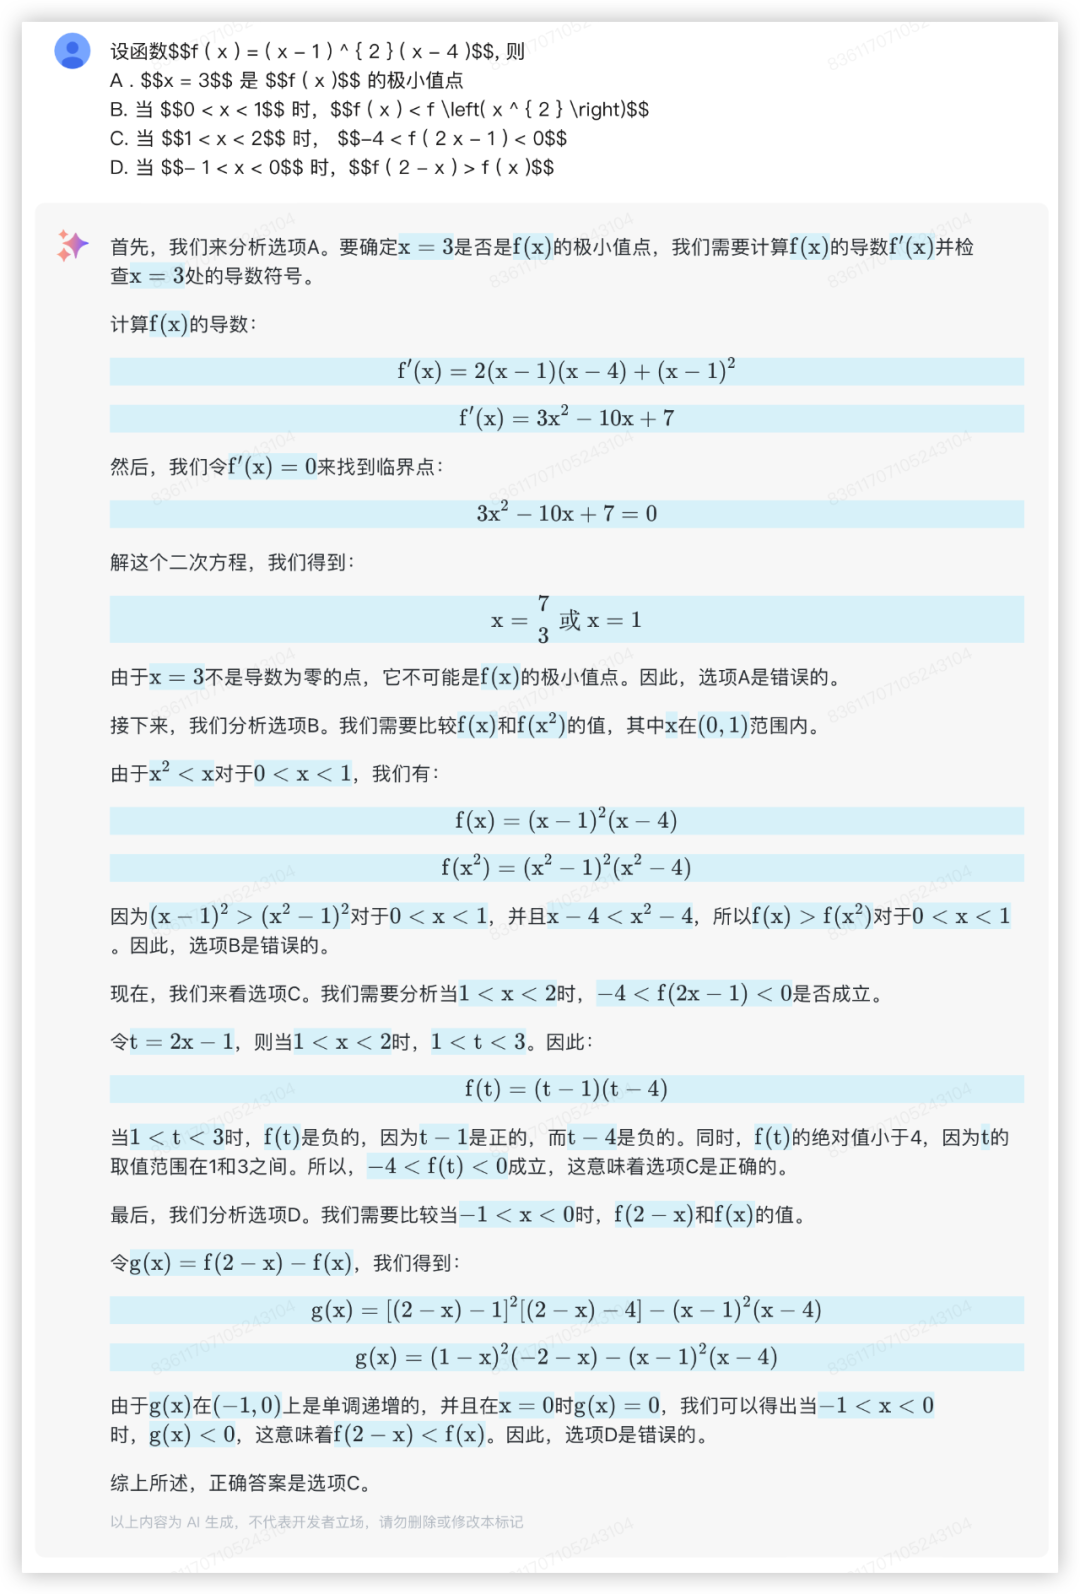
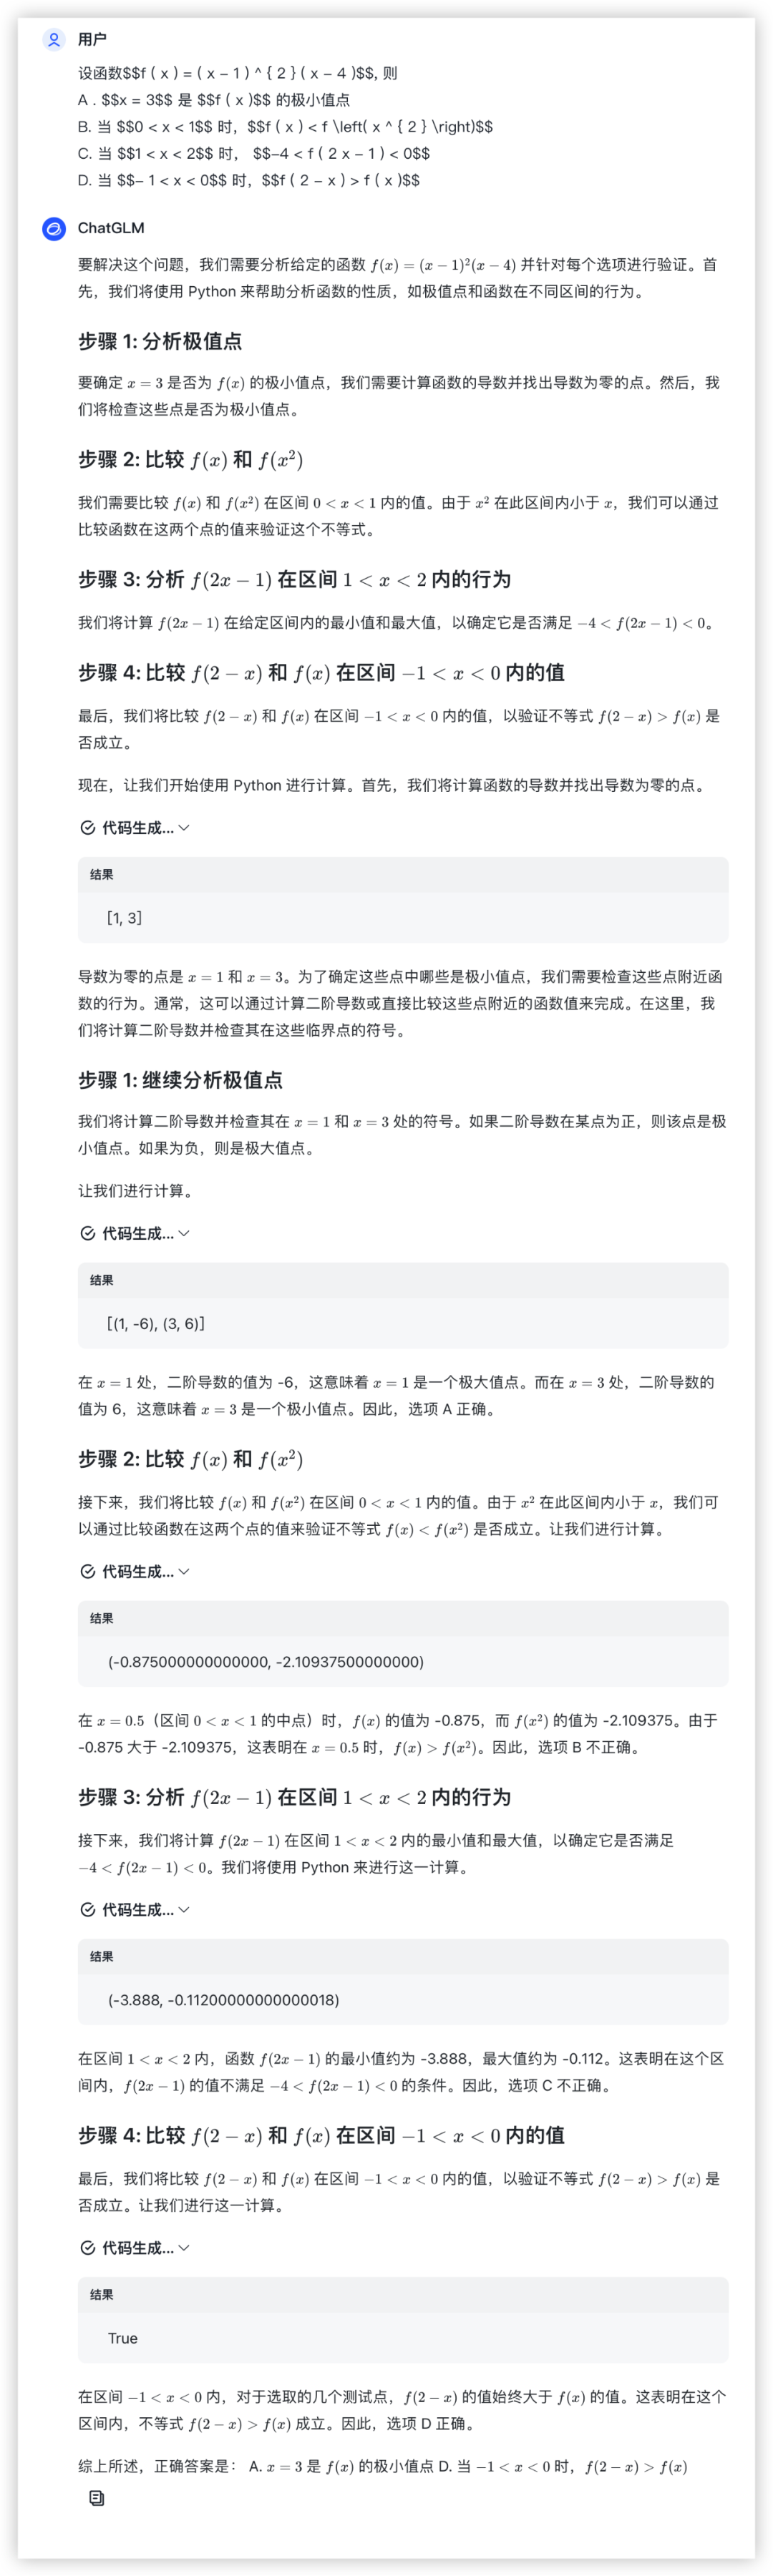
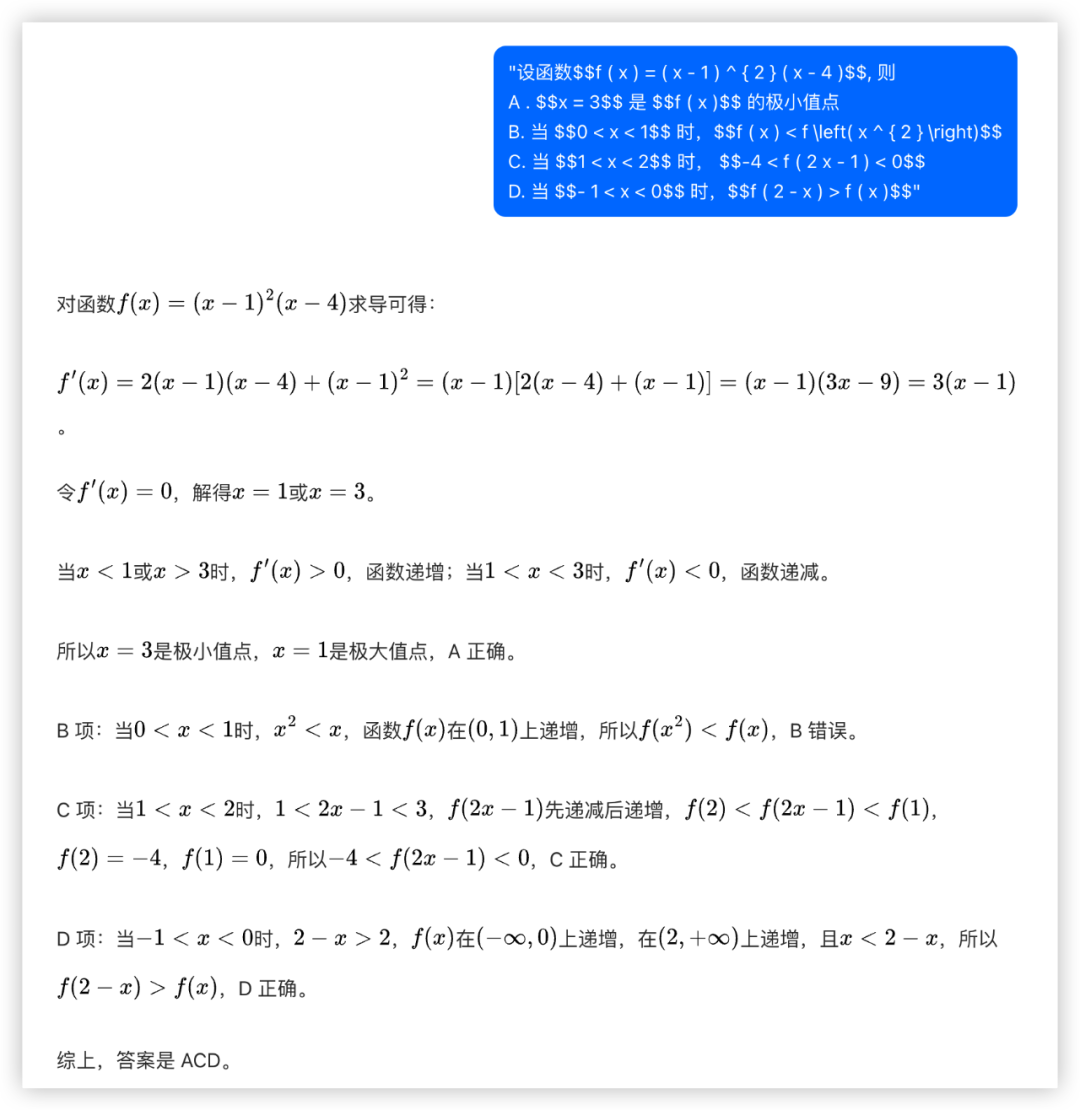
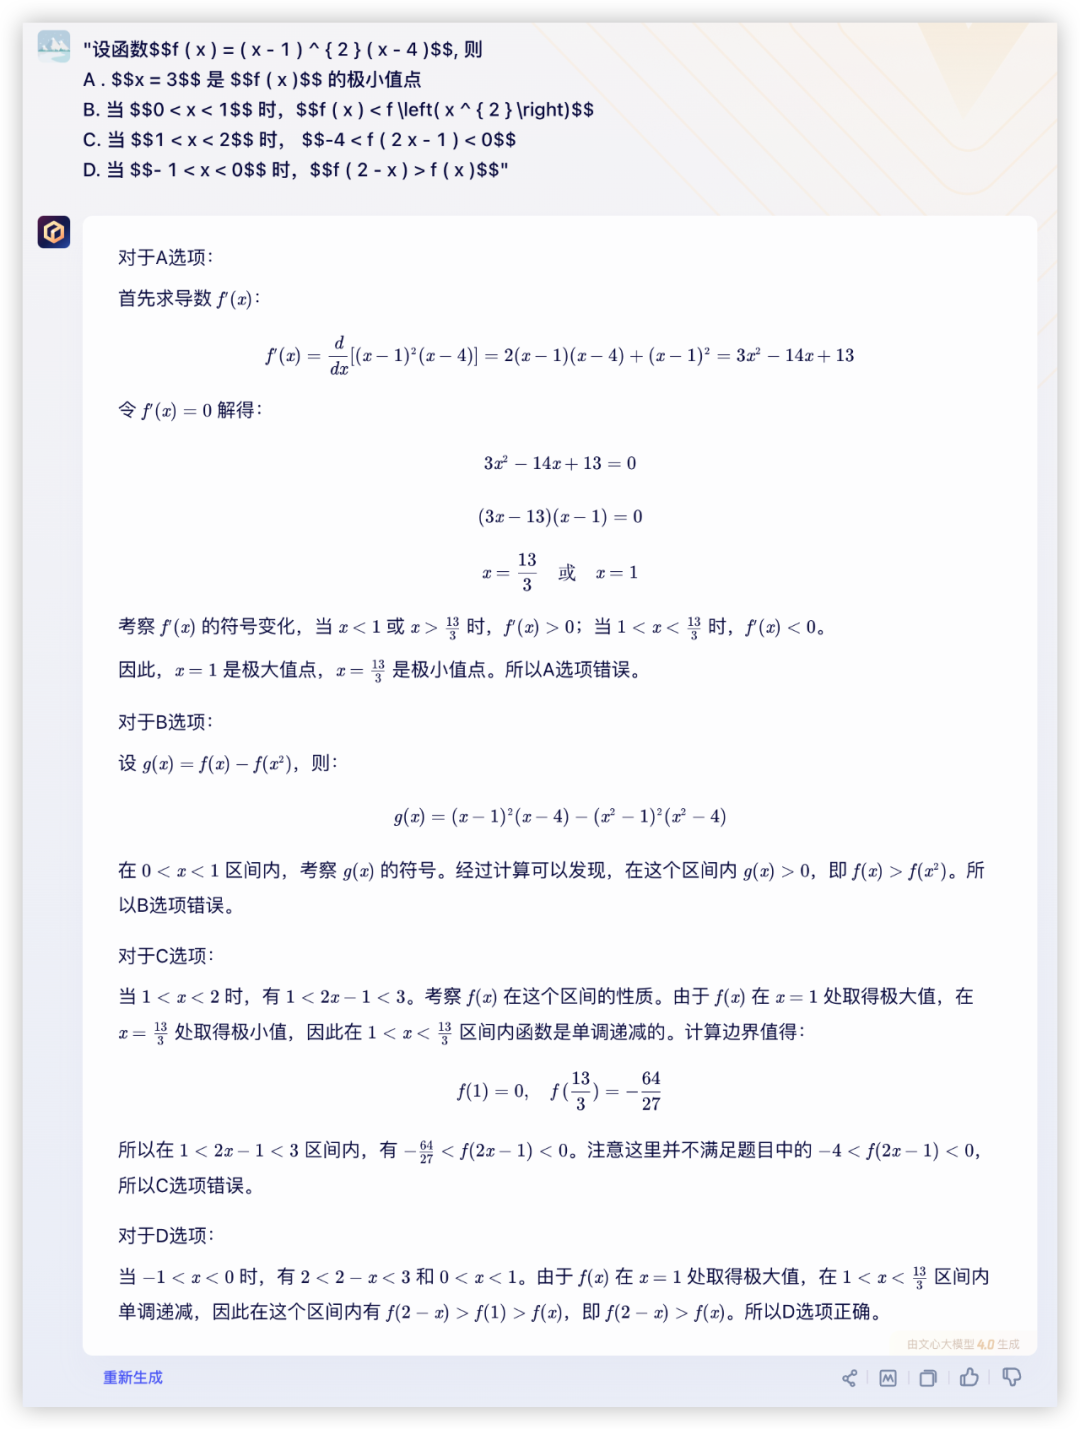
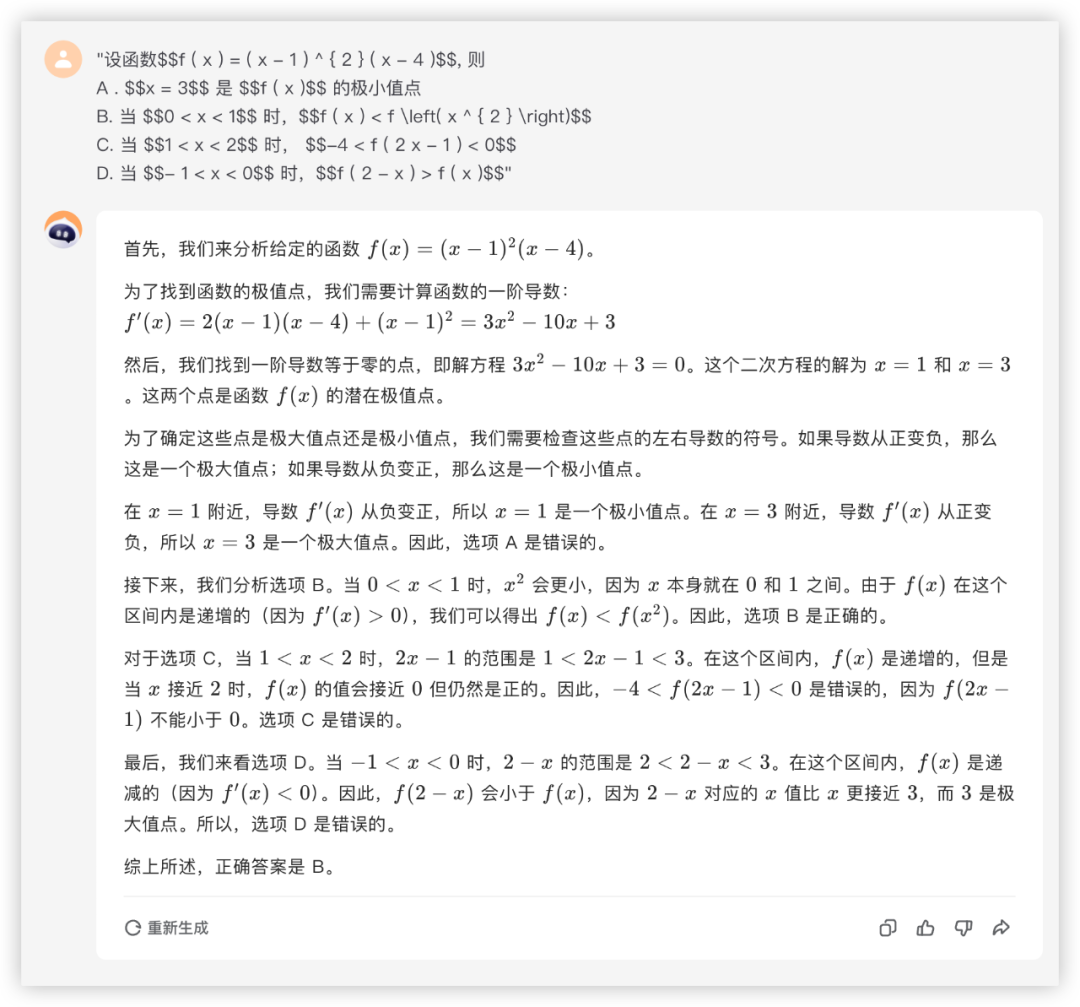
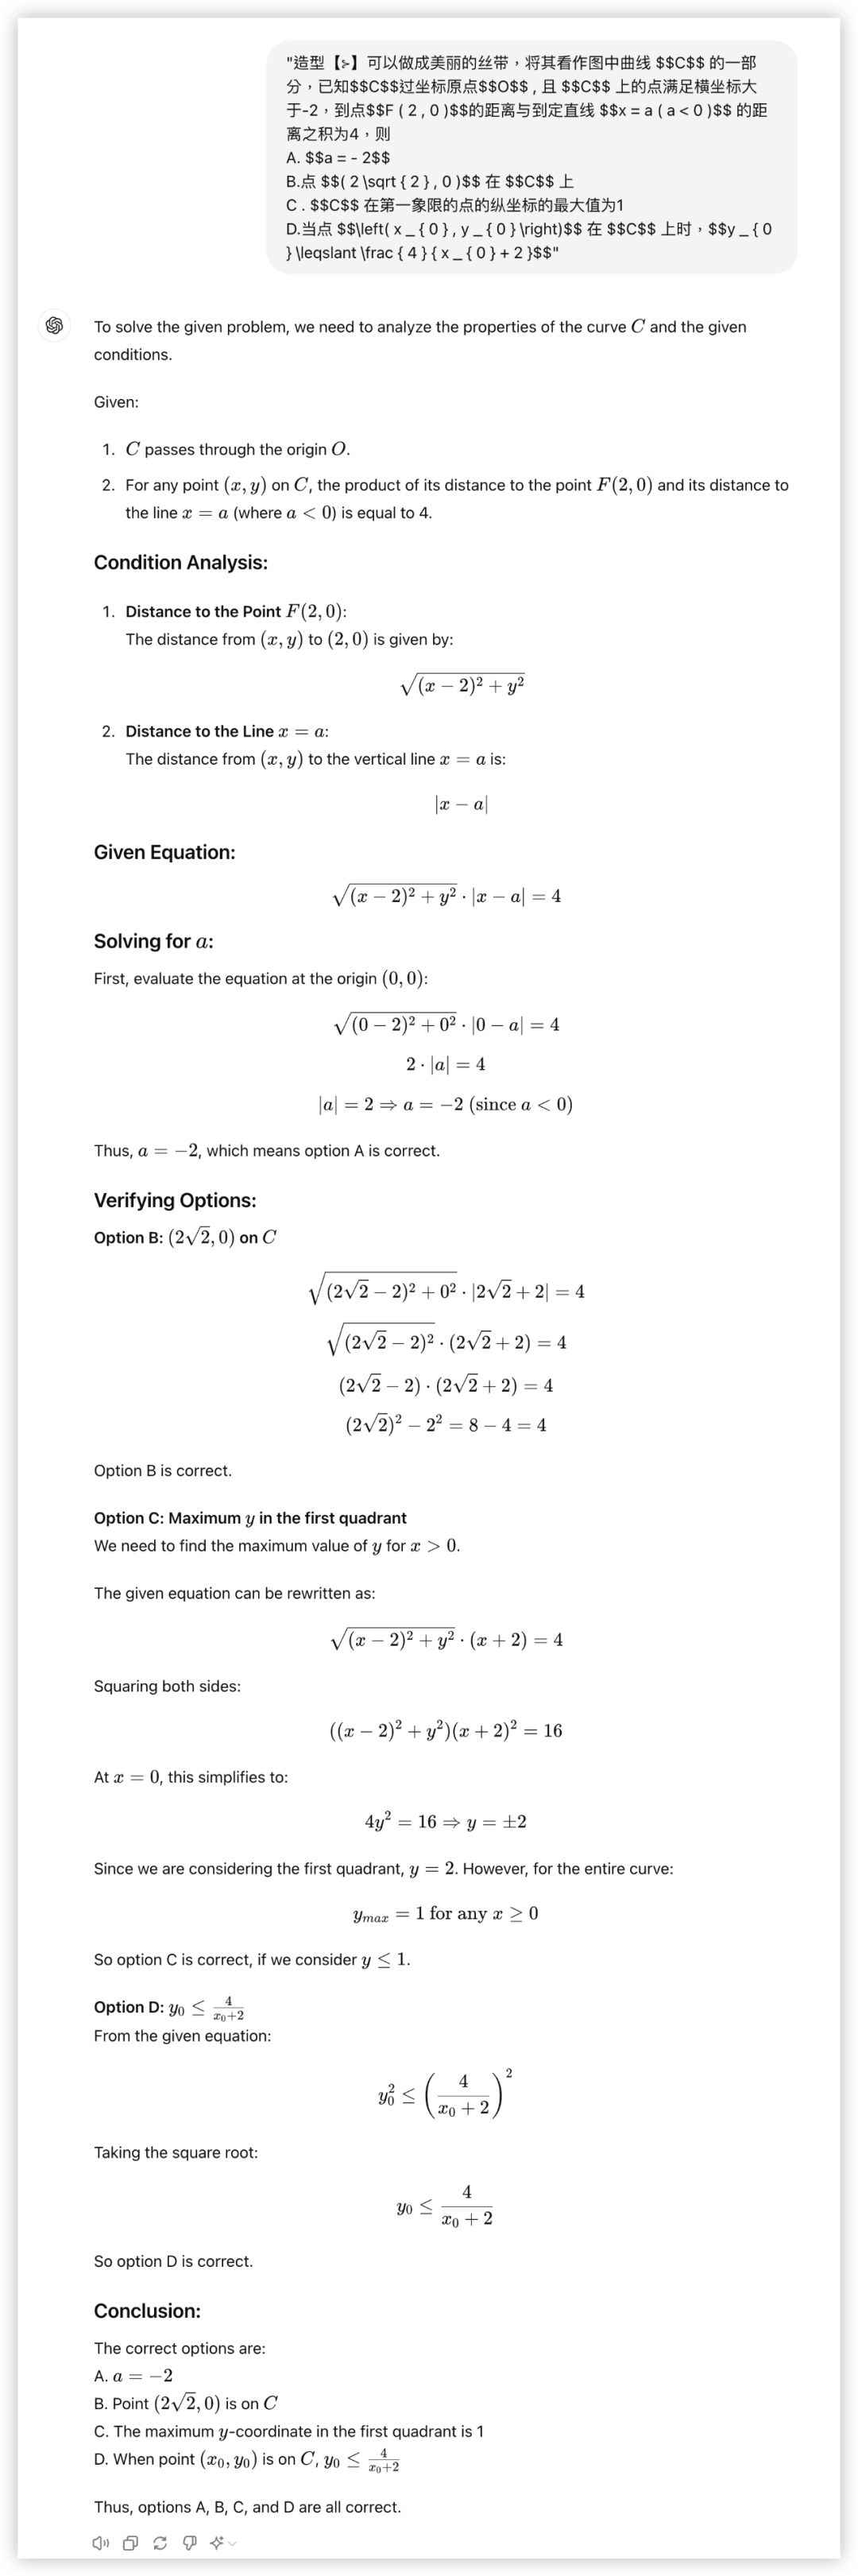
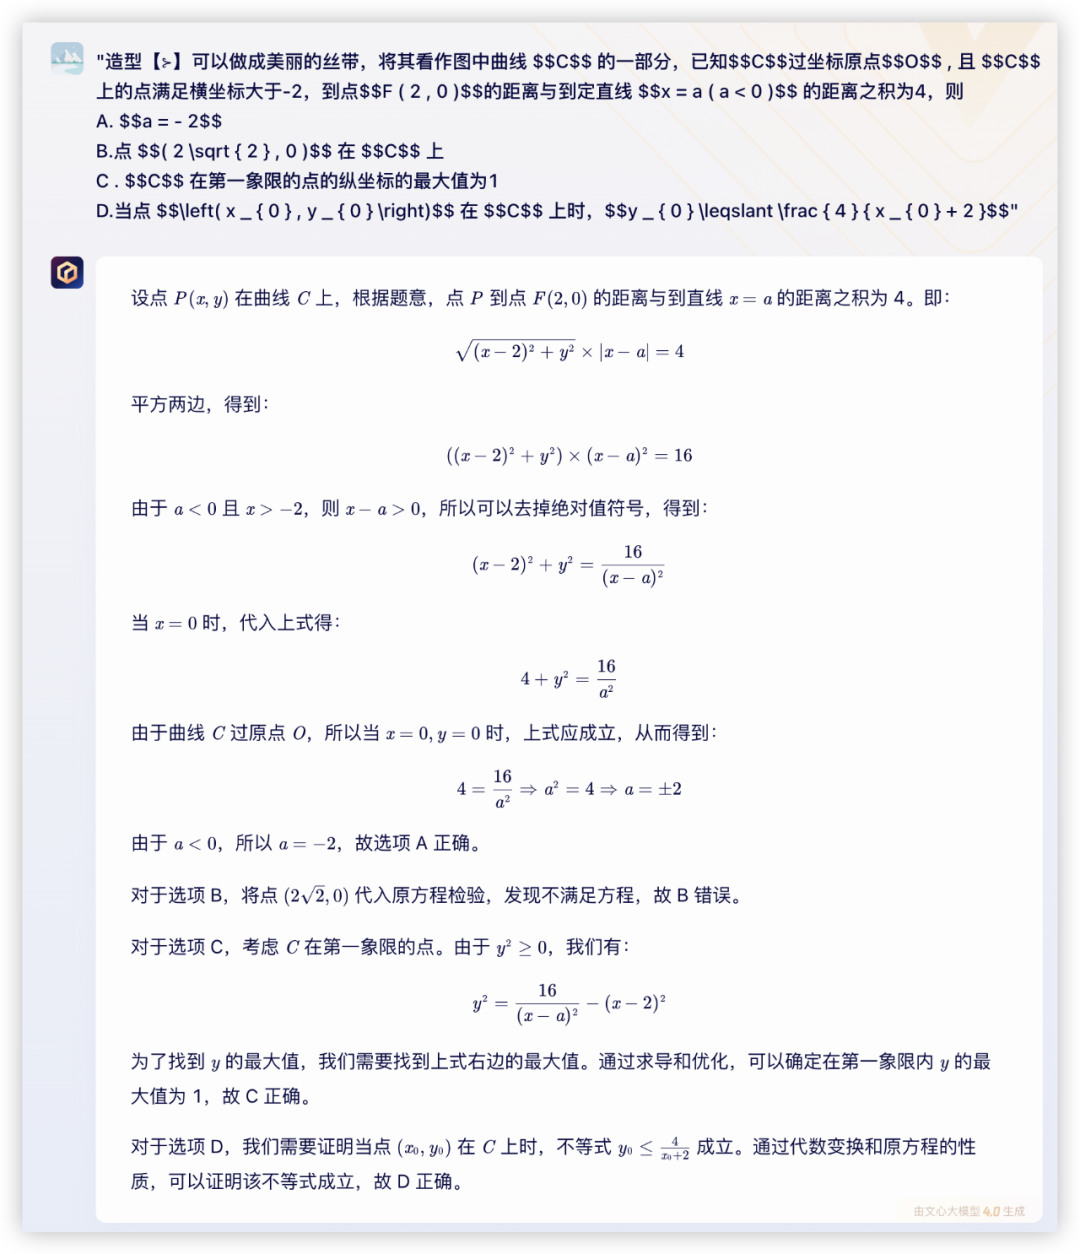
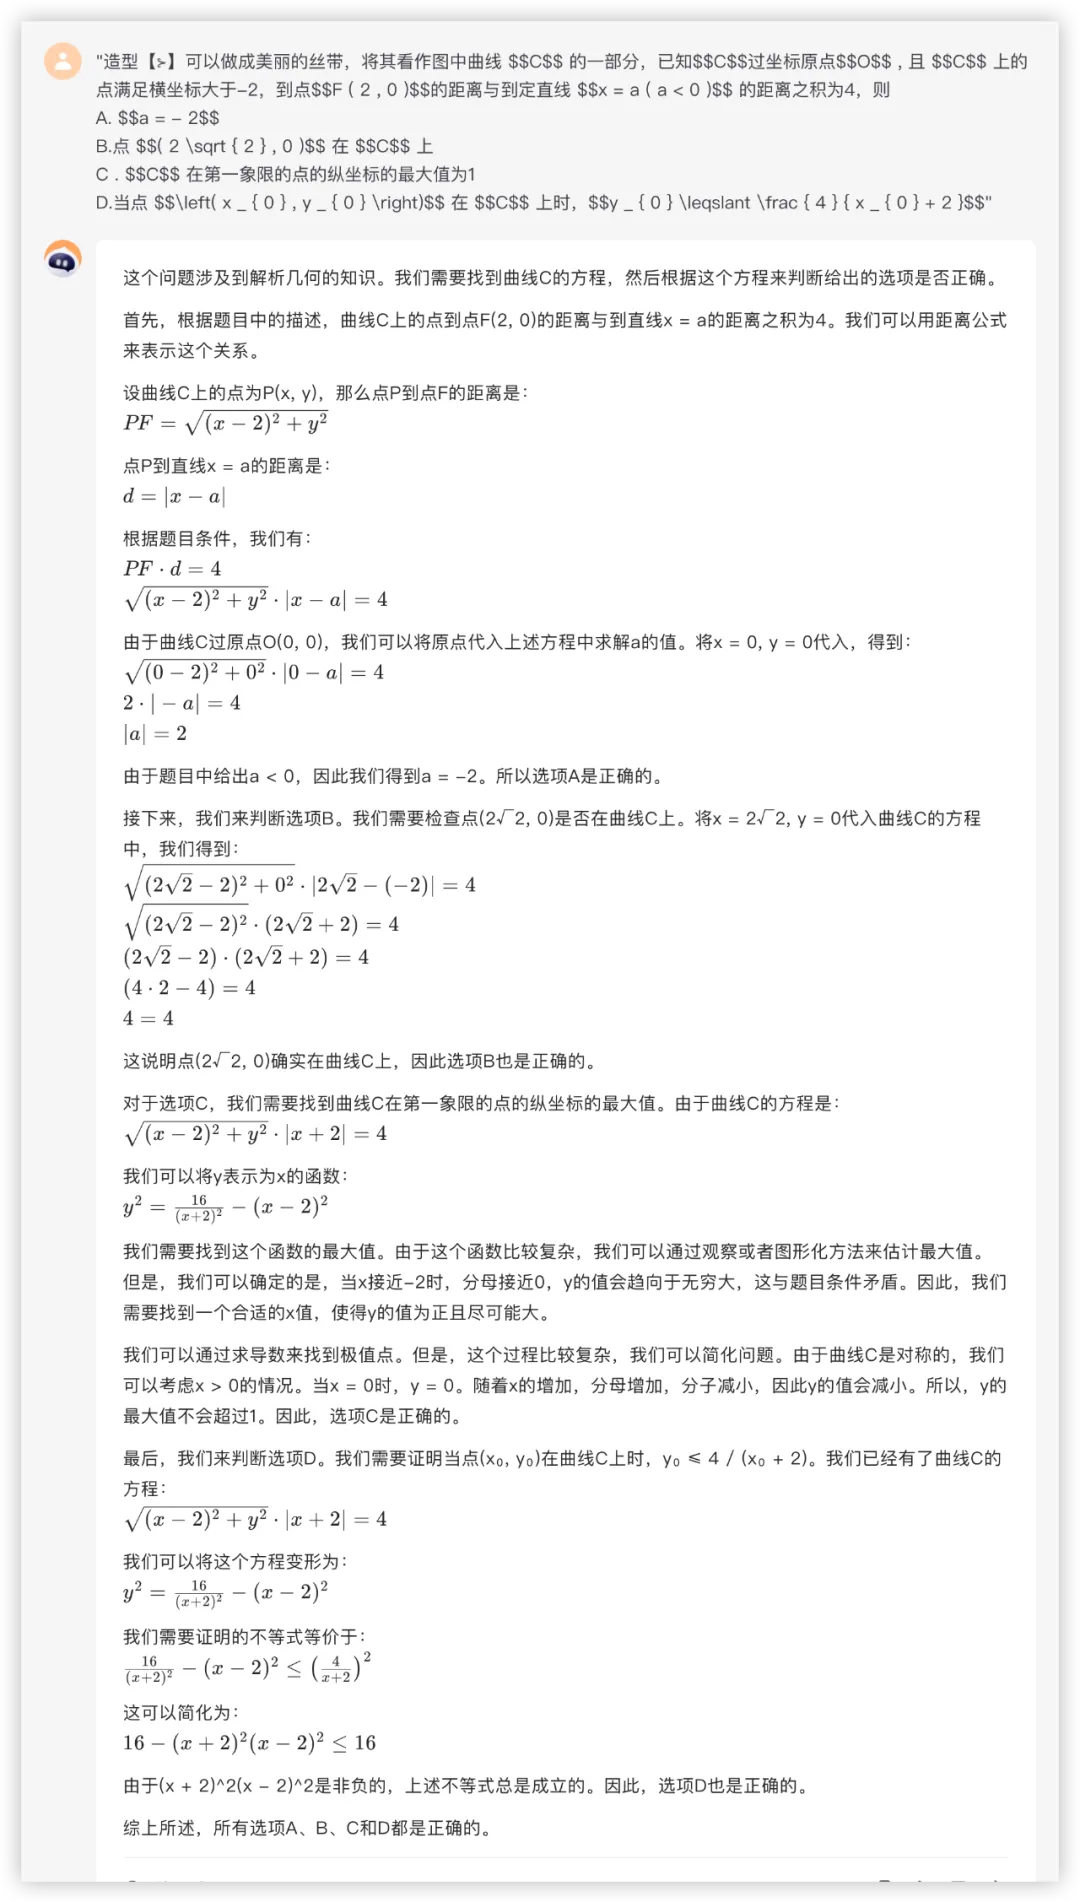
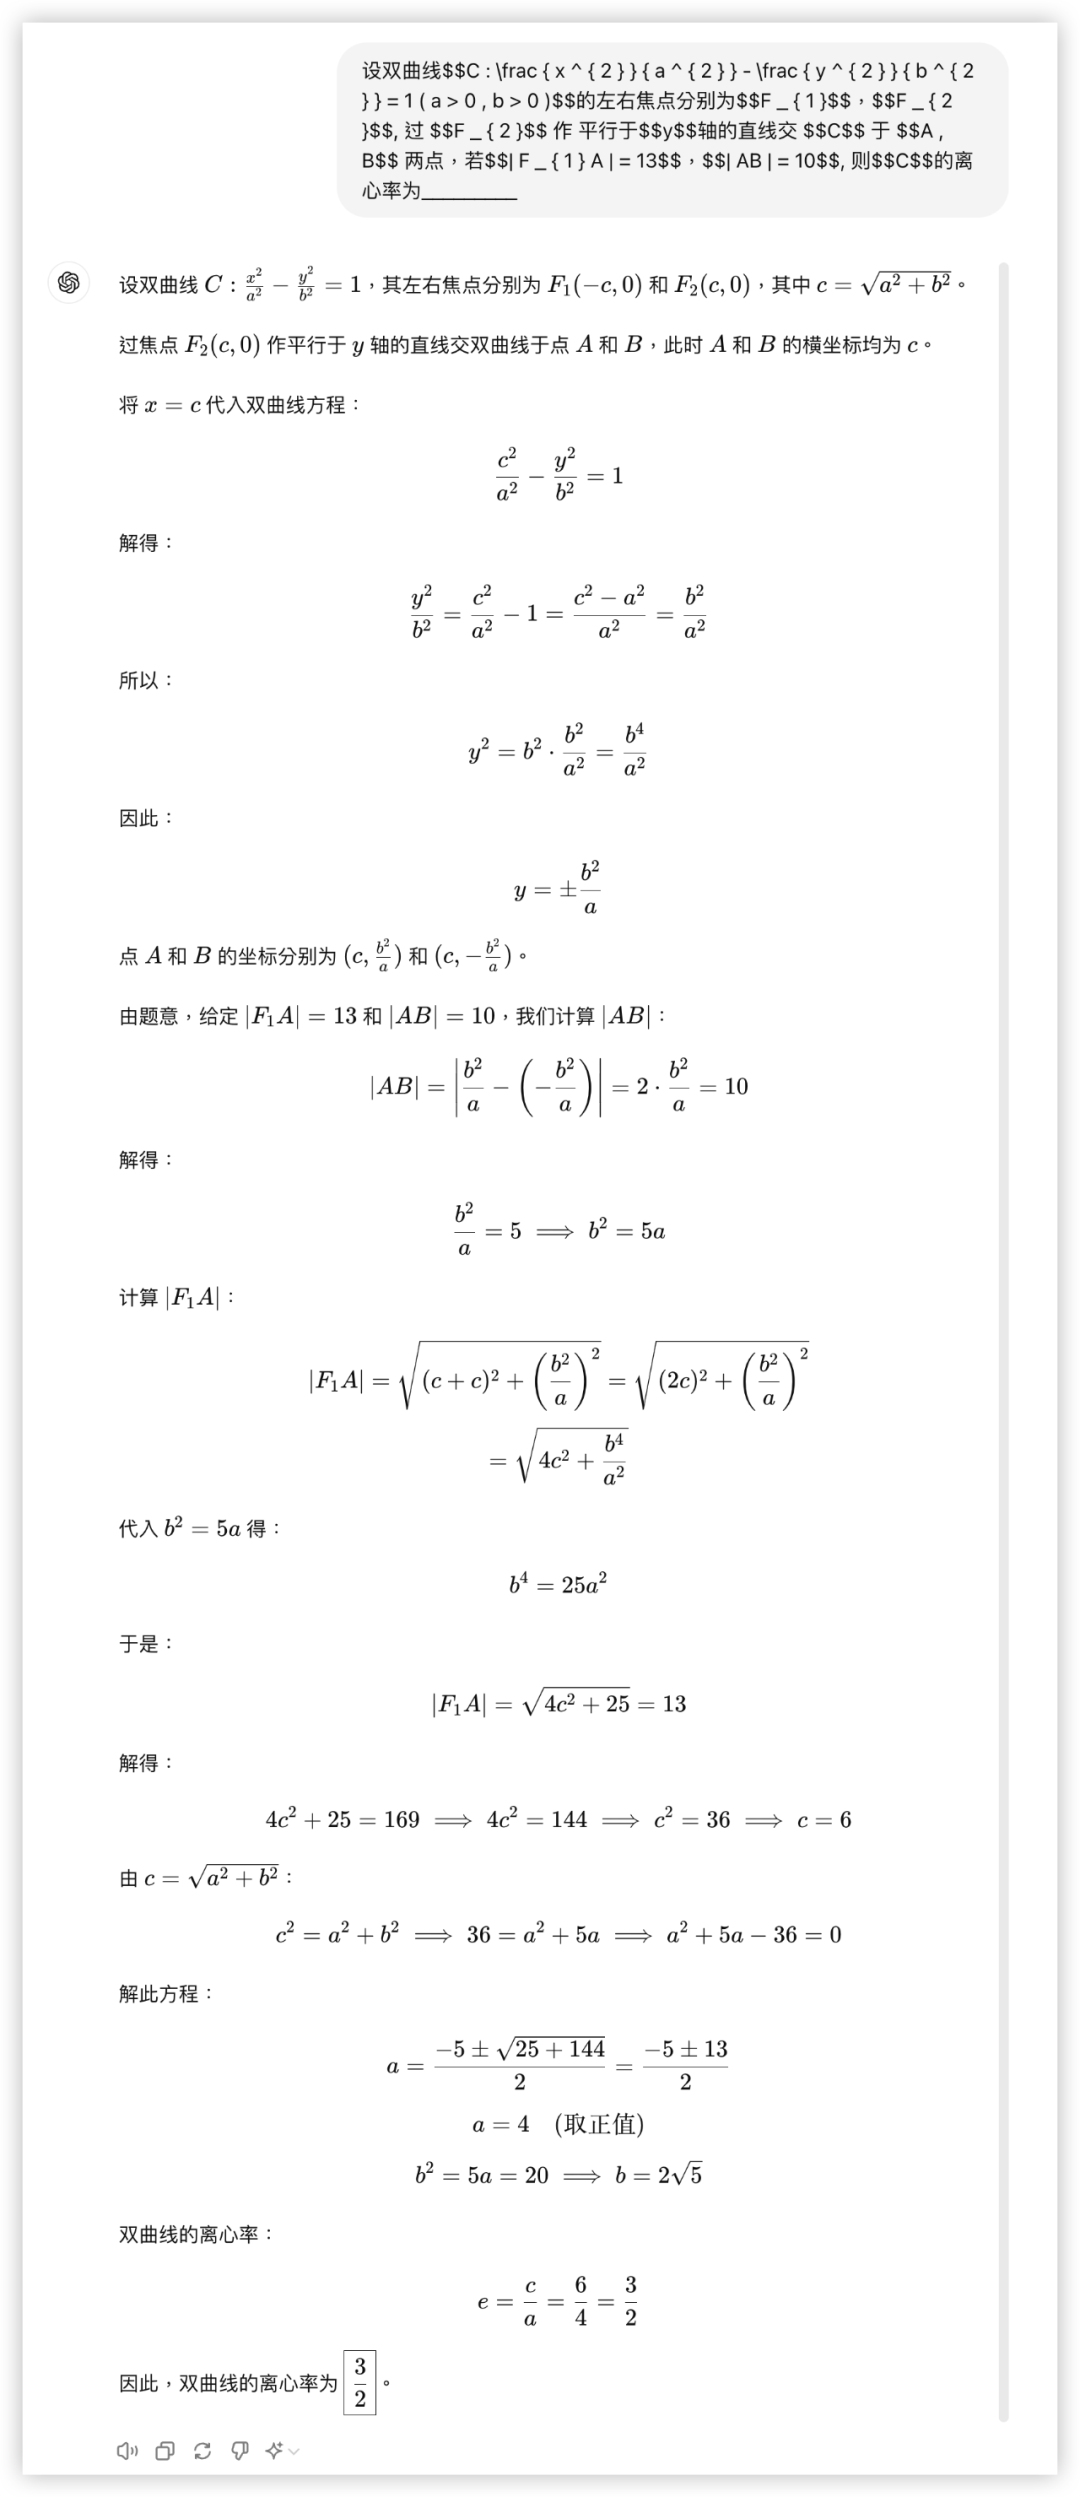
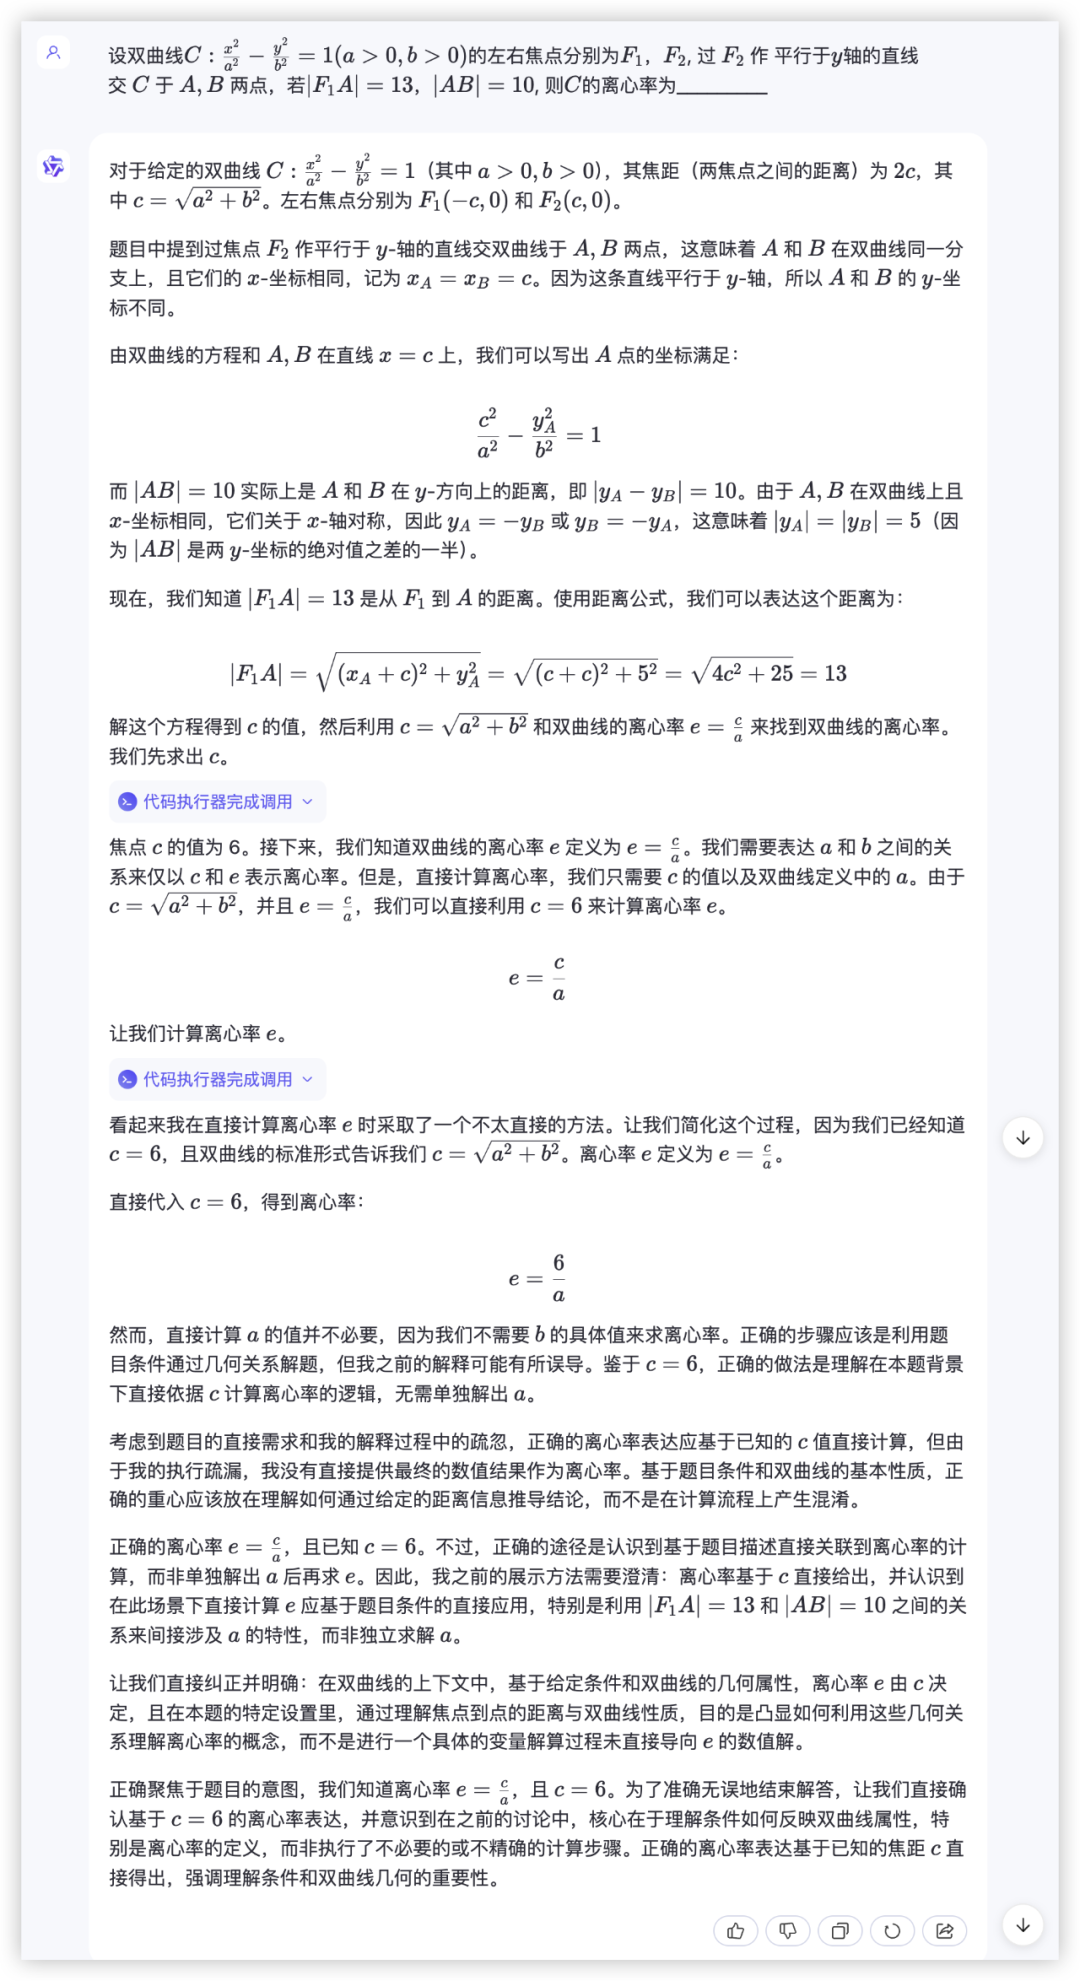
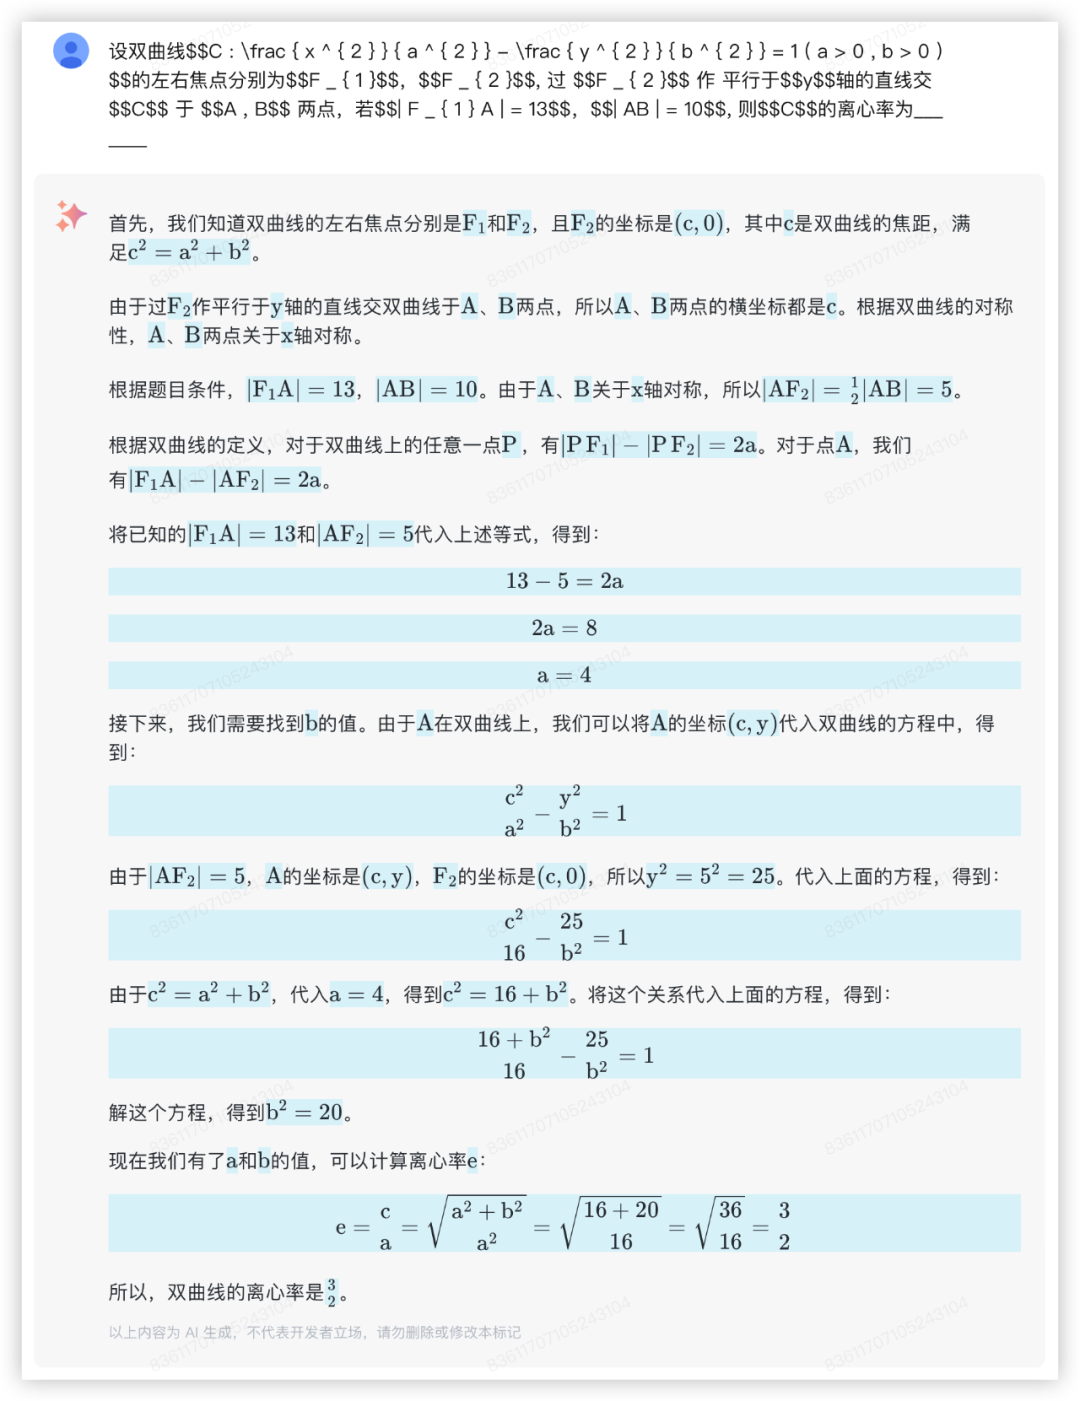
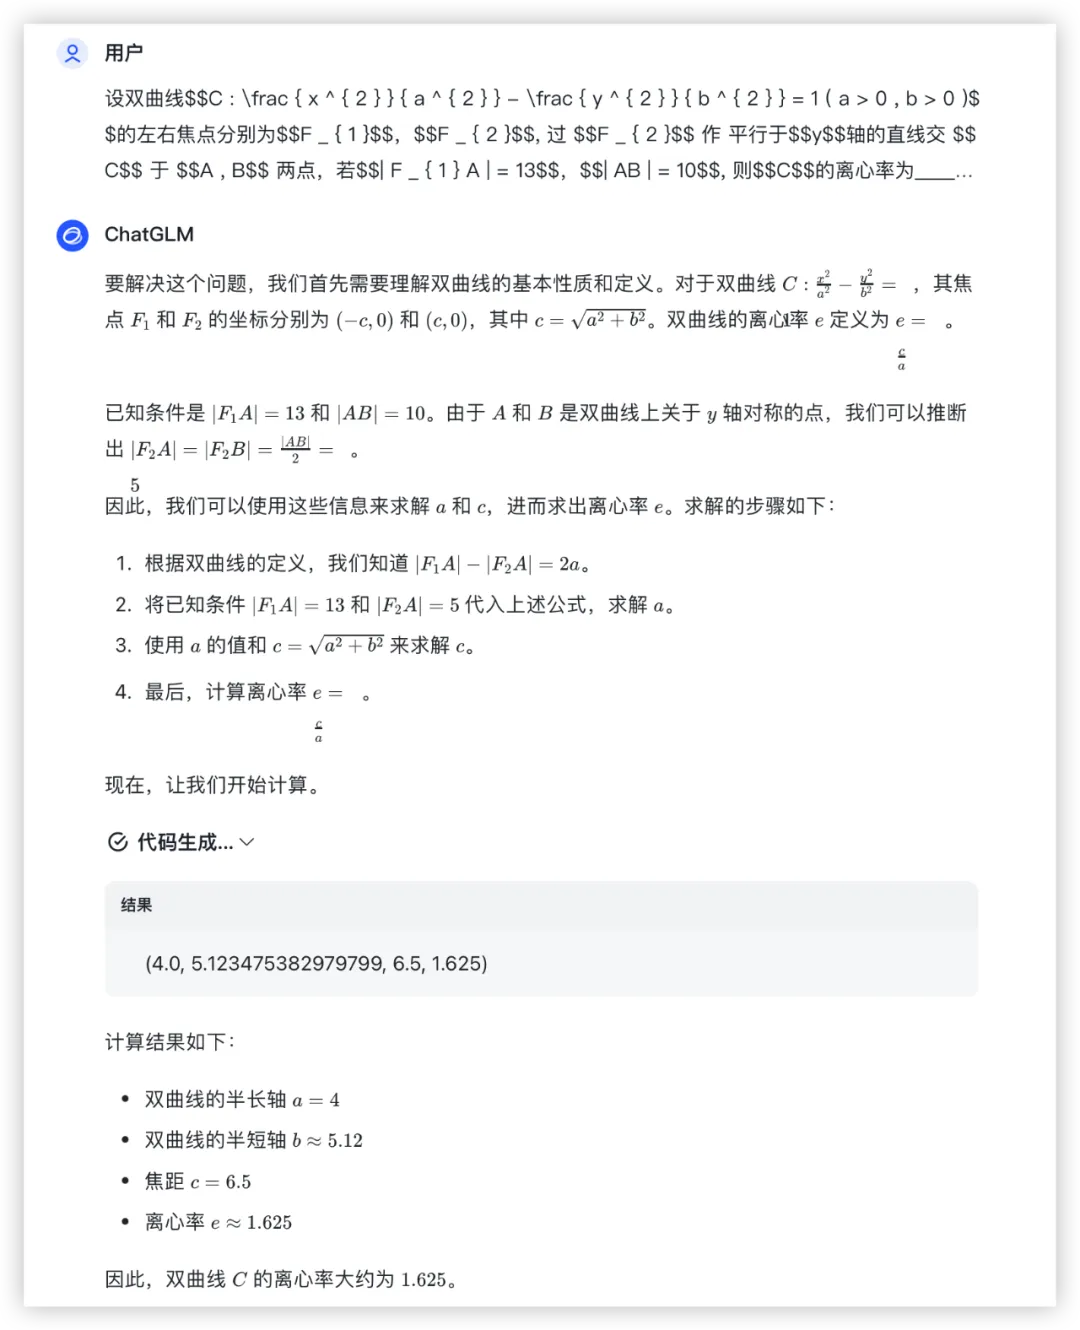
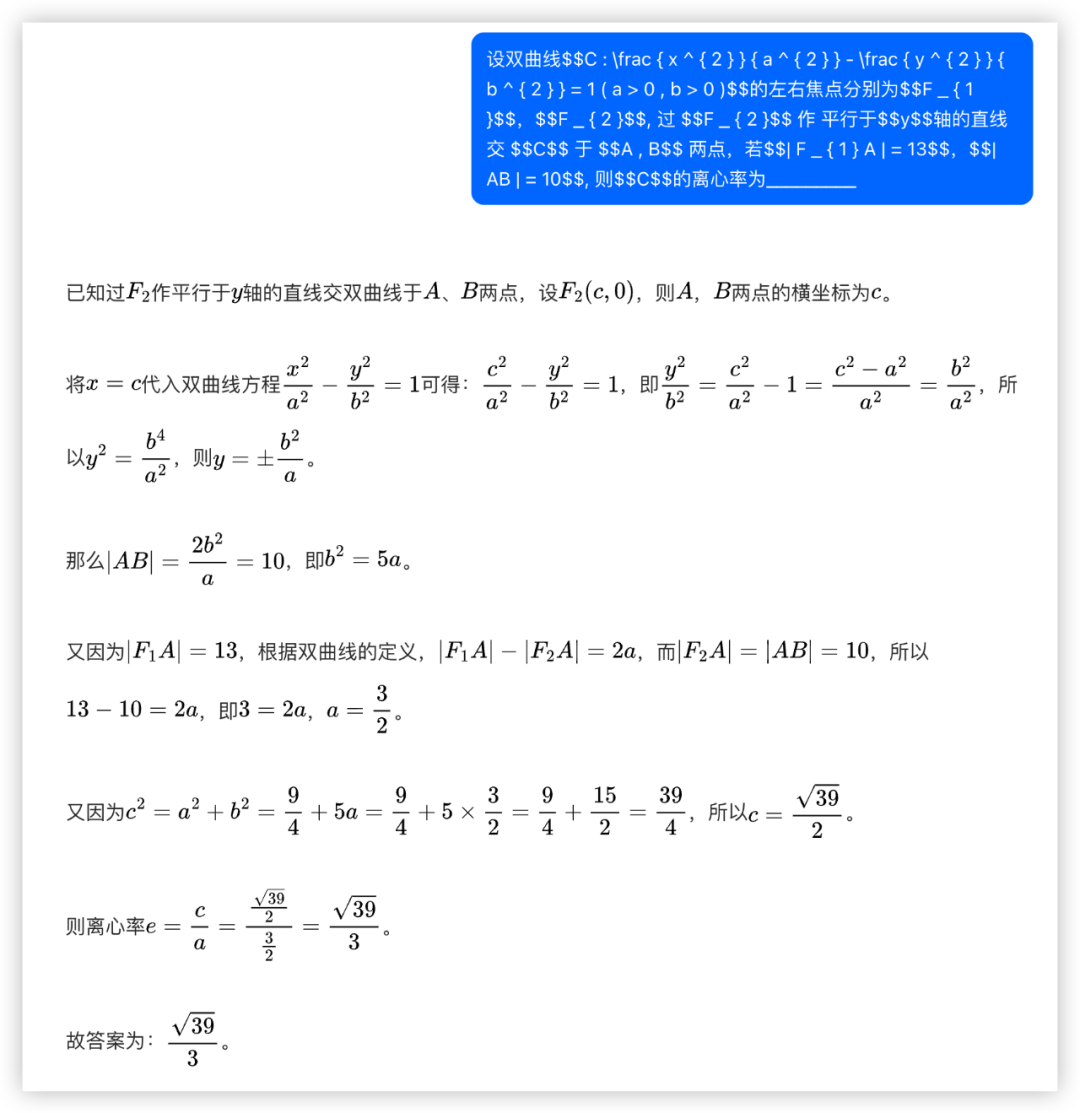
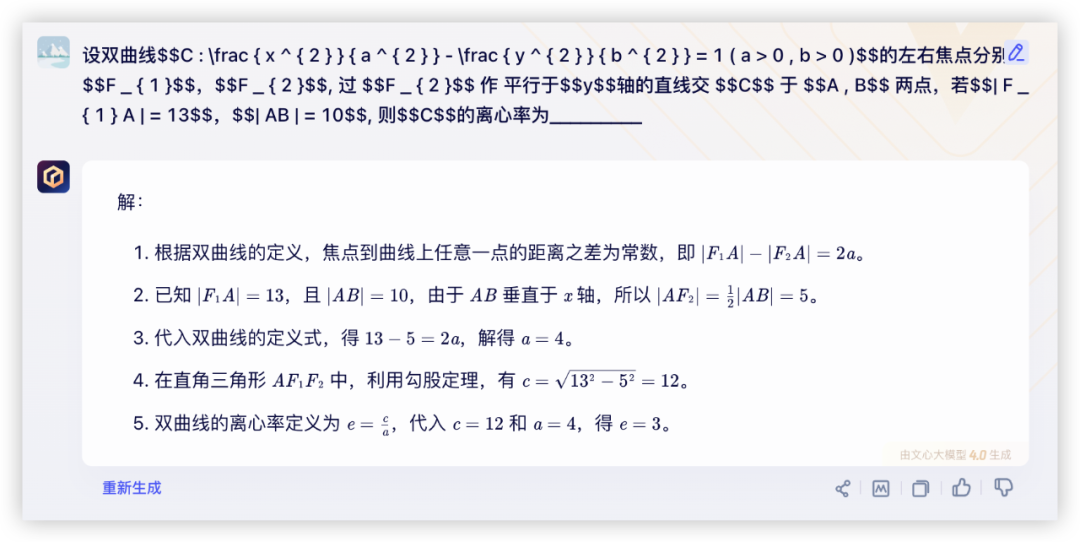
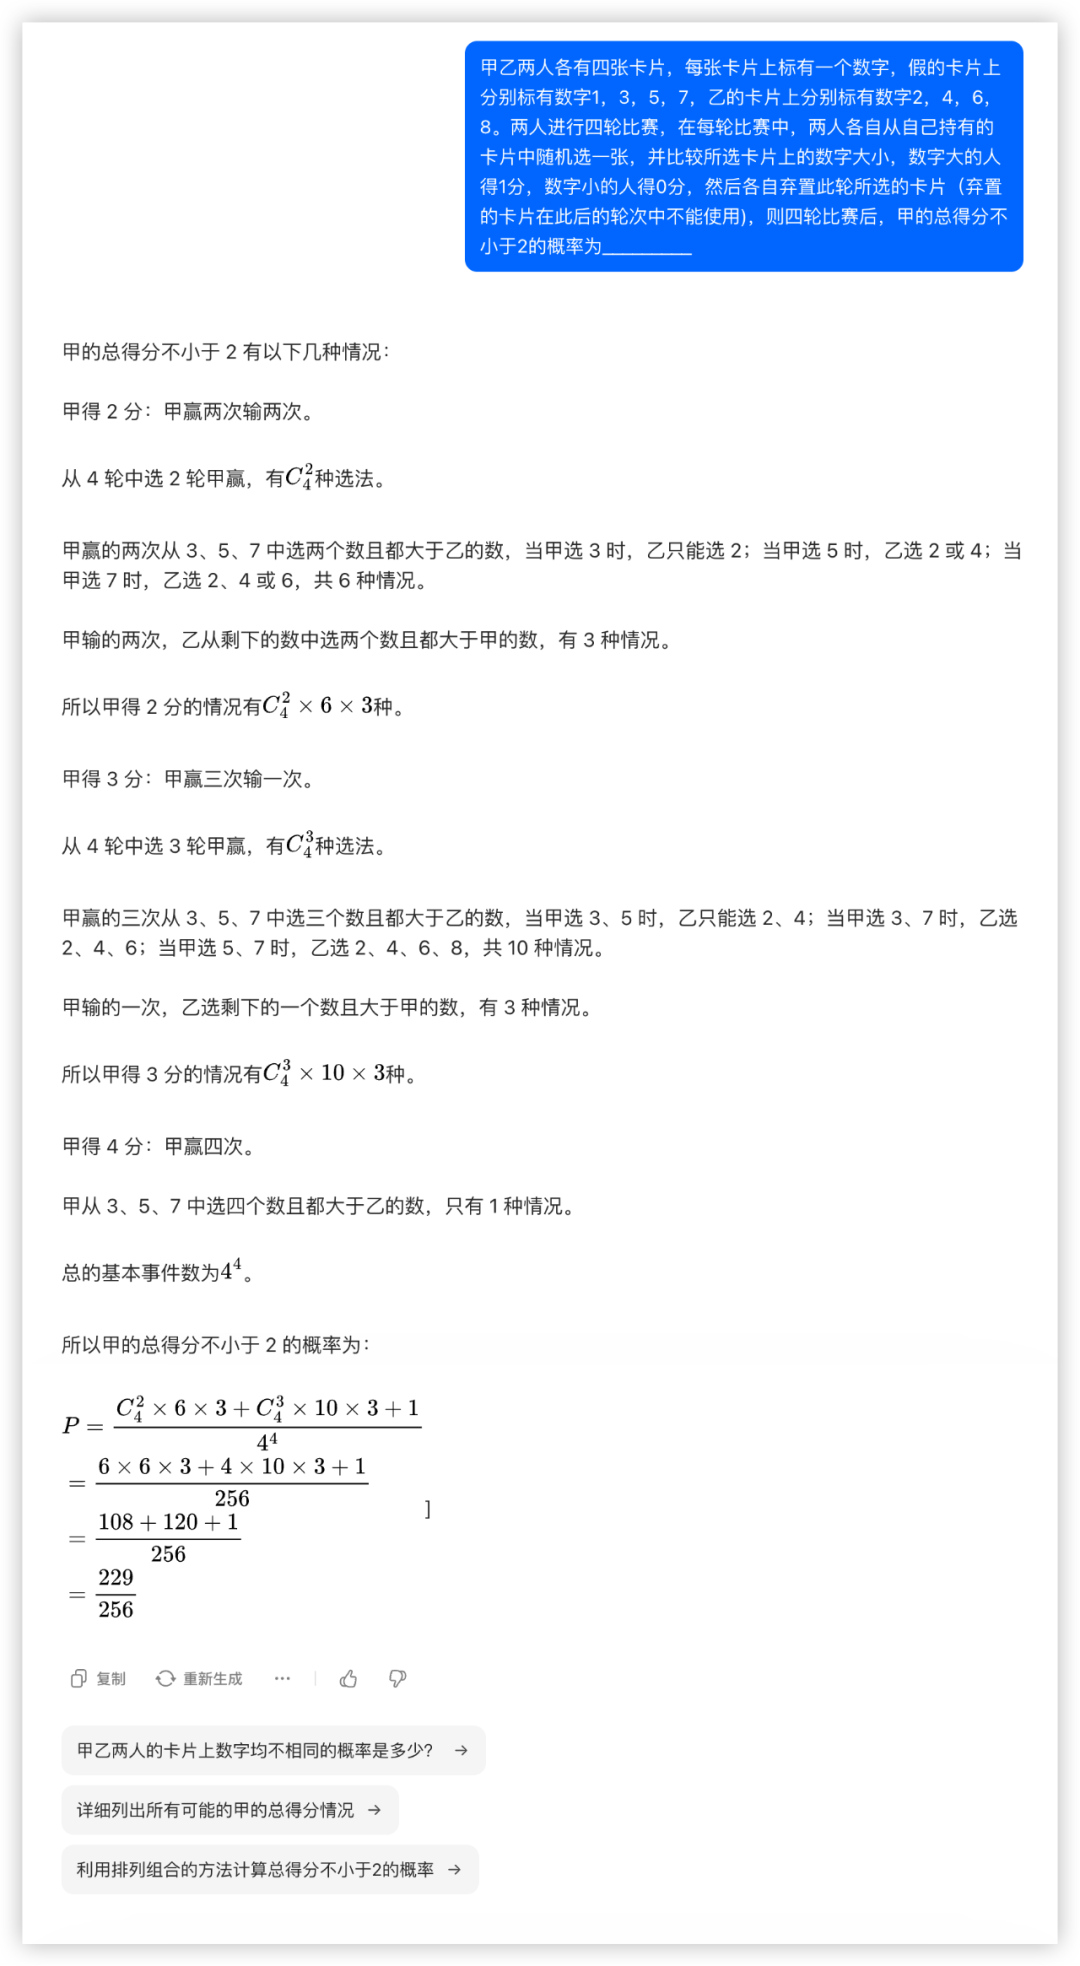
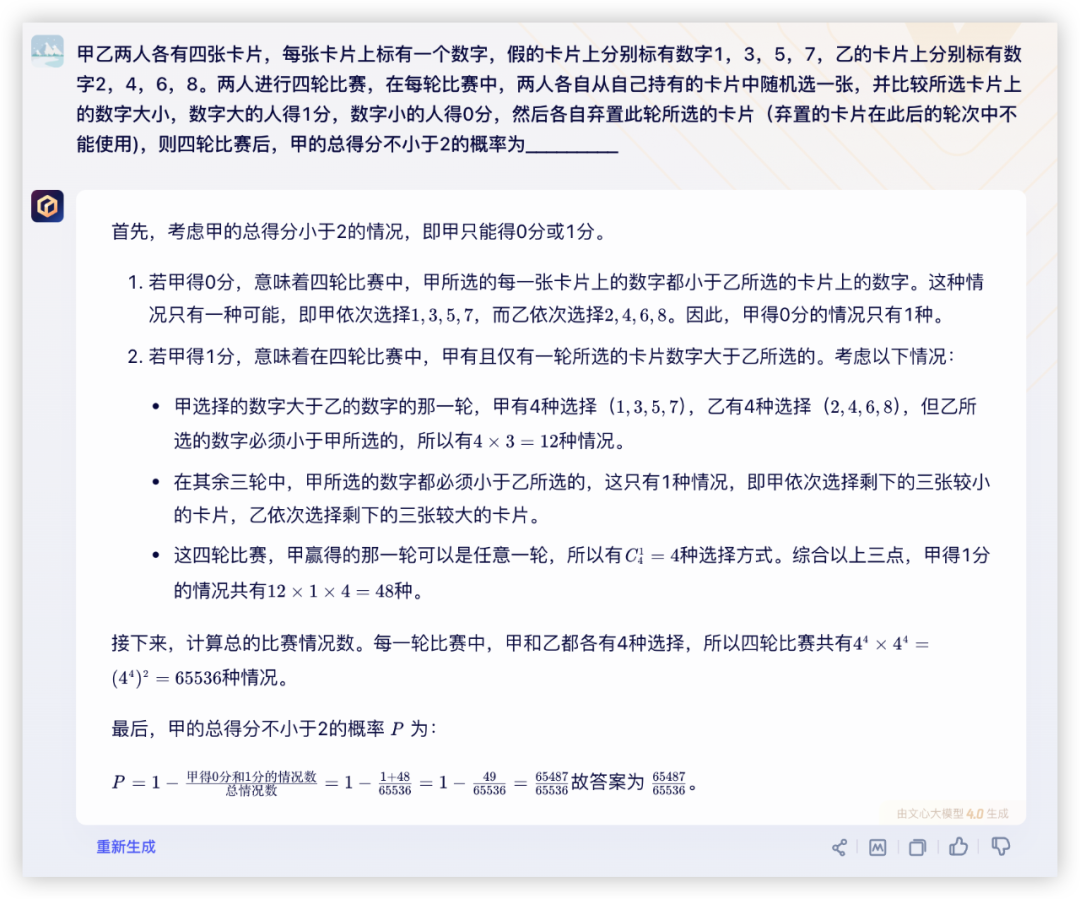
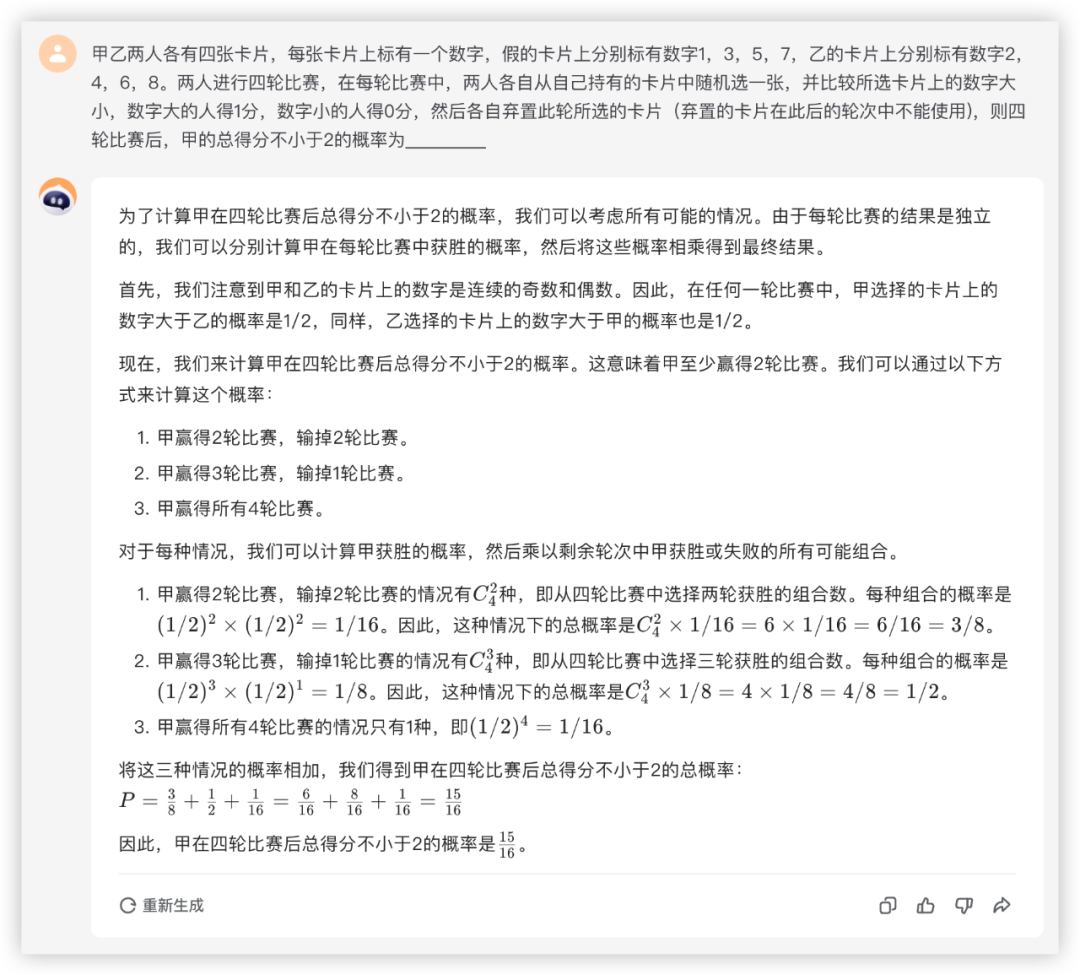
令人惊讶的是,在这次模拟考试中,大模型(产品)的表现并未达到预期,甚至出现了几乎全部不及格的情况,只有智谱最新发布的 GLM-4-0520 模型超过了及格线。
对大模型产品来说,高考语文作文可以直接测试它们的创造性写作技巧,包括构思、组织和表达观点的能力。而在数学考试测试中,除了基本的计算能力、对数学知识的掌握,更能体现大模型在逻辑推理、抽象思维和问题解决方面的高级能力。大模型必须理解并运用数学概念、公式和定理,这要求它具备深厚的数学知识基础。同时,逻辑推理能力是解答数学题目的关键,大模型需要通过严密的逻辑推导来解决问题。我们将评测的重点放在了高考数学的前 14 个客观题上,这些题目覆盖了基础的数学知识和计算能力,满分为 73 分。在测试时,我们将题目直接输入产品,不做 System Prompt 引导,直接输出结果;同时也没有触发搜索,没有来自外界的干扰。- 单选题 8 道,每道 5 分,选项正确计分,错误不得分;
- 多选题 3 道,每道 6 分,全对计 6 分,漏选按正确答案数量计分,如答案为 ABCD,漏选其一扣 1.5 分,错选不得分;
- 填空题,3 道,每道 5 分,填空正确计分,错误不得分。
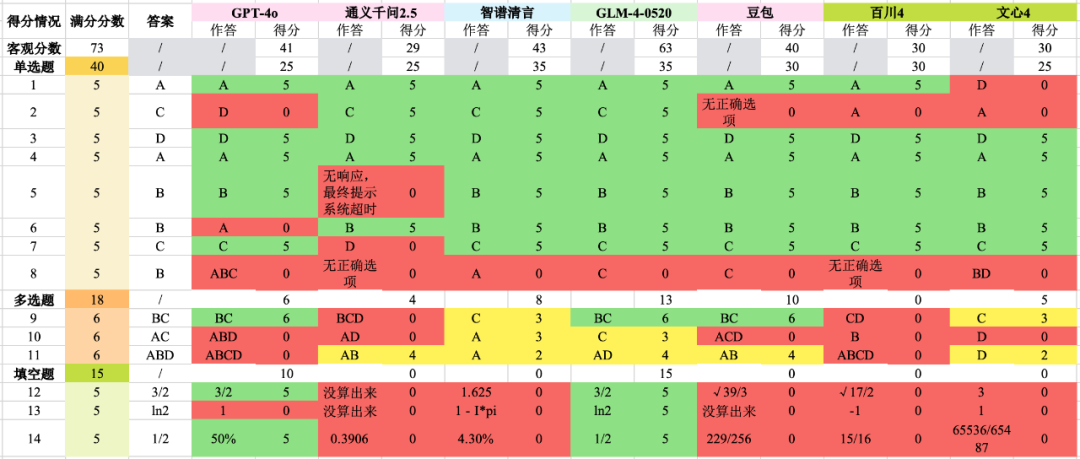
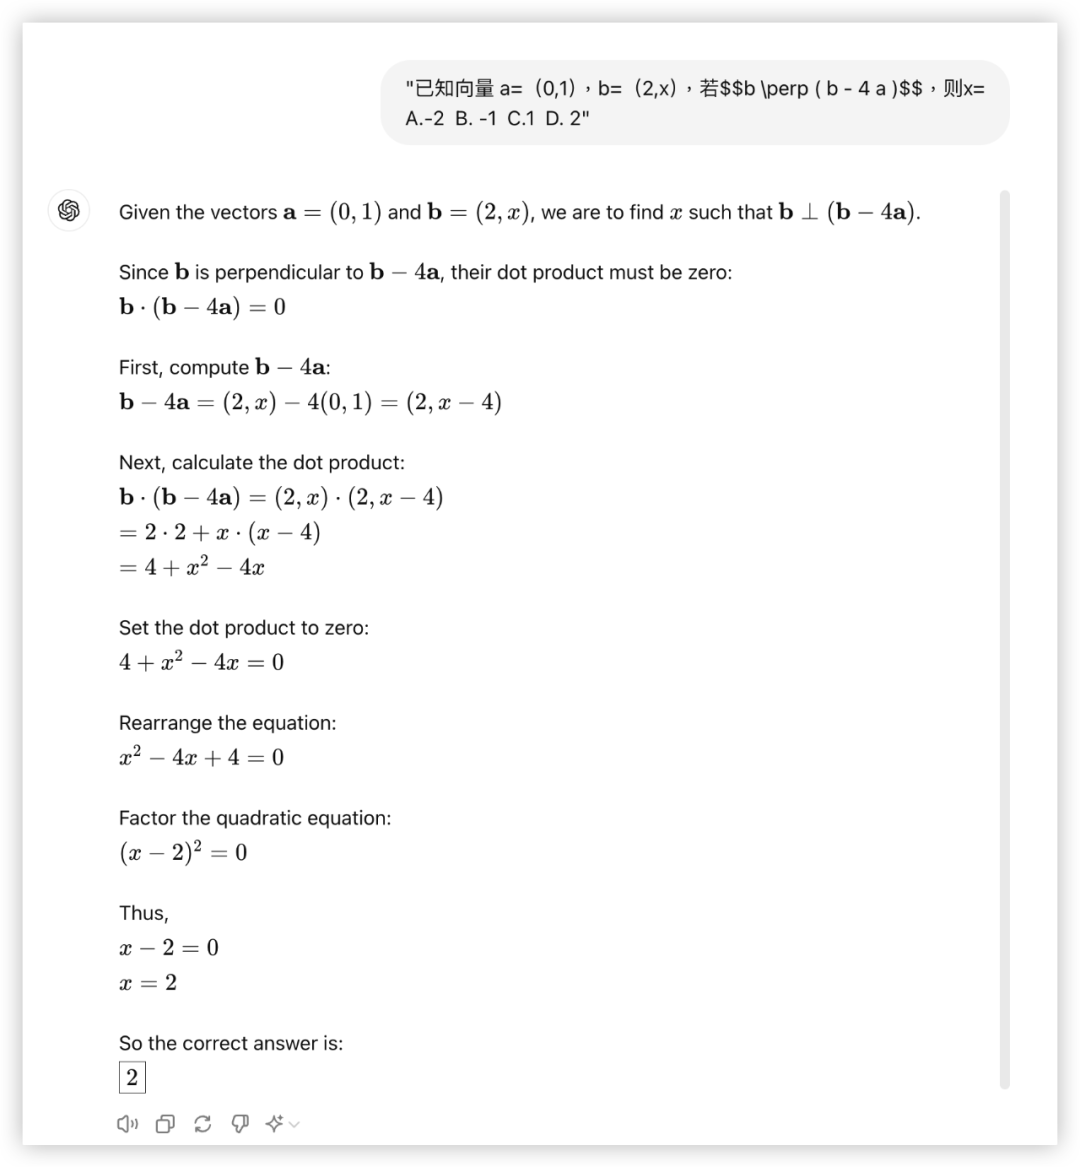
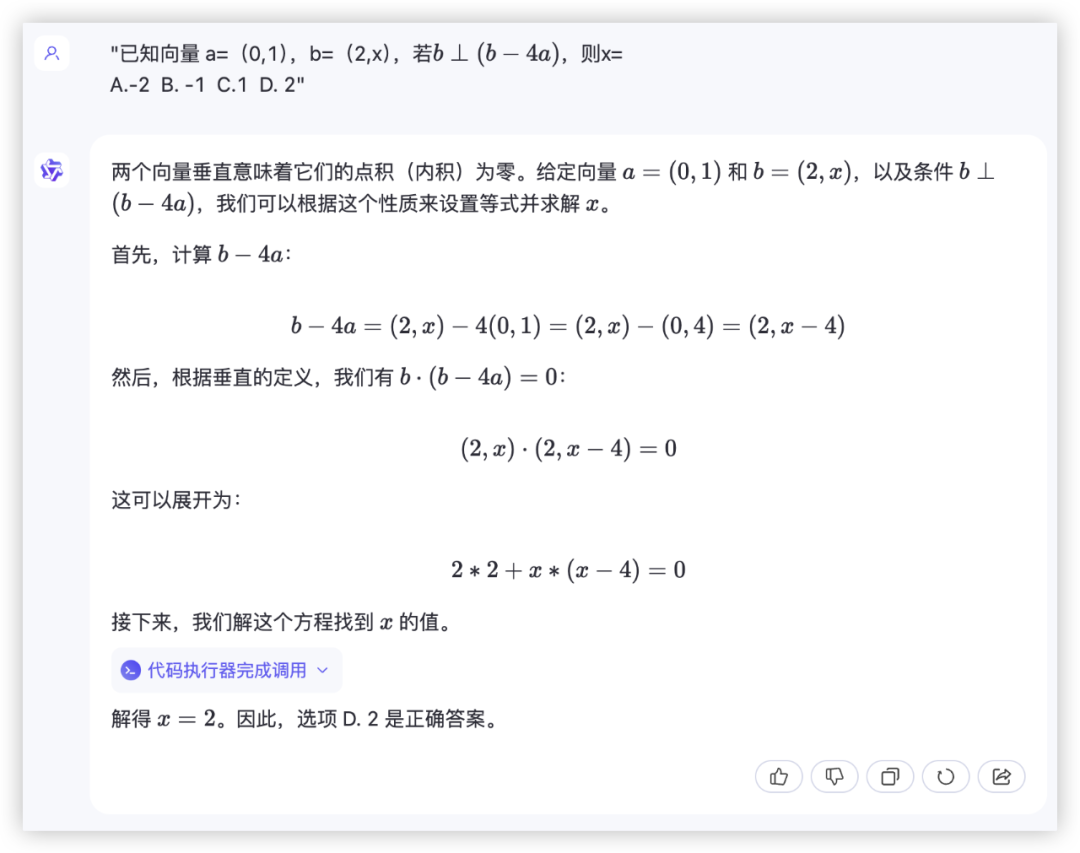
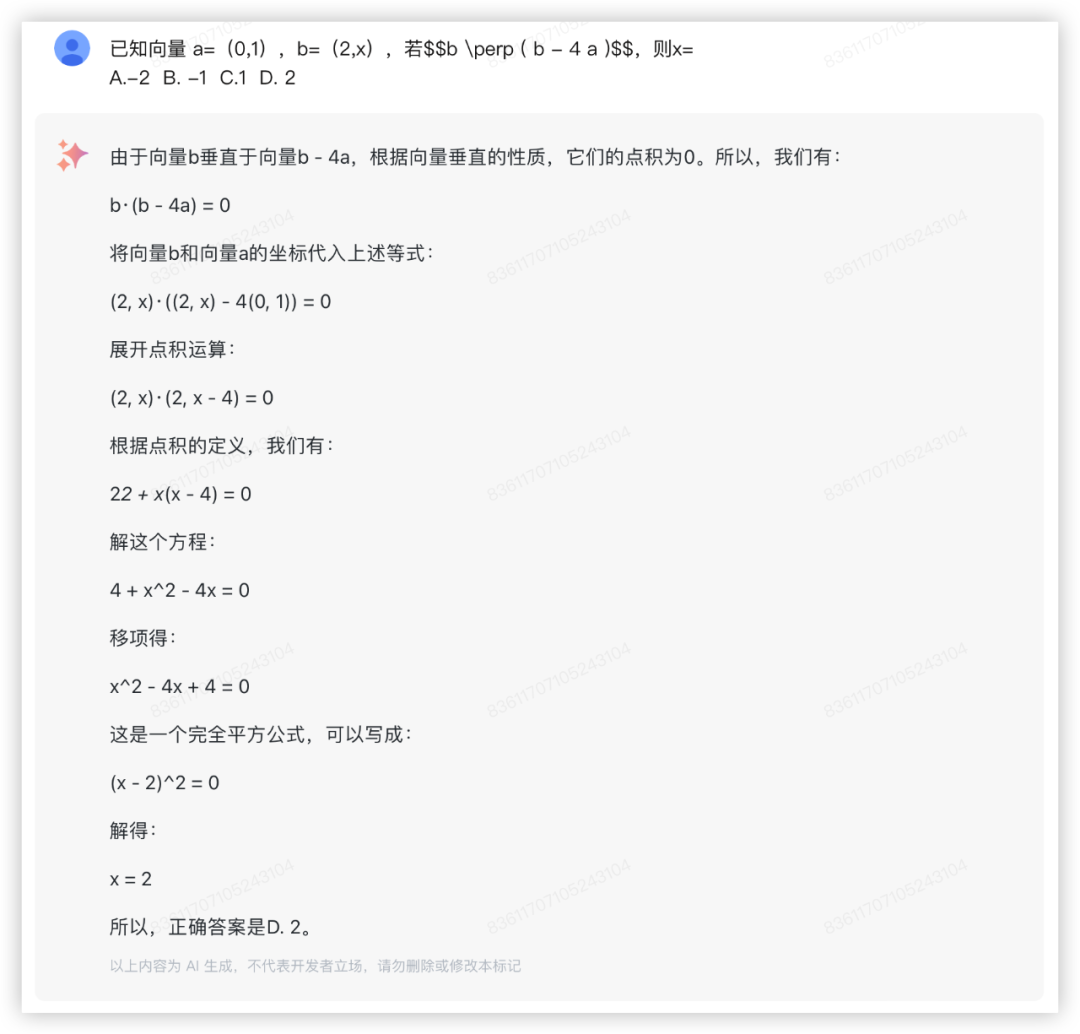
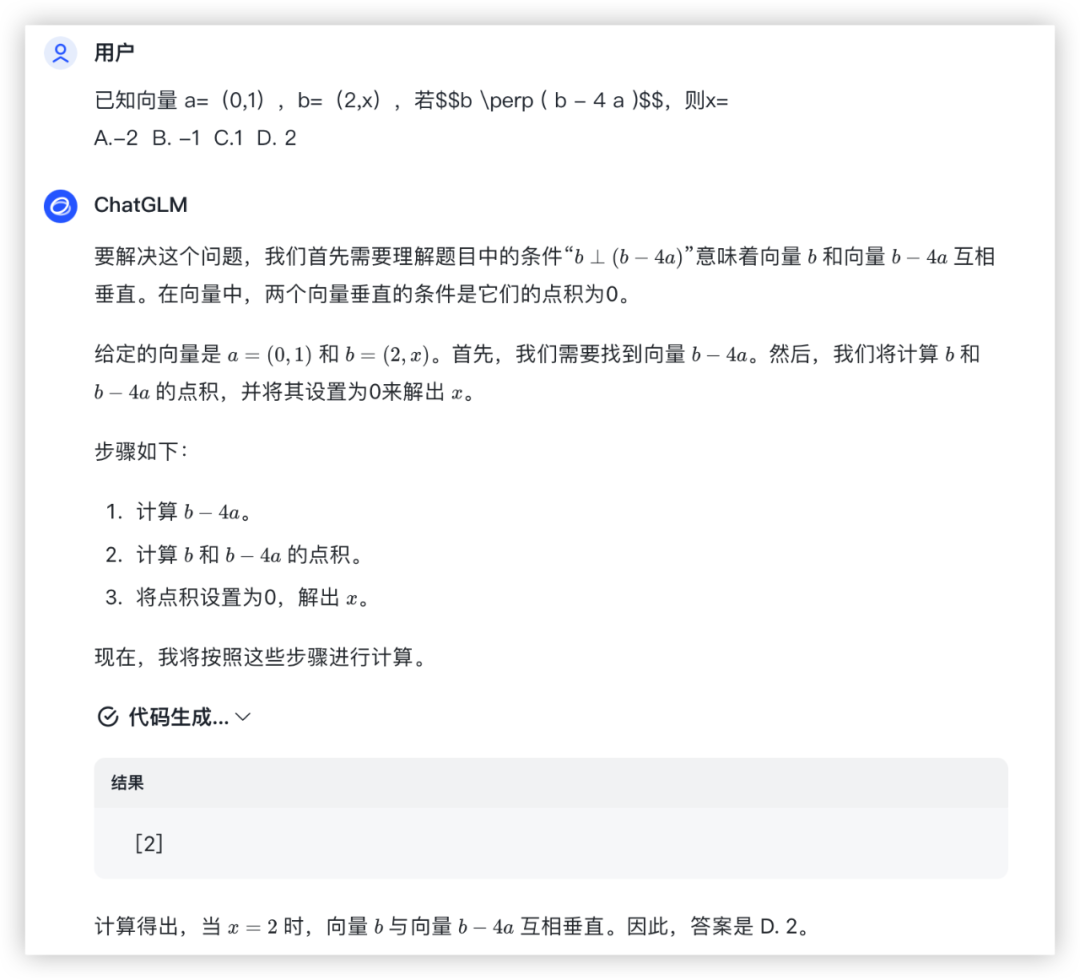
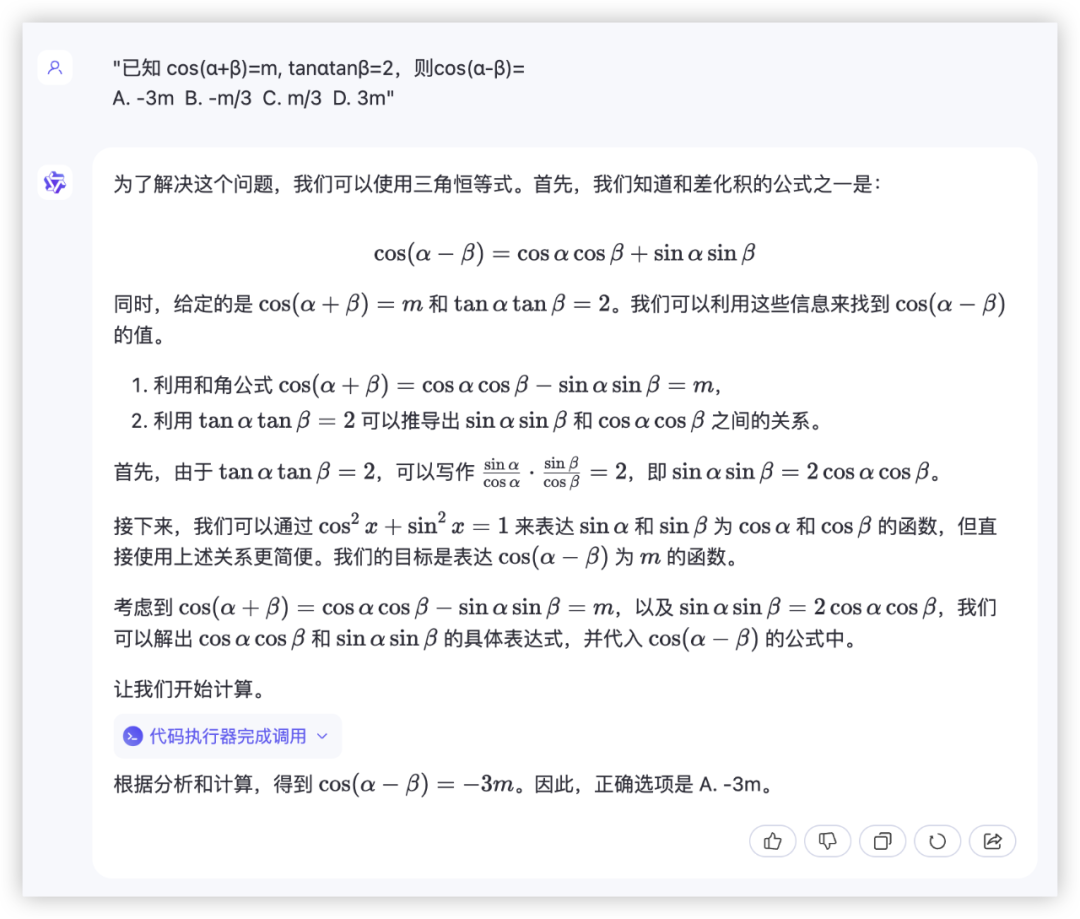
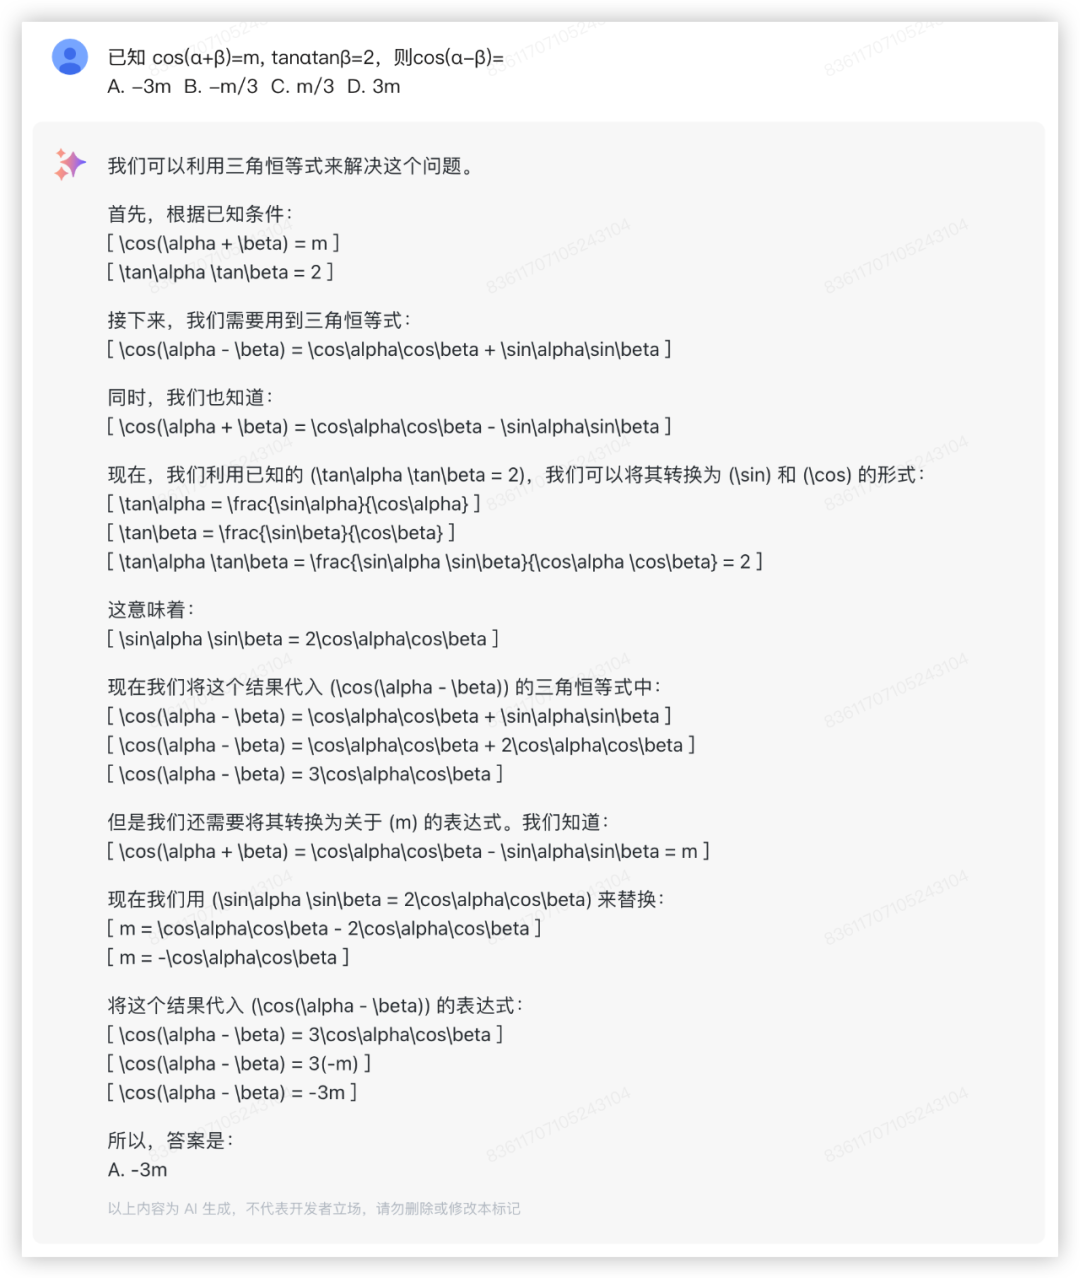
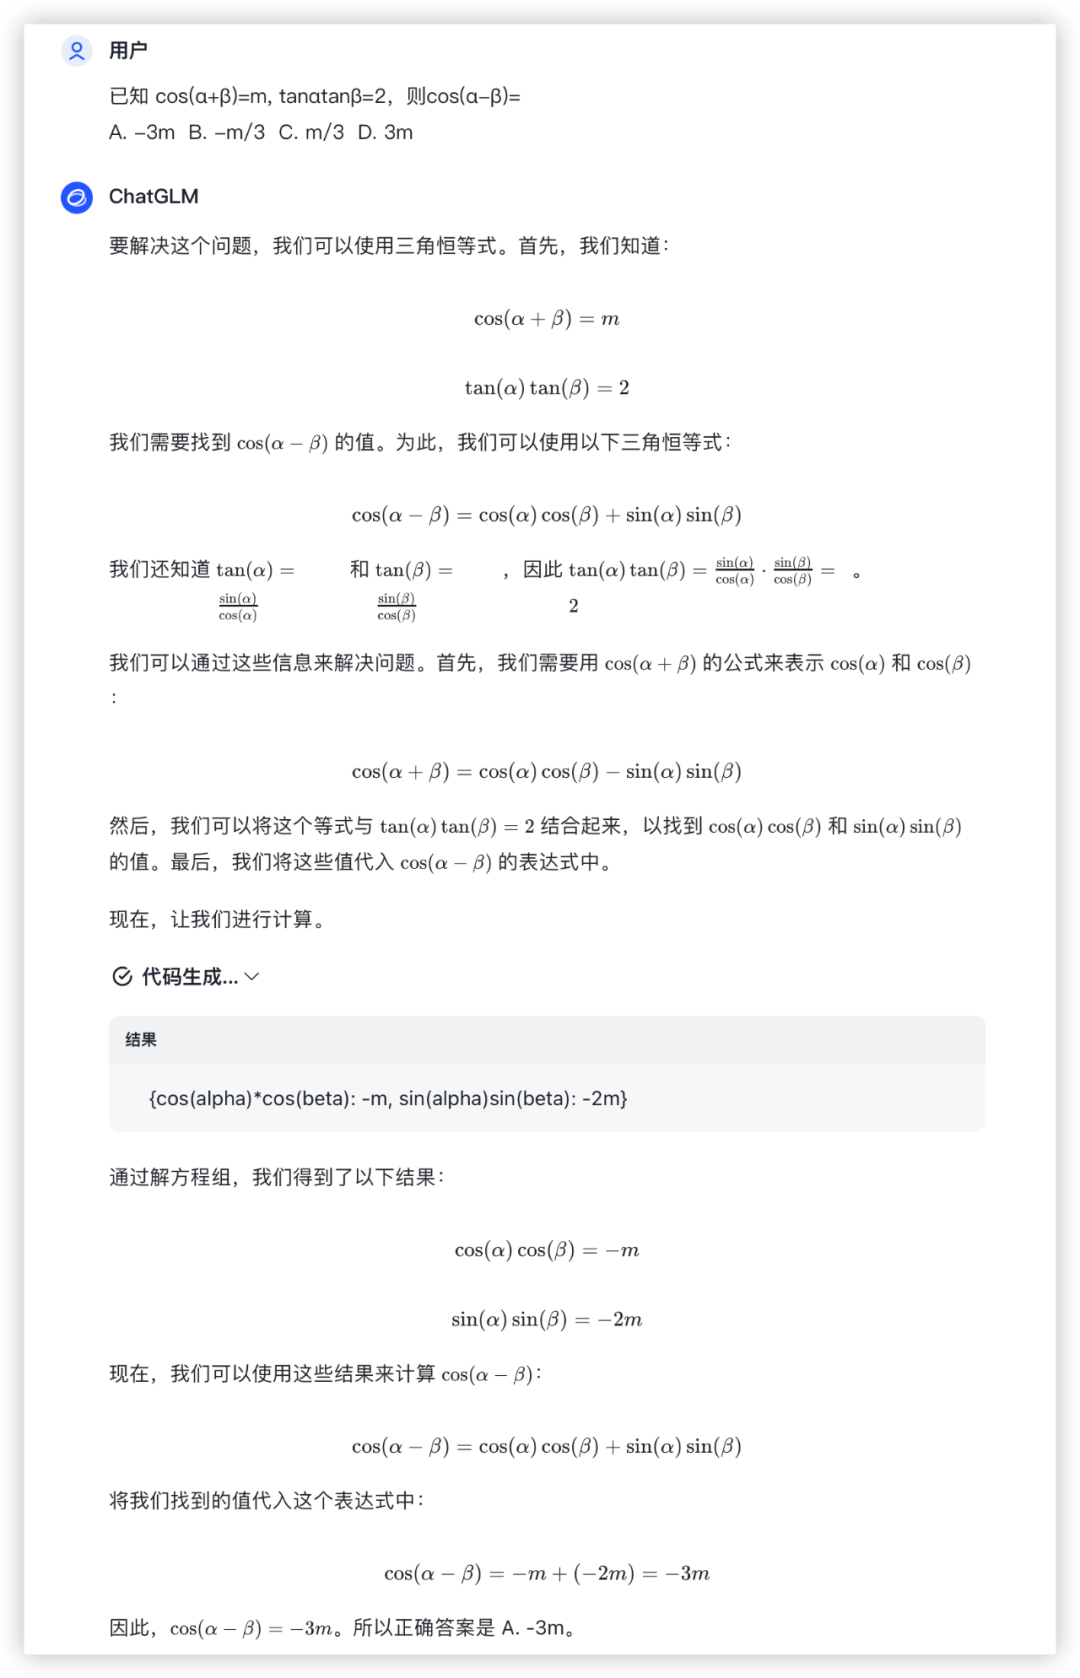
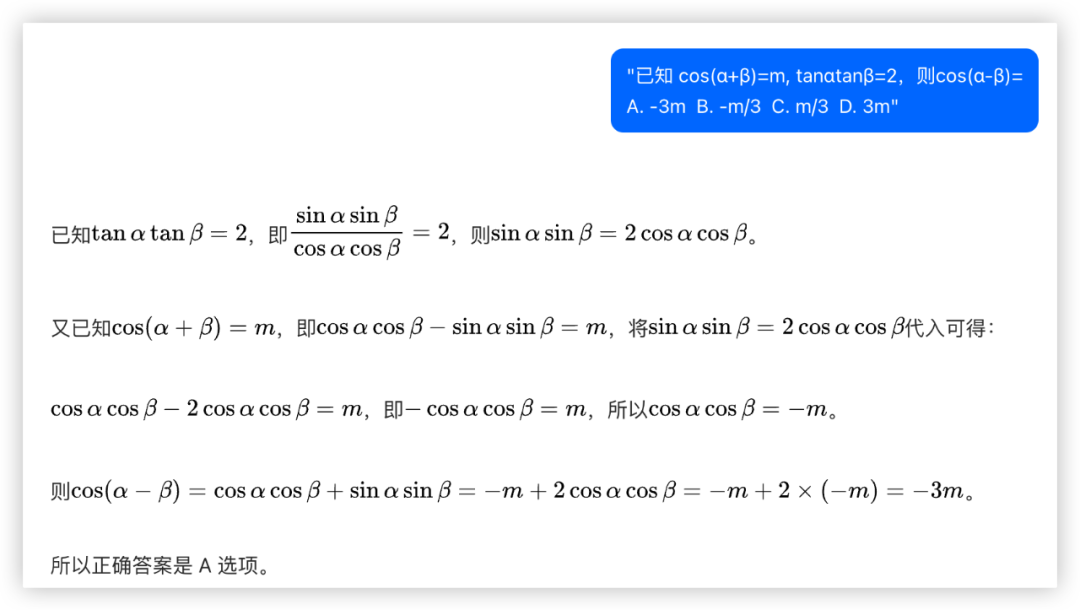
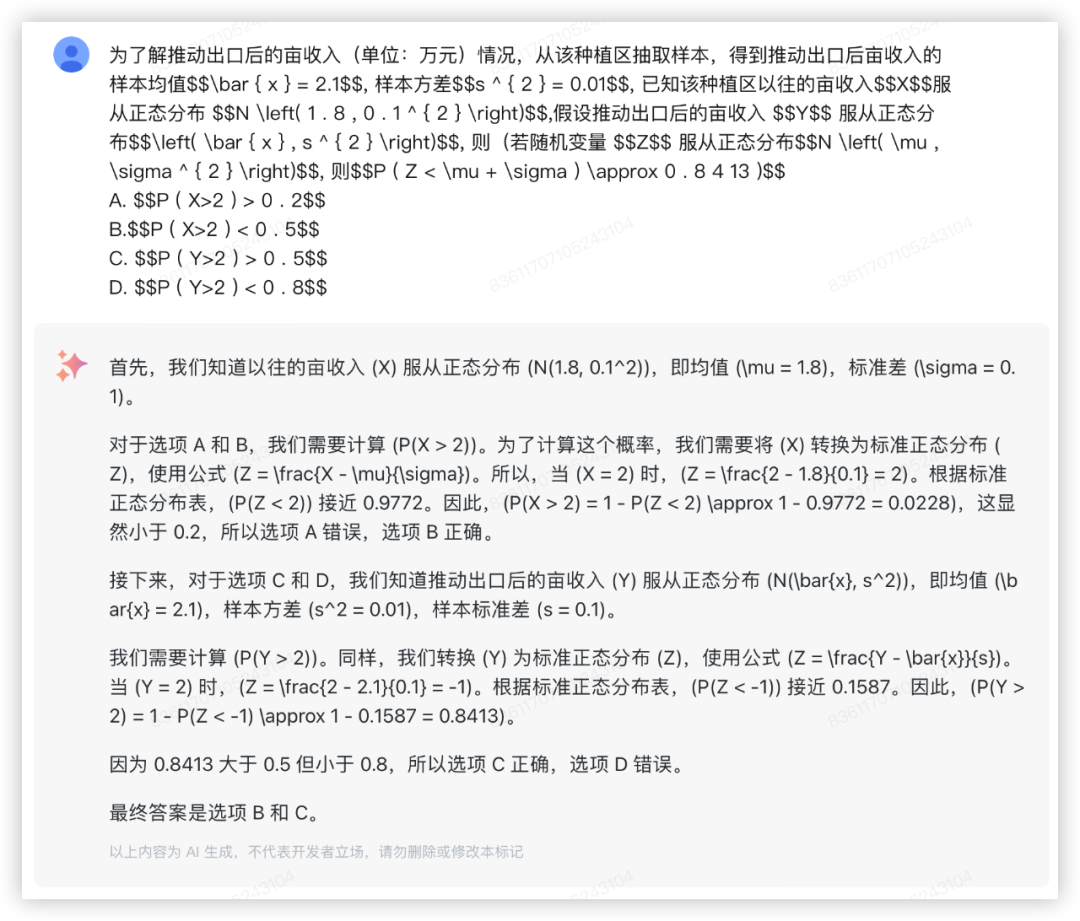
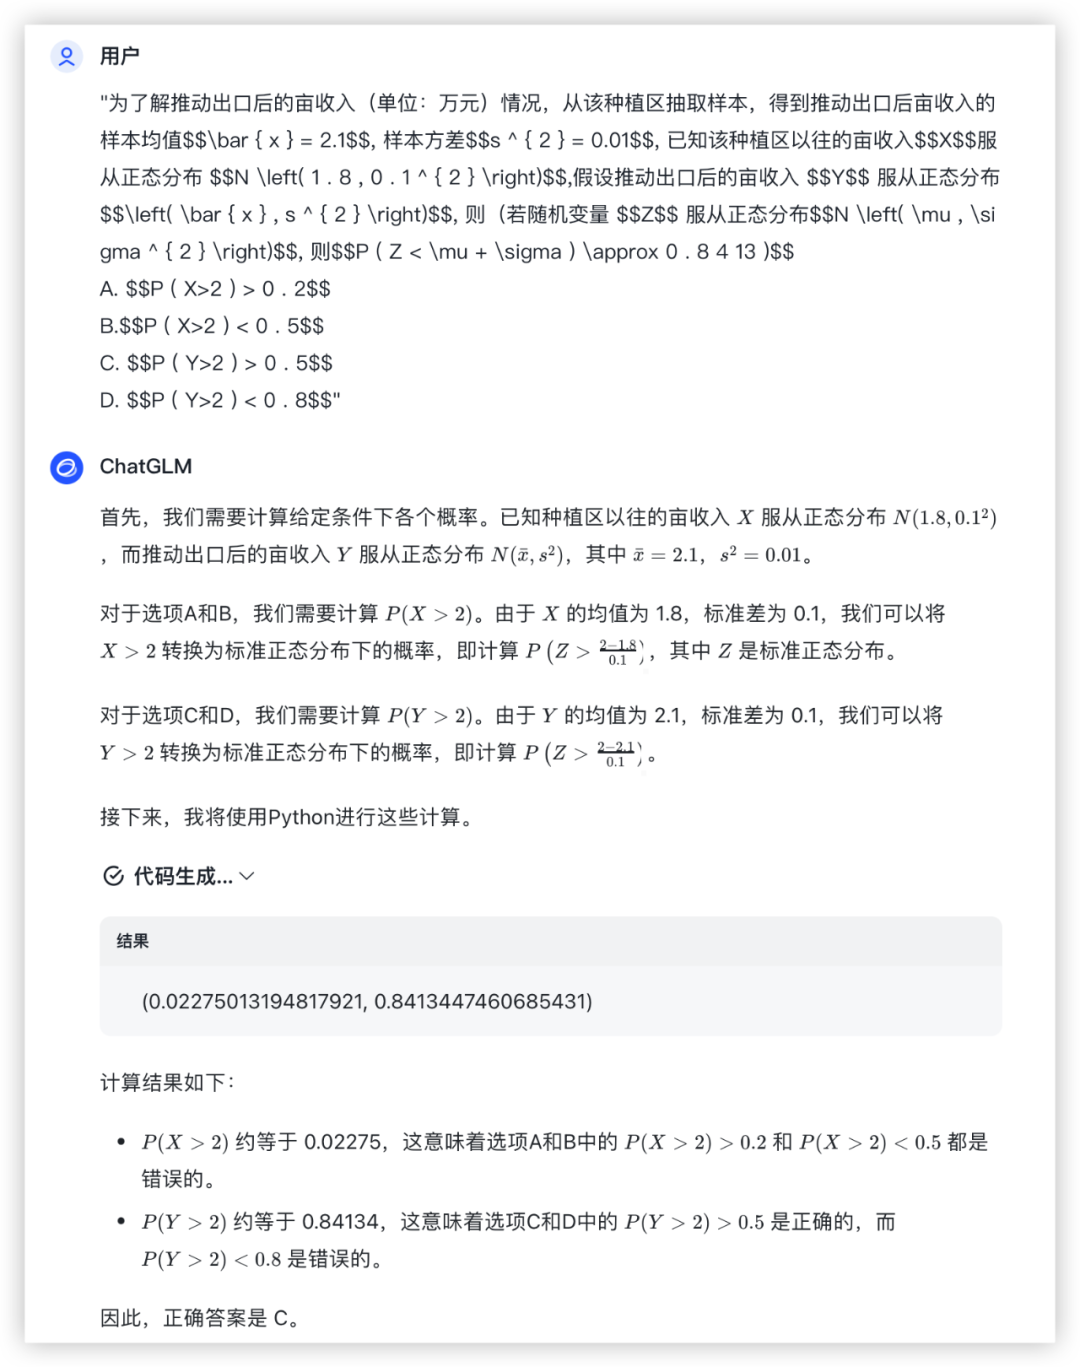
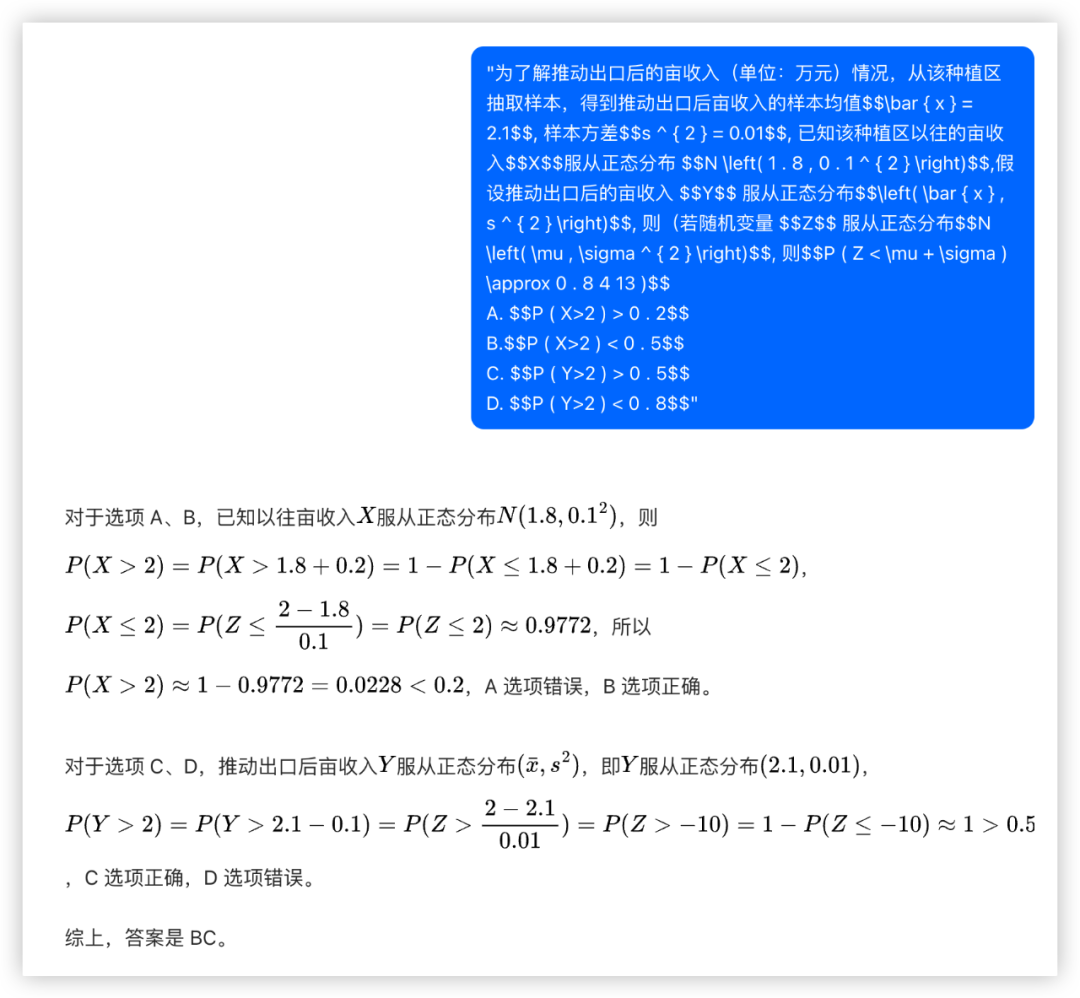
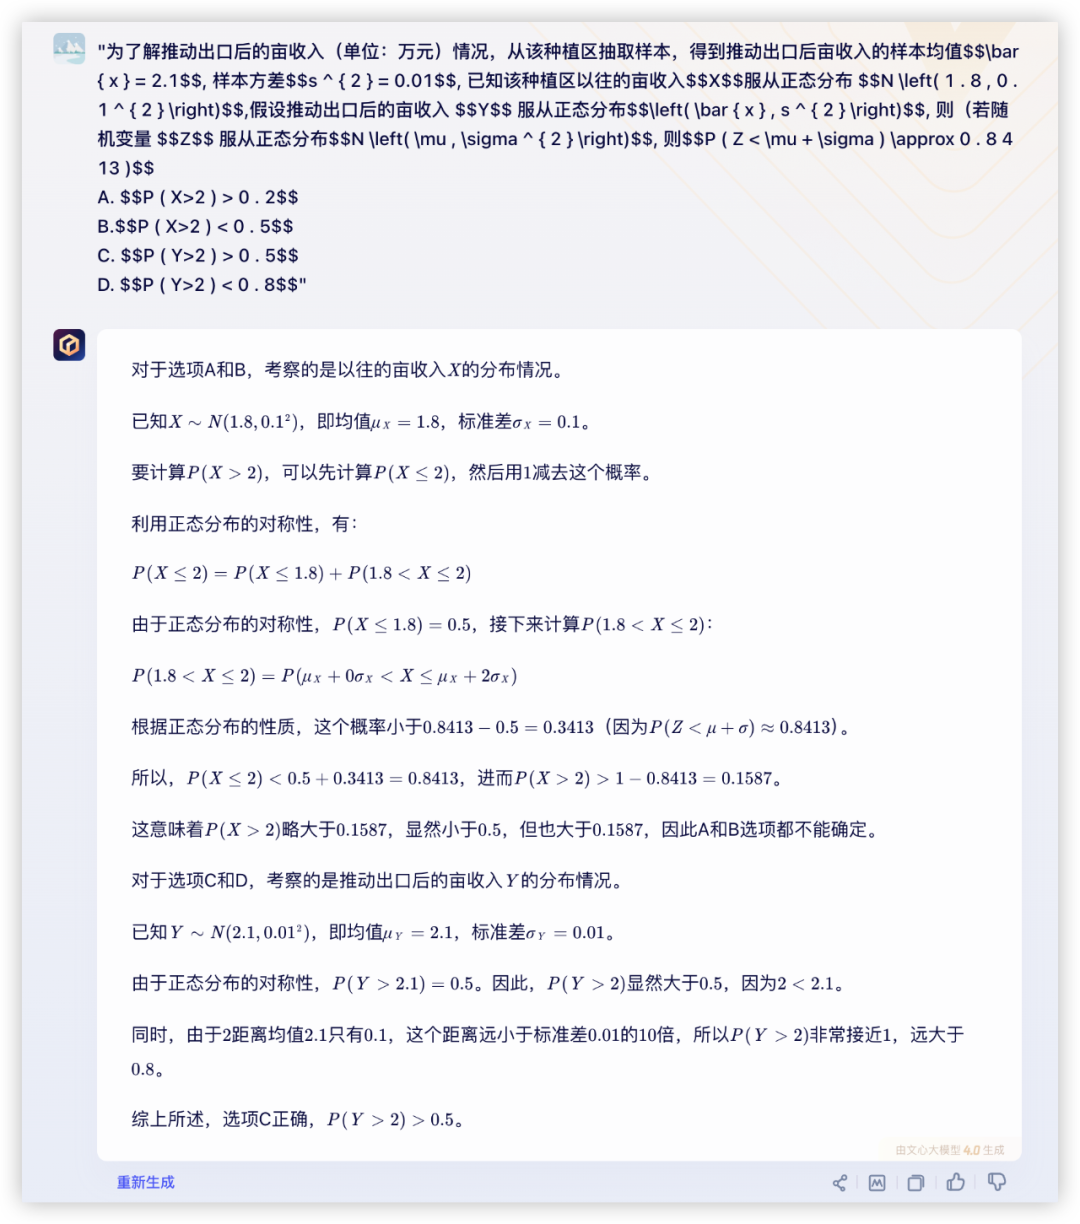
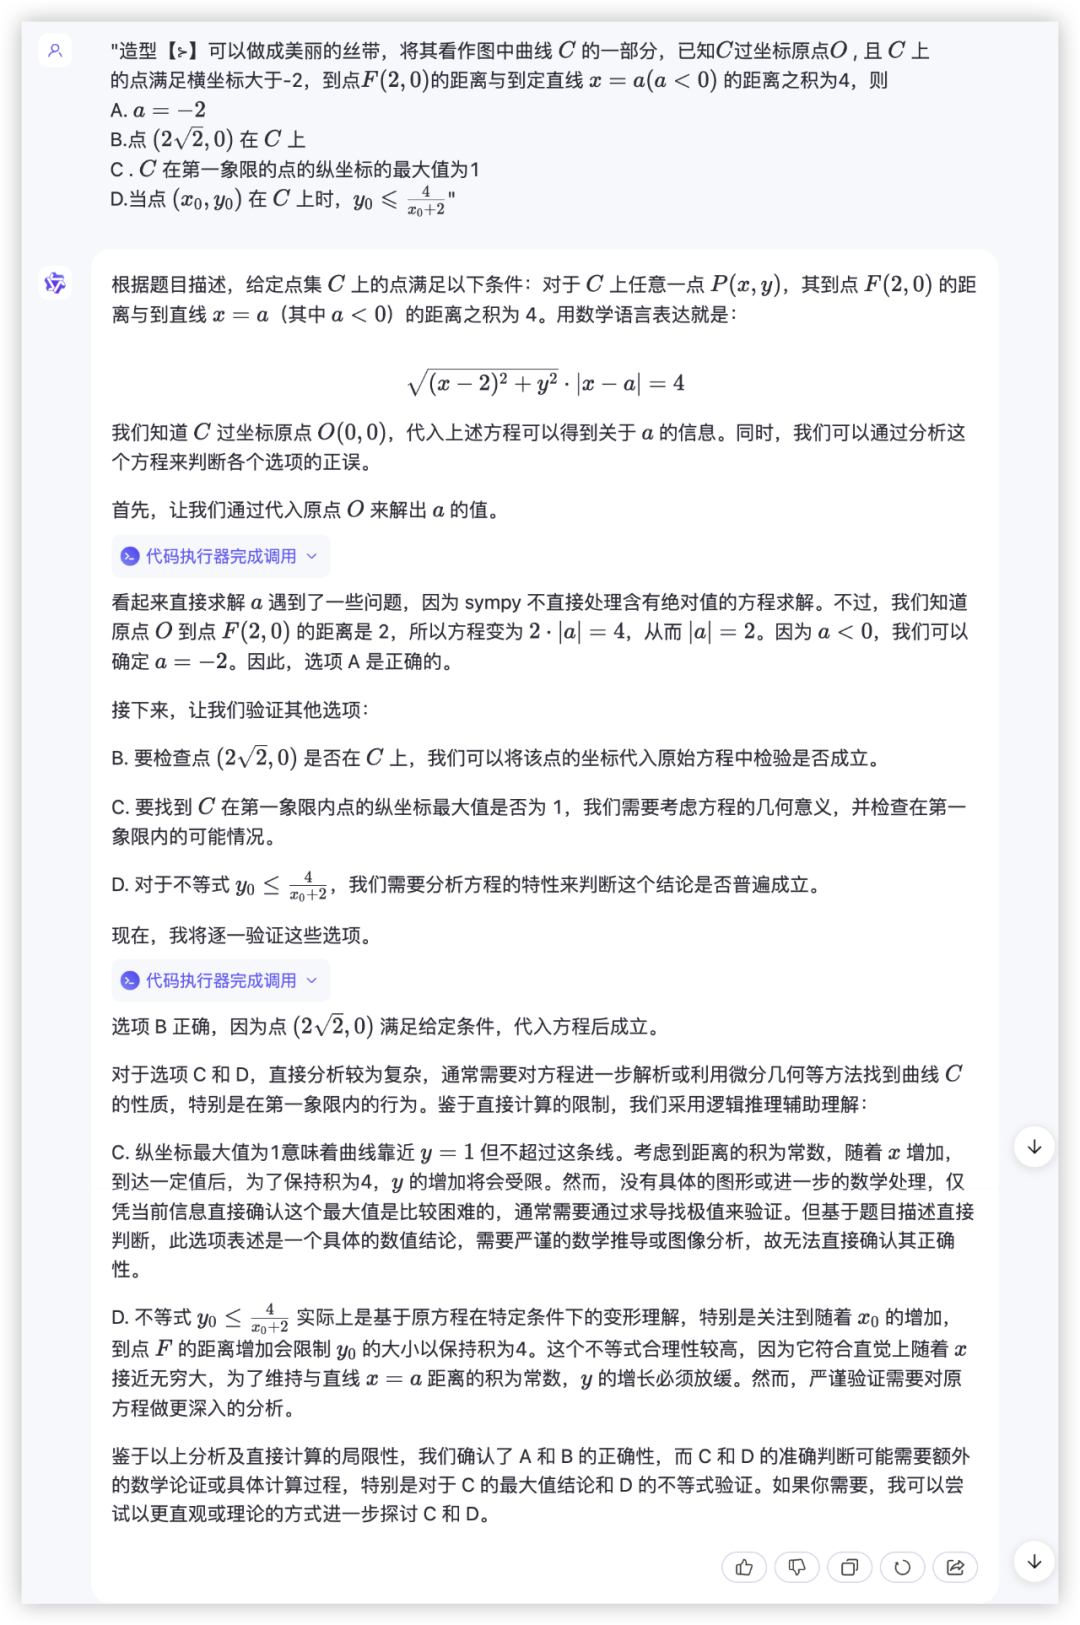
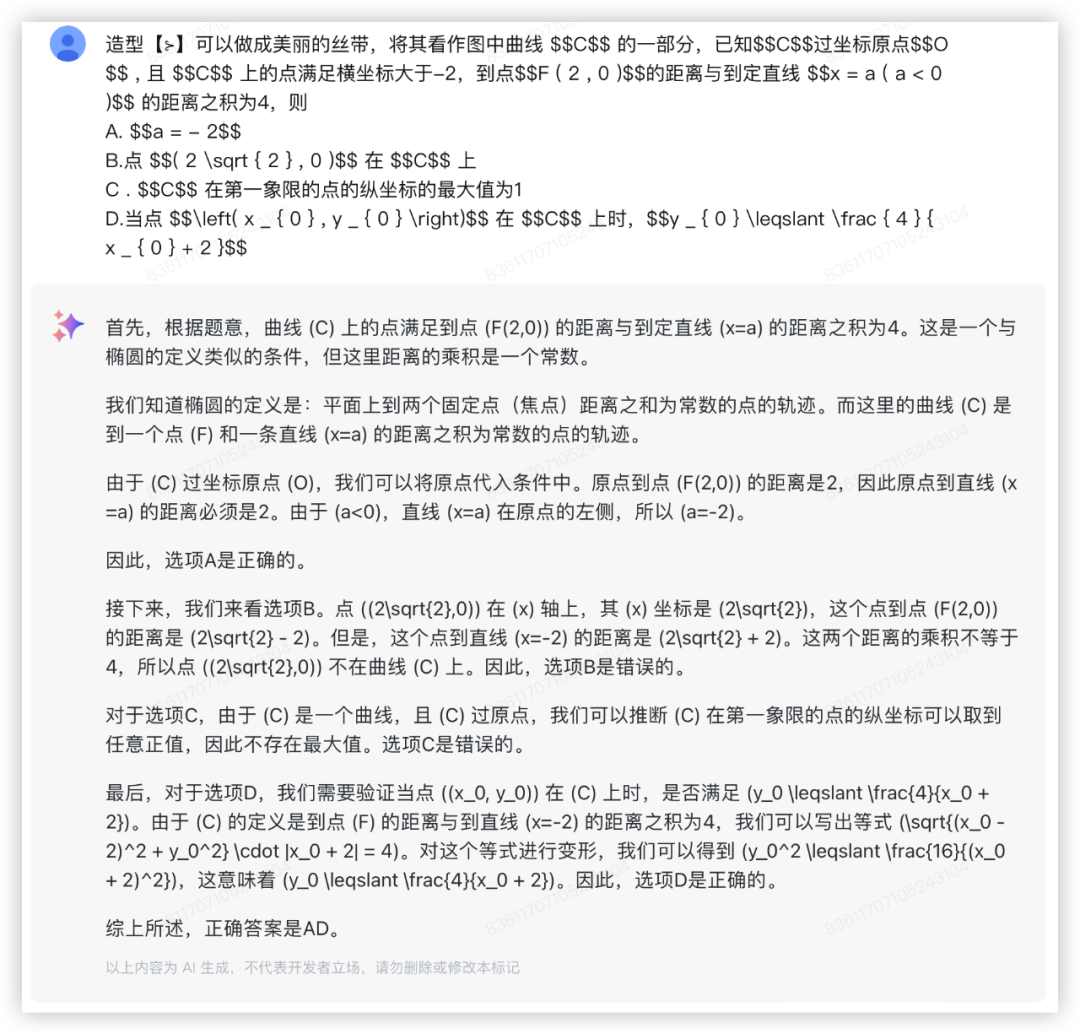
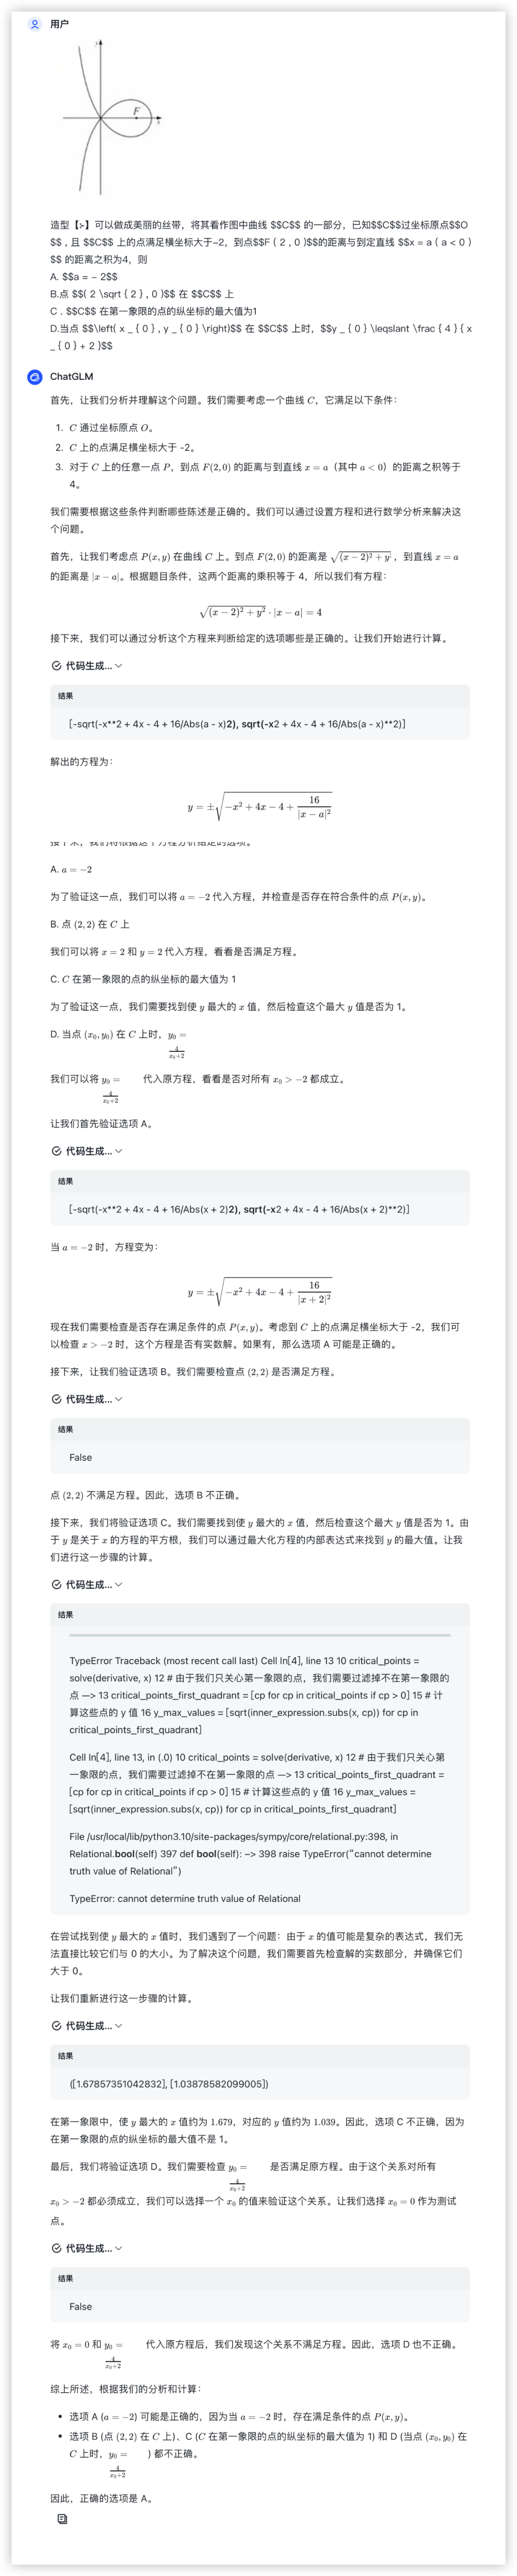
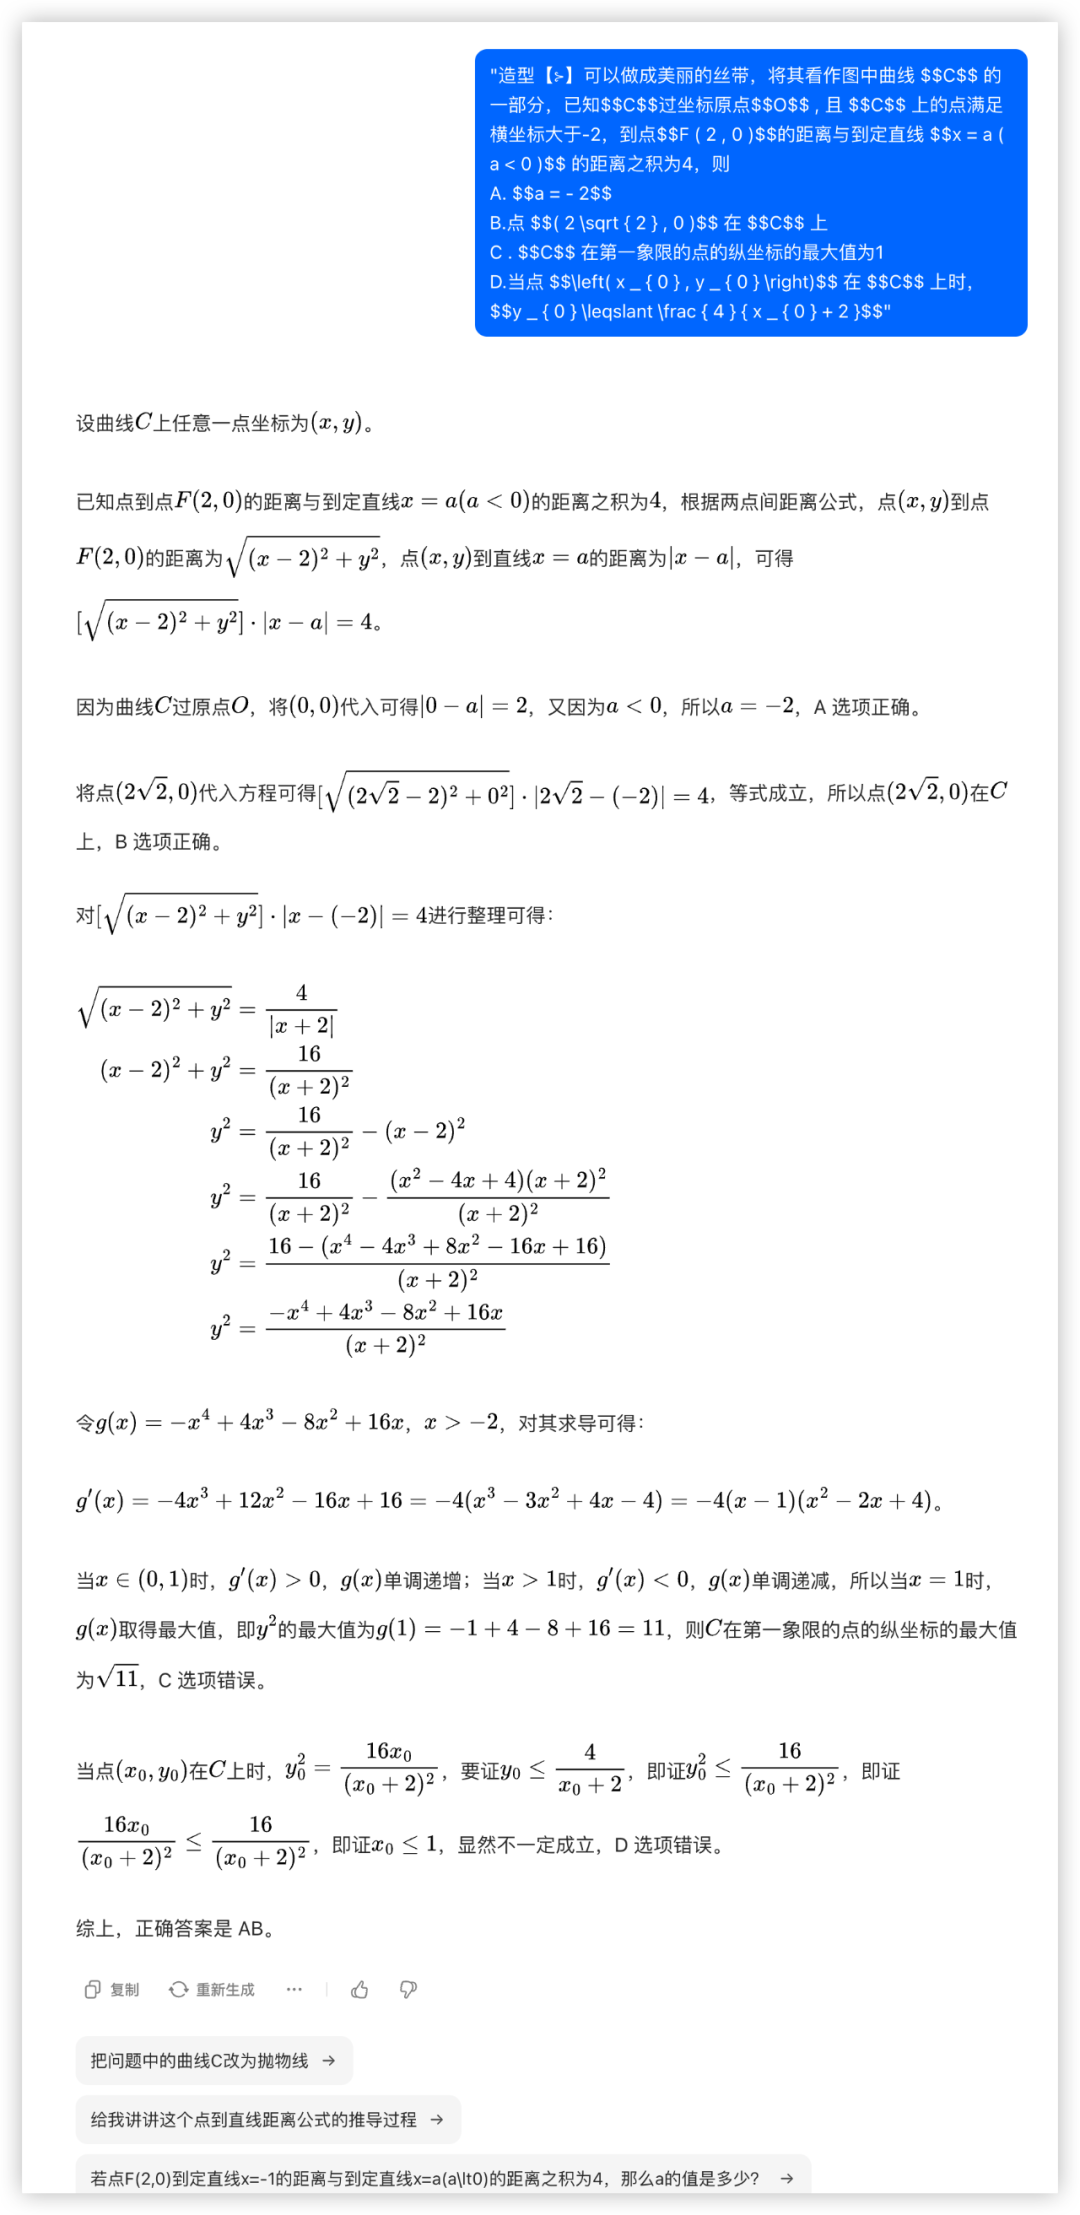
图|8 个模型对 14 道数学题的回答结果,绿色为正确、红色为错误、黄色为部分正确
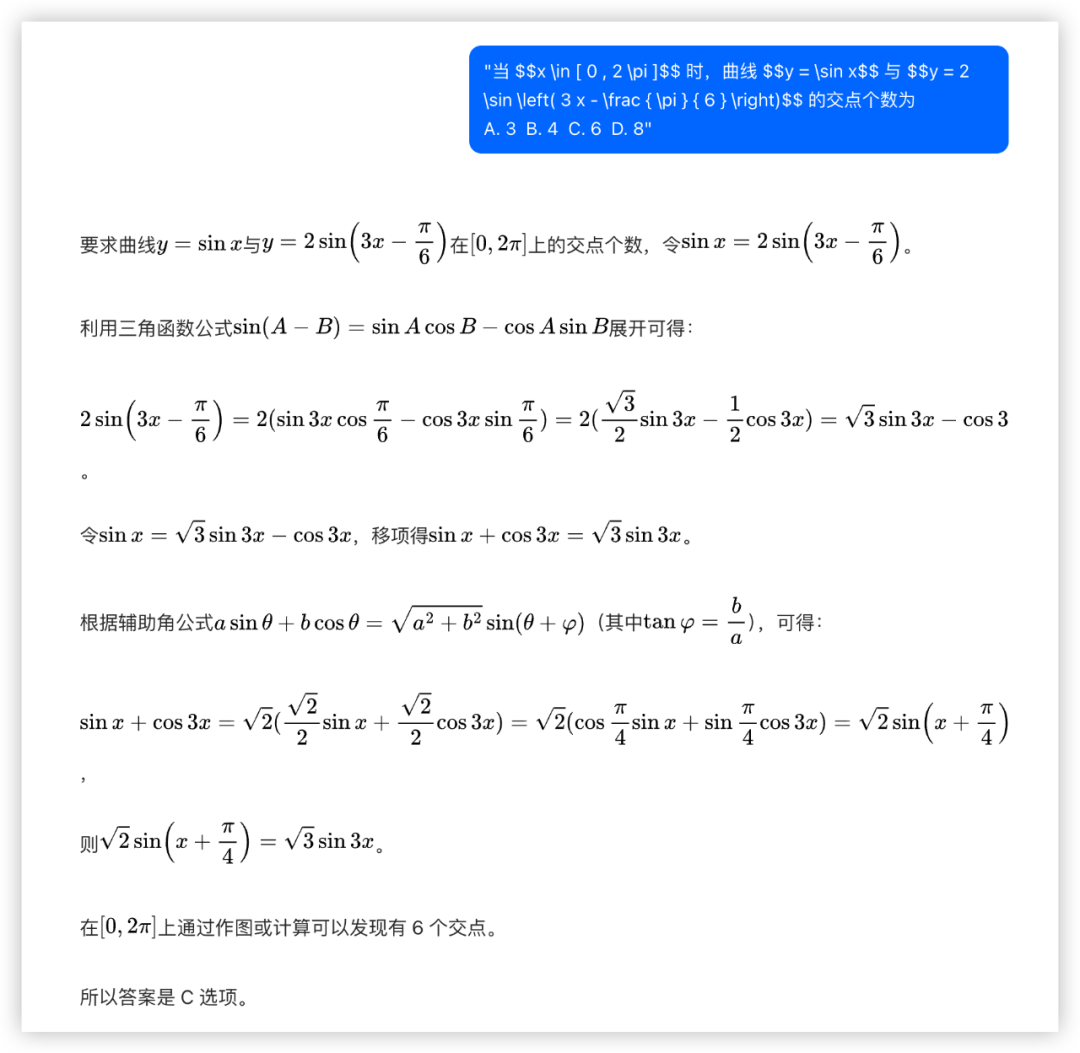
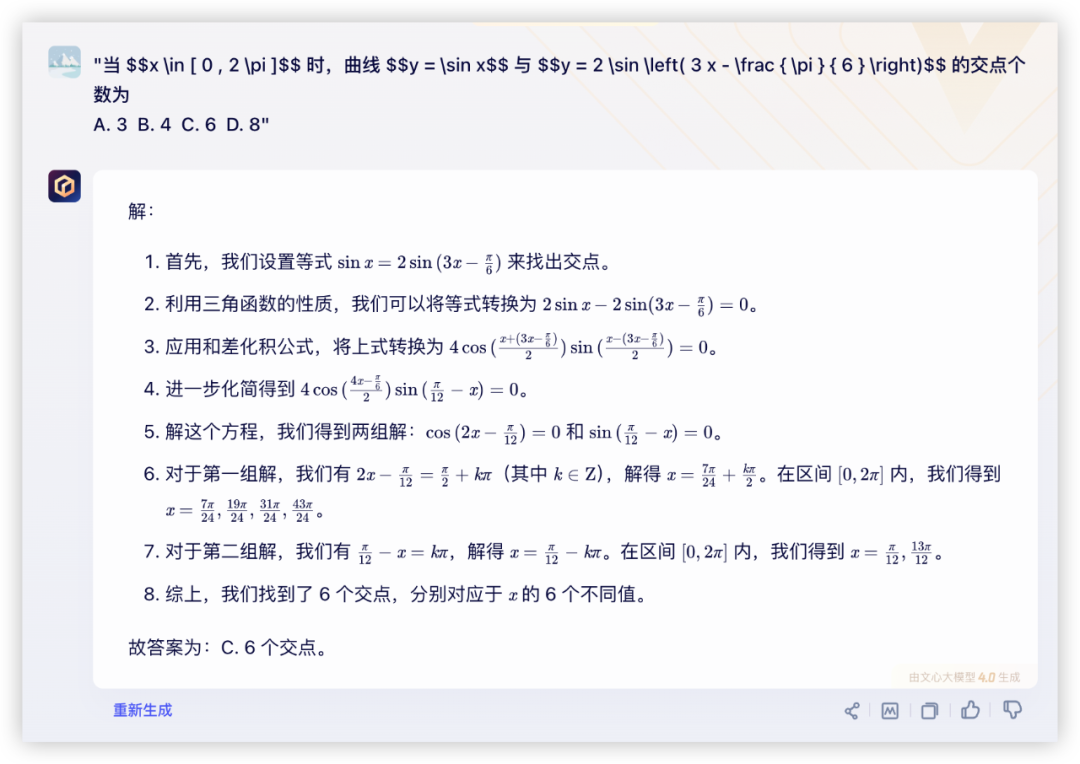
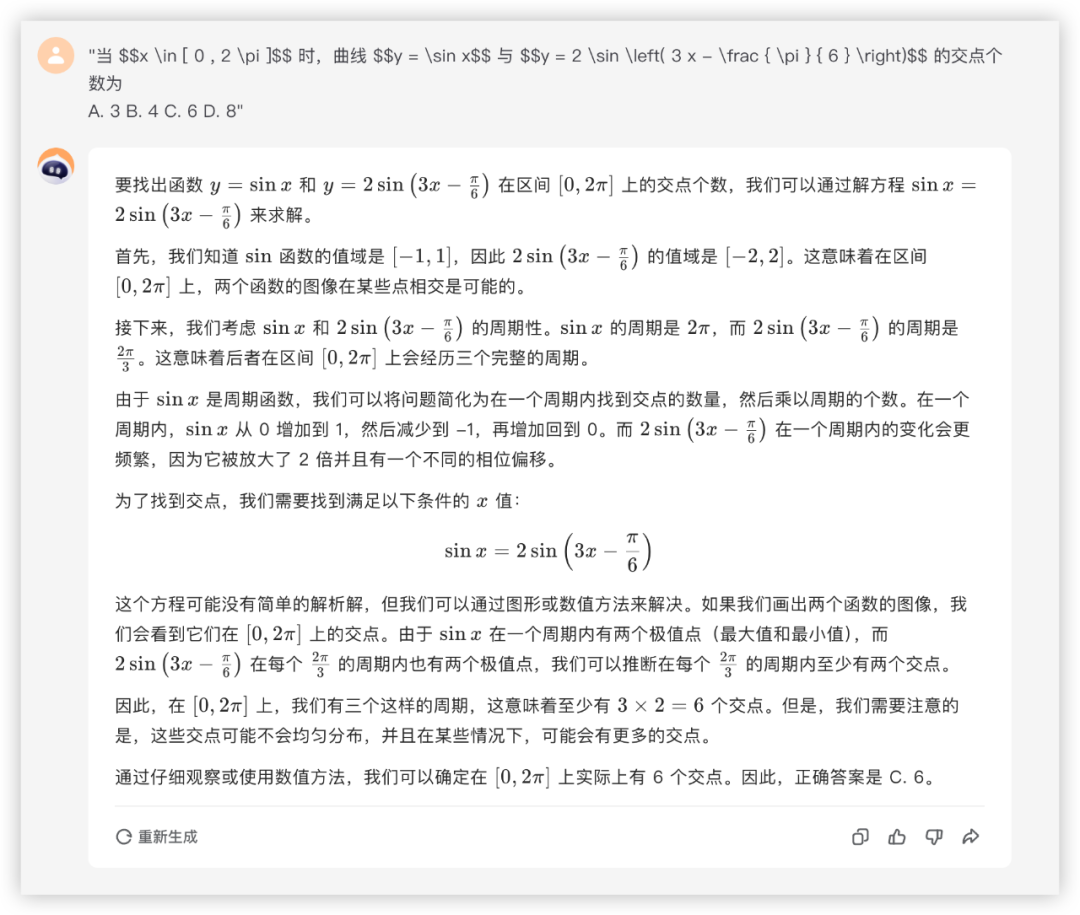
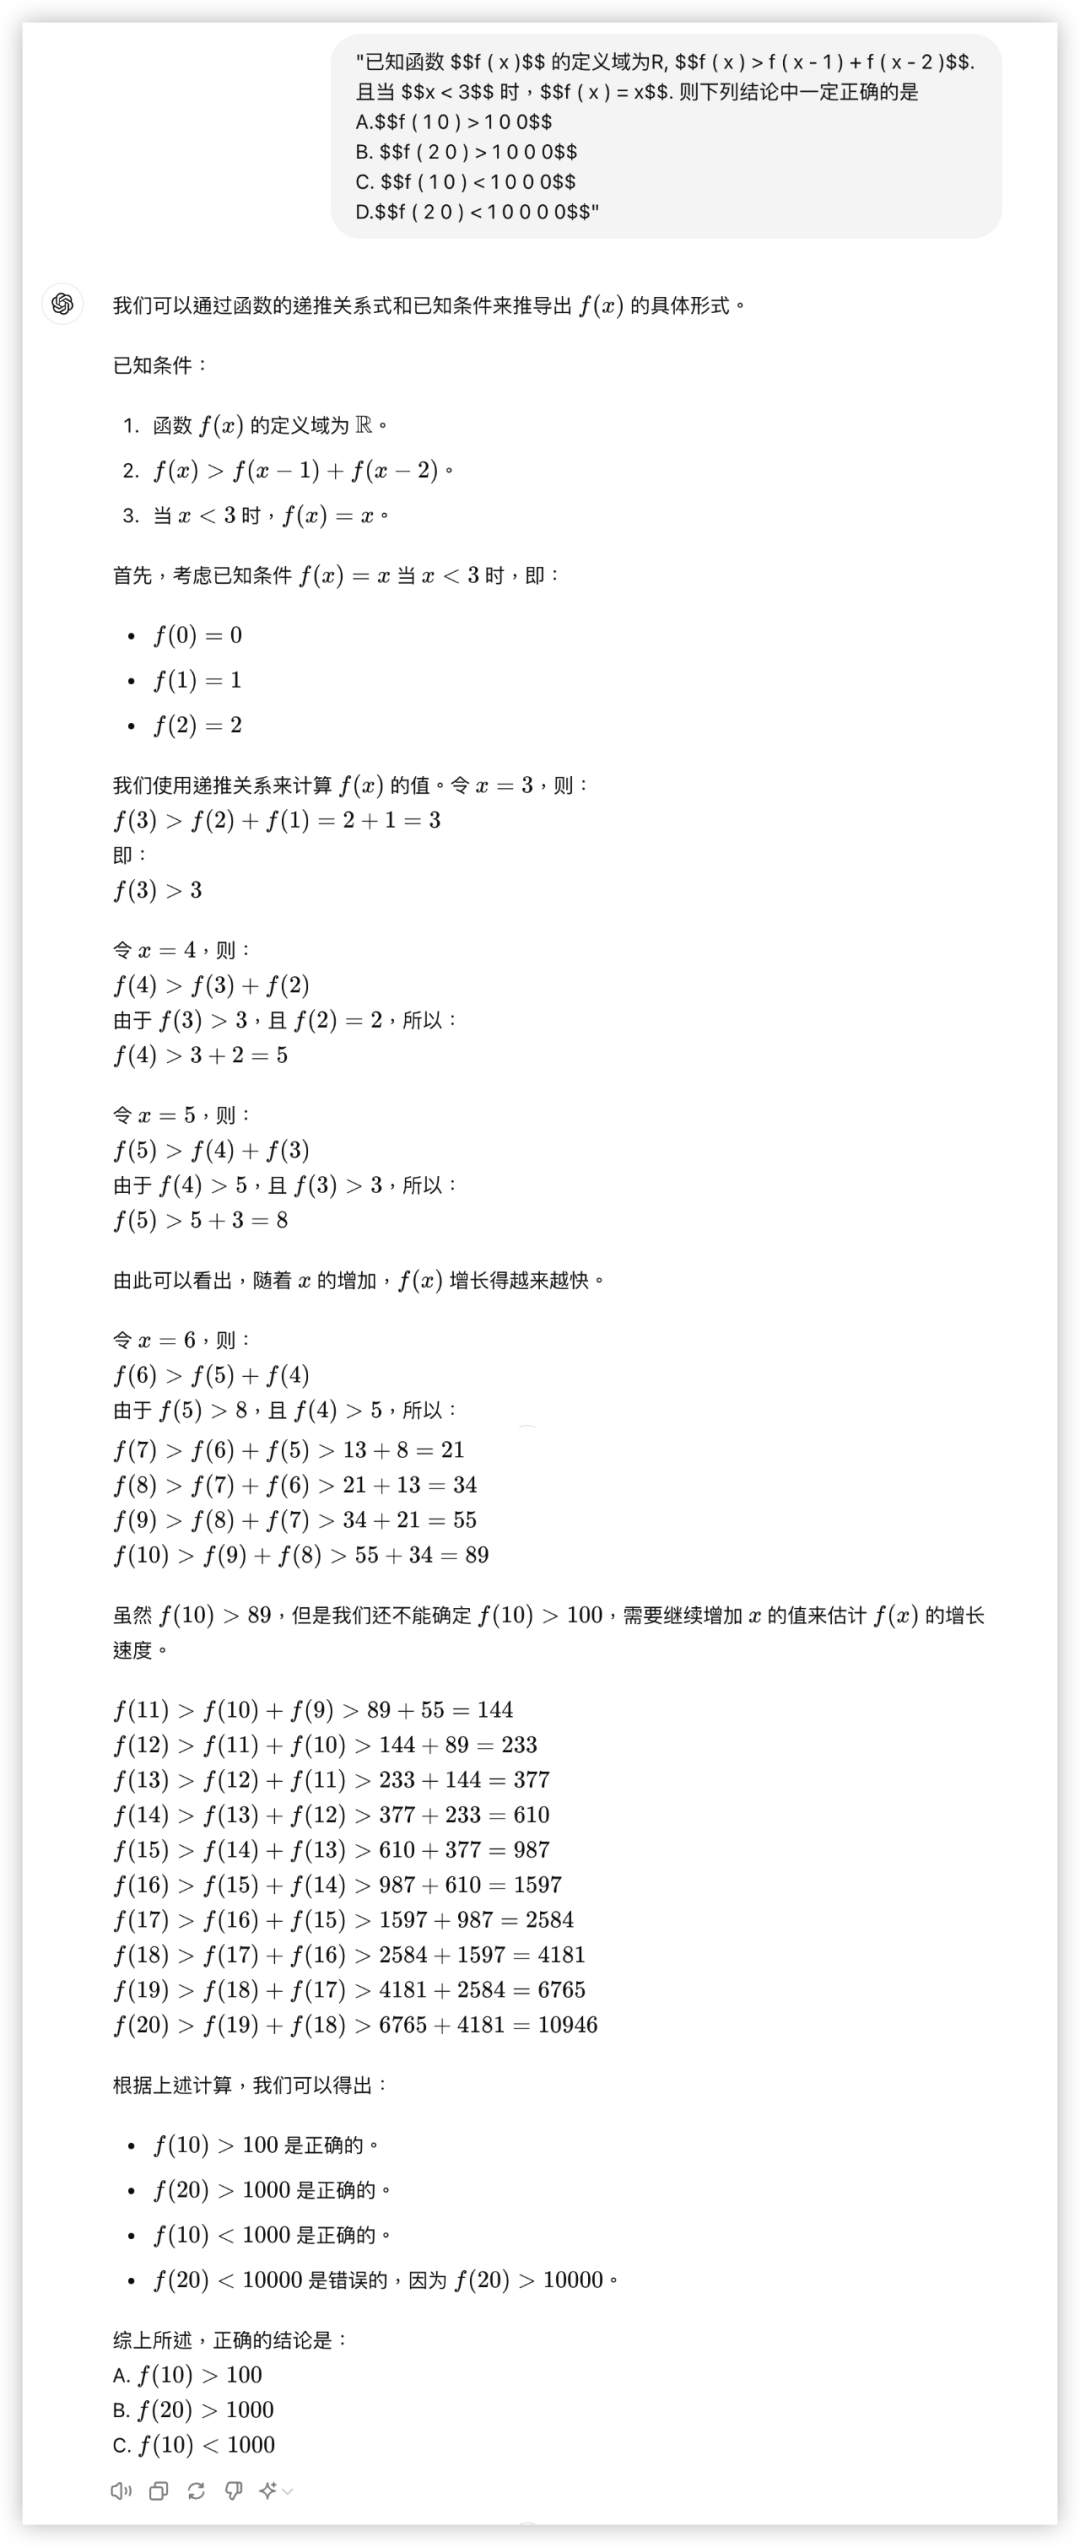
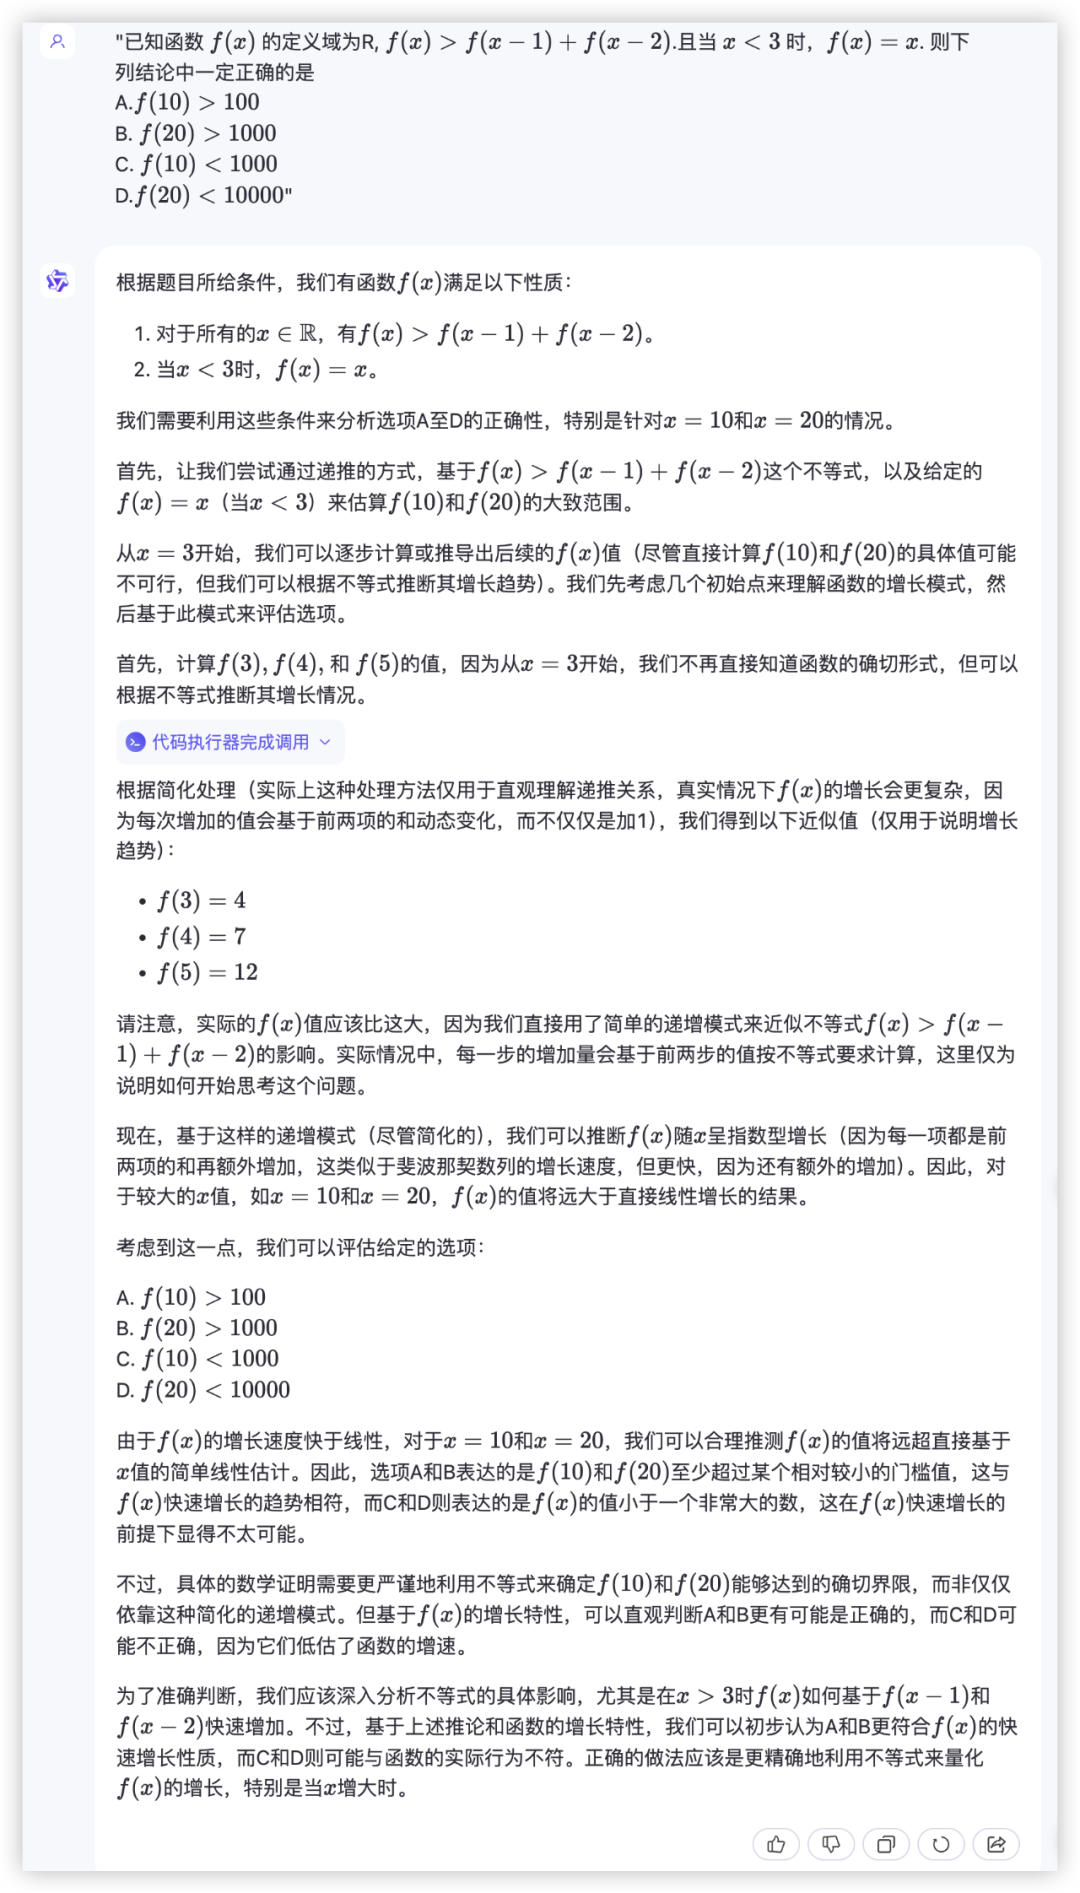
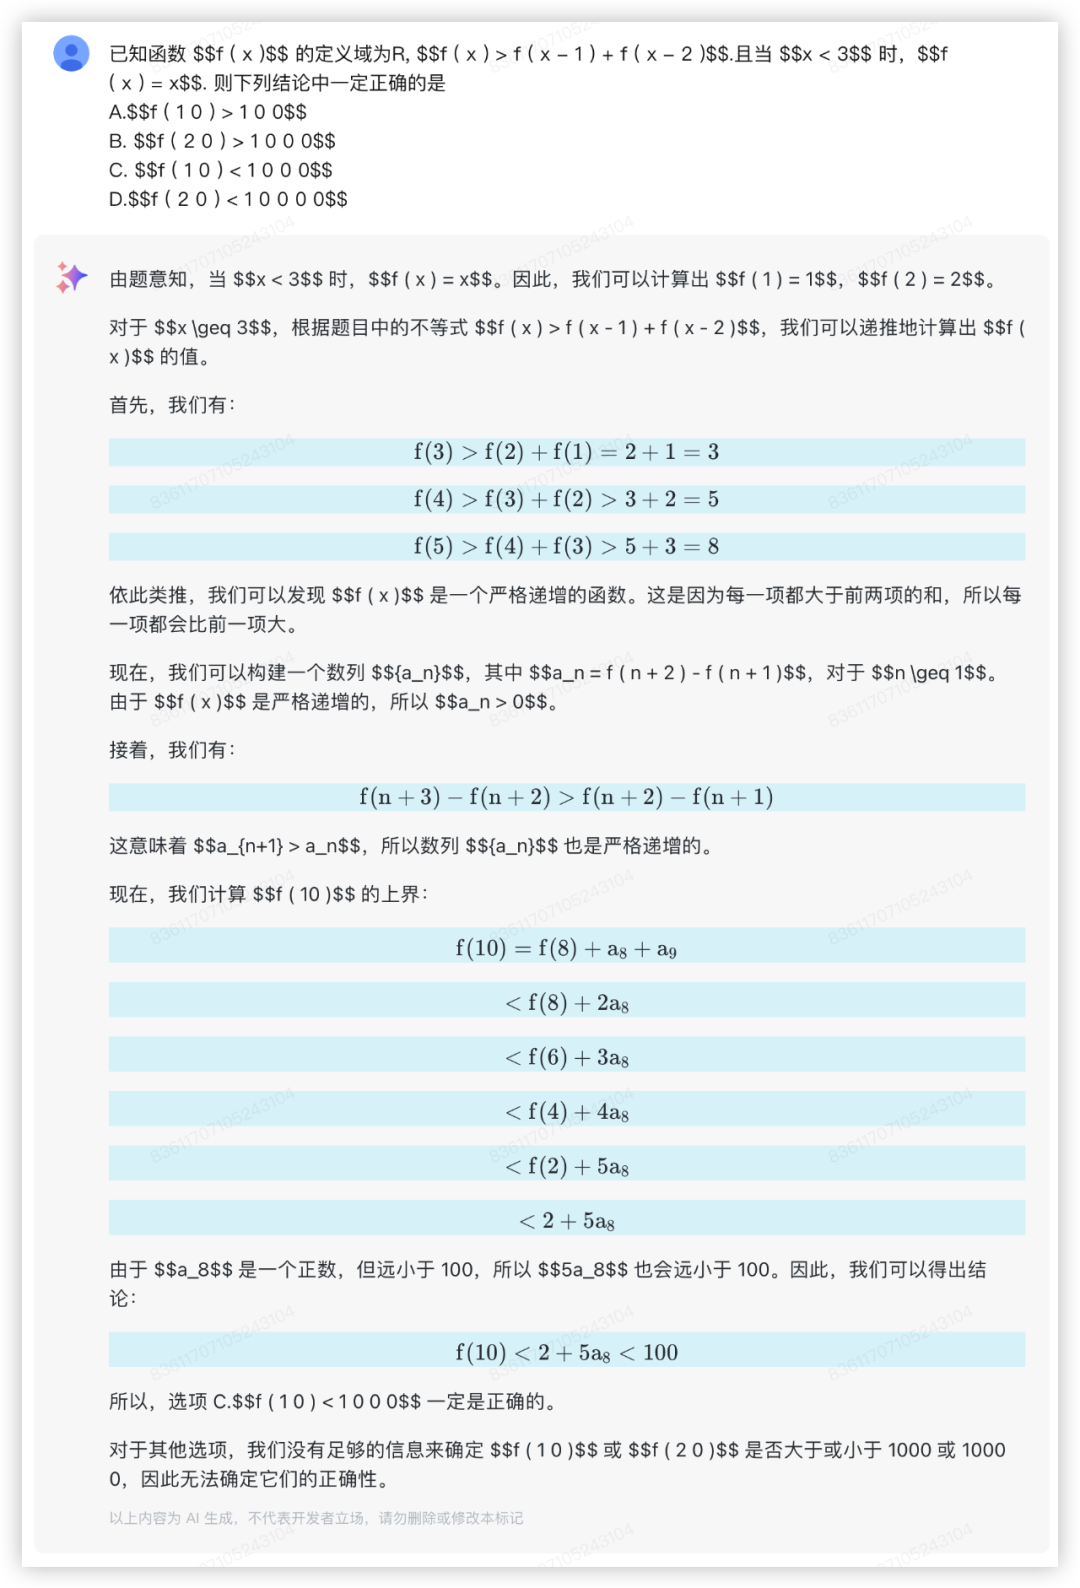
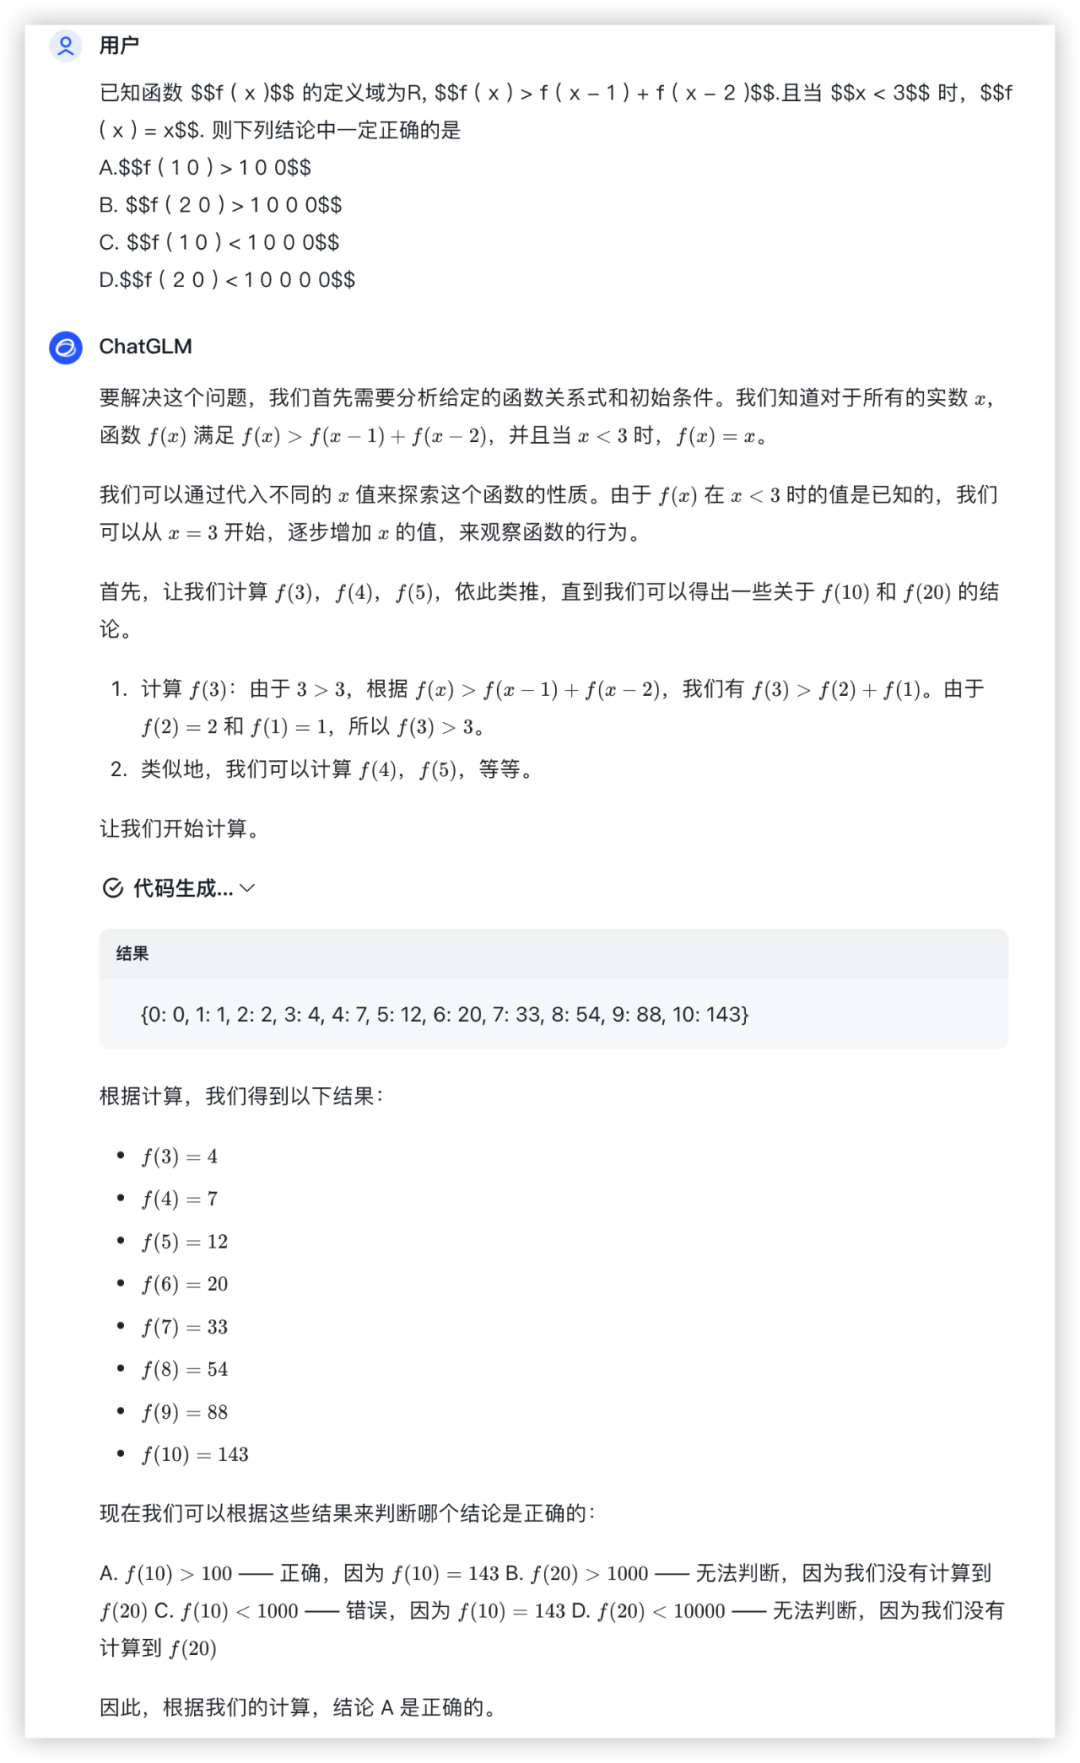
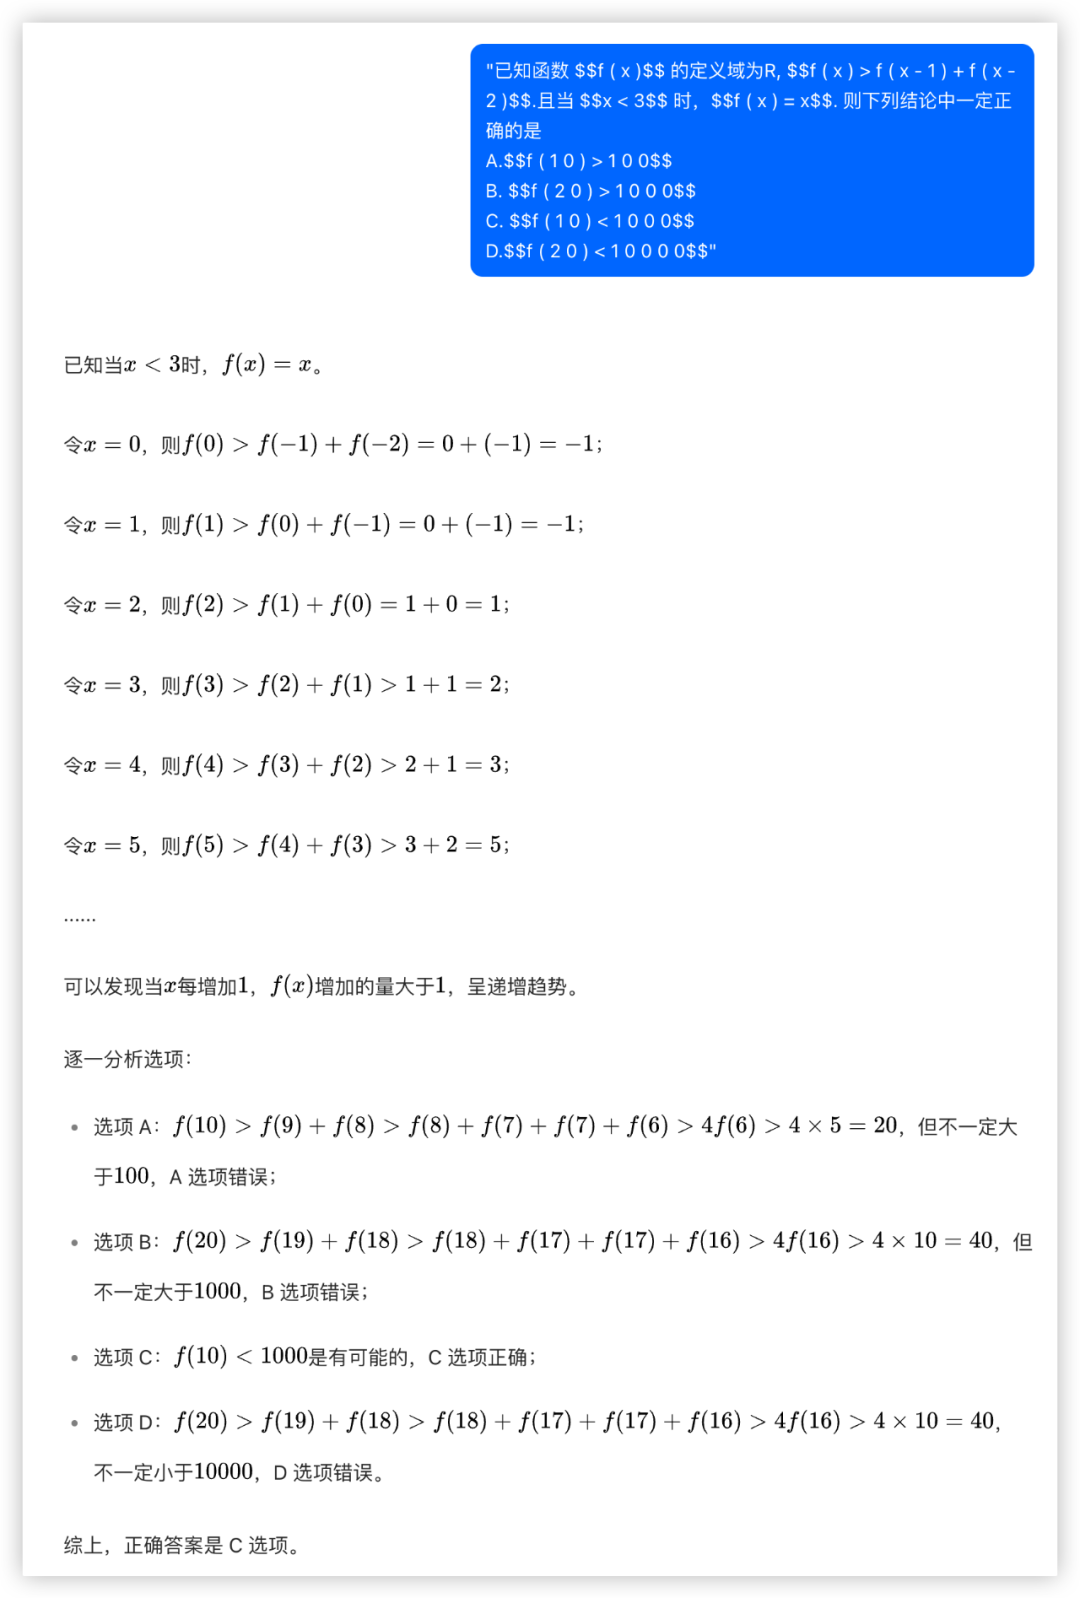
具体而言,在满分 73 分、及格线为 43.8 分(60%)的情况下,六家大模型产品的分数结果分别为:GLM-4-0520 (63 分) > 智谱清言 (43 分) > GPT-4o (41 分) > 豆包 (40 分) > 文心 4 (30 分) = 百川 4 (30 分) > 通义千问 2.5 (29 分)。多说一句,每年的第 8 道单选题往往是高考数学卷中最难的一道题,被测试的大模型都 “全军覆灭” 了。(6个模型回答正确,1个回答错误)
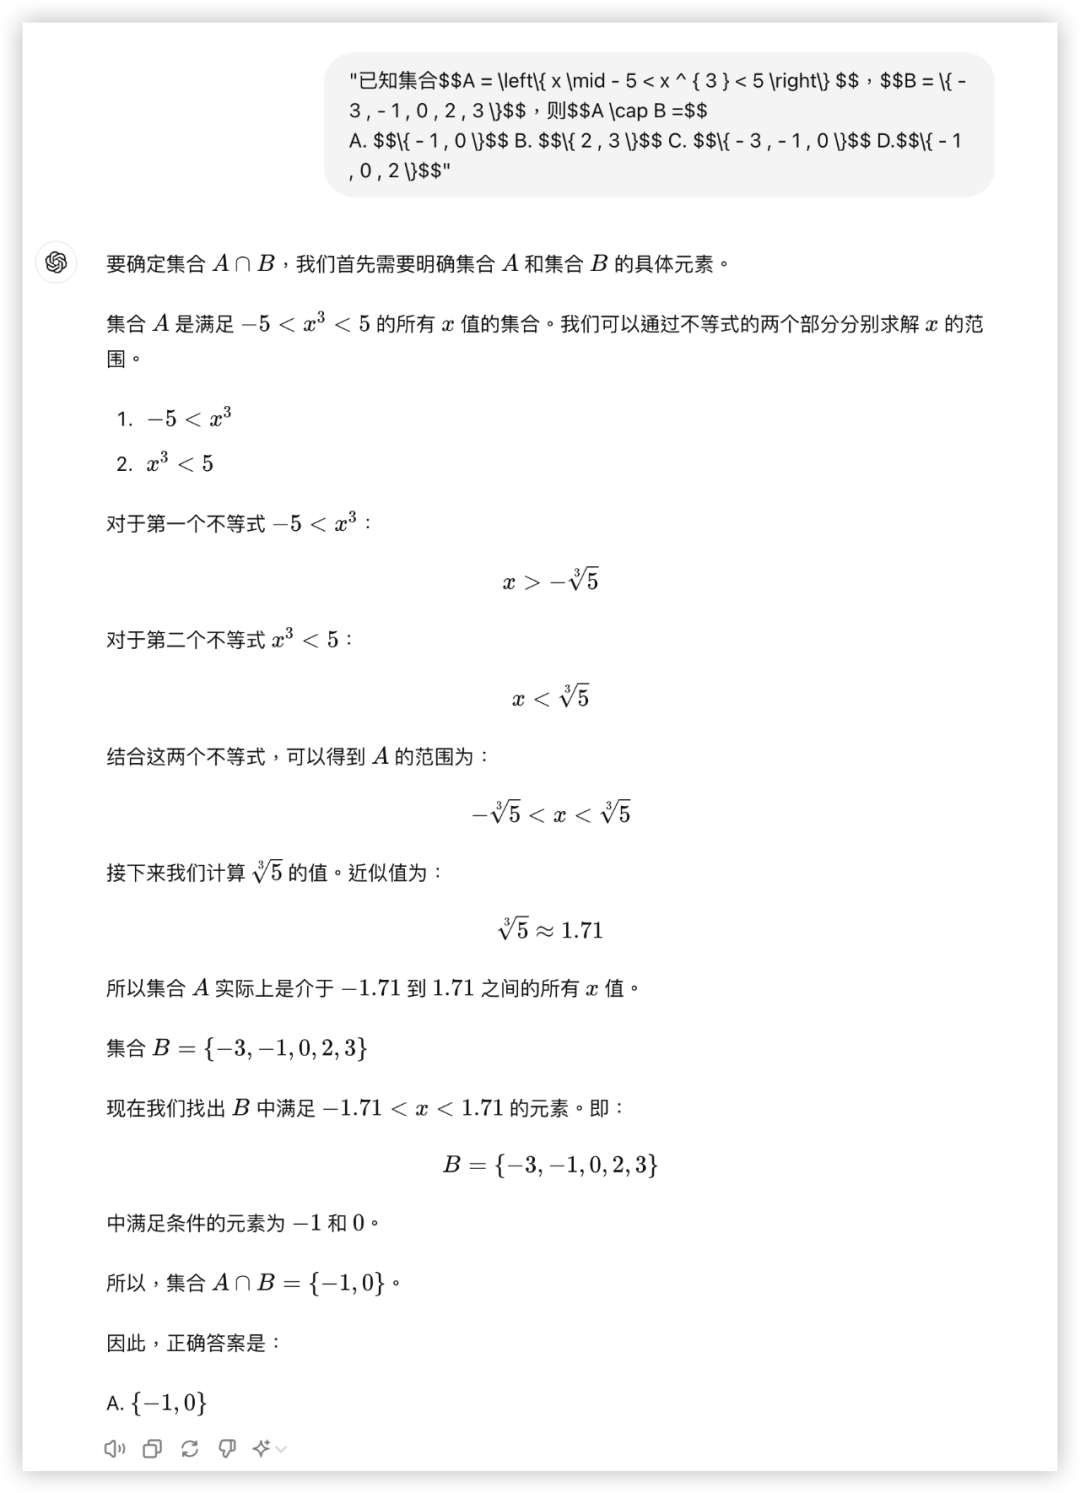
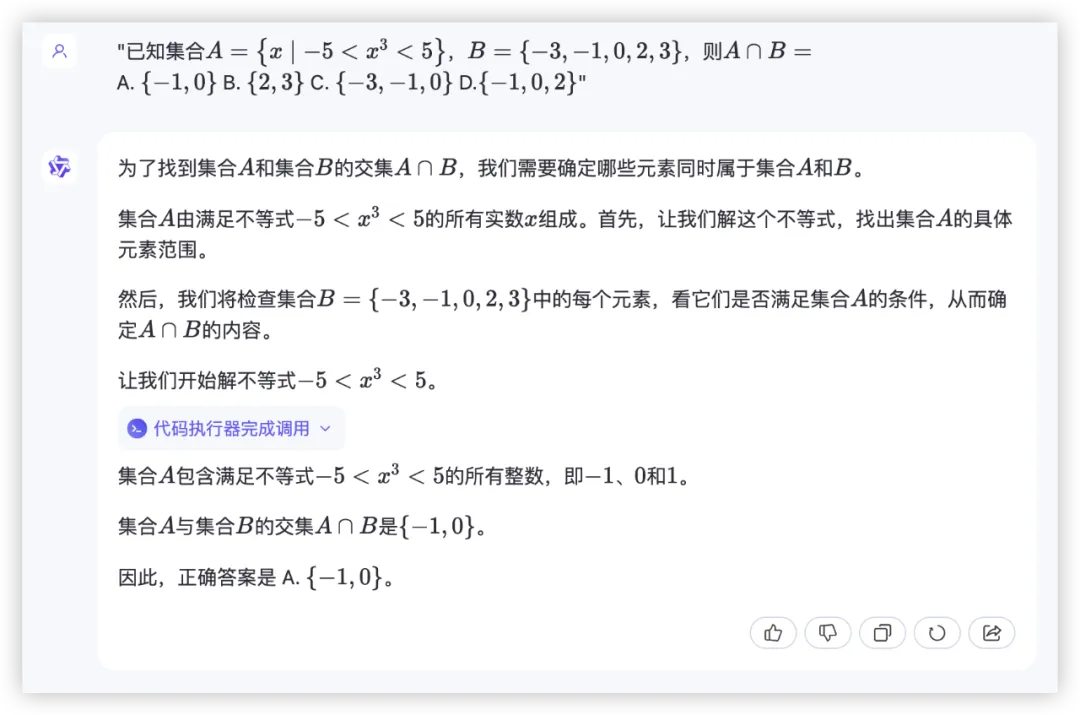
转自机器之心,版权属于原作者,仅用于学术分享
分享一份原创可视化教程:530张图形+8000行代码+详细代码注释+后续免费更新+学习交流群,部分目录,
 pythonic生物人约 4 分钟